Projeto lógico: do modelo ER ao modelo relacional
Como transformar um modelo entidade-relacionamento em um modelo relacional: implementação de entidades, relacionamentos identificadores, relacionamentos 1x1, 1xN e NxN (fusão de tabelas, tabela própria e adição de colunas) e hierarquias de generalização/especialização.
1. Visão geral
Um modelo entidade-relacionamento pode ser implementado de diferentes formas. Podemos optar, por exemplo, por utilizar tabelas (relações) para fazer a sua implementação. Essa implementação é baseada no modelo relacional. Tal processo leva o nome de projeto lógico. Observe como partimos de um modelo de dados em nível conceitual para obter um modelo de dados que o implementa em nível lógico, ou seja, que revela detalhes de implementação.
Observe a figura a seguir. Ela mostra do que se tratam o projeto lógico e a engenharia reversa de um banco de dados relacional.
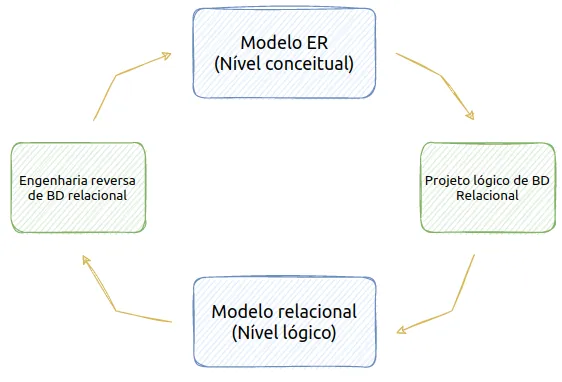
Figura 2.1: projeto lógico e engenharia reversa.
A seguir, veremos como os principais conceitos da modelagem ER podem ser implementados utilizando mecanismos do modelo relacional.
O que você vai aprender
- Como implementar entidades como tabelas
- Como implementar entidades com relacionamentos identificadores
- As três formas de implementar relacionamentos: fusão de tabelas, tabela própria e adição de colunas
- Qual forma é preferida para cada tipo de relacionamento (1x1, 1xN e NxN) e por quê
- Duas formas de implementar hierarquias de generalização/especialização
O que você vai precisar
- Conhecer a abordagem entidade-relacionamento e o modelo relacional (chaves primárias e estrangeiras)
2. Implementação de entidade
Uma entidade simples pode ser implementada:
- por uma única tabela
- cada atributo pode ser implementado como uma coluna da tabela
- a coluna que implementa o atributo identificador é a chave primária da tabela
- os nomes das colunas são escolhidos de maneira técnica, considerando nomes que poderão ser usados na implementação de fato
Veja a figura a seguir.
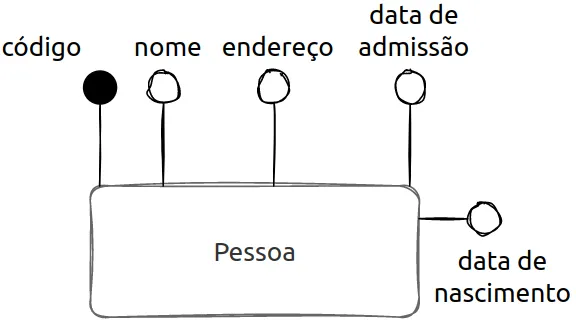
Figura 2.1.1: a entidade Pessoa.
A sua implementação no modelo relacional fica assim:
Pessoa (cod_pessoa, nome, endereco, data_nasc, data_adm)
3. Relacionamento identificador
Há algumas observações a serem consideradas quando da implementação de uma entidade que envolve um ou mais relacionamentos identificadores. Veja um exemplo na figura a seguir.
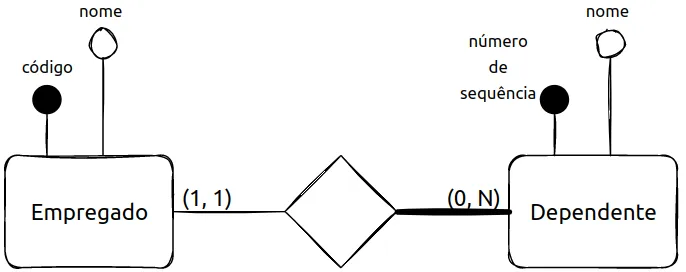
Figura 2.2.1: Dependente é identificado pelo número de sequência e pelo Empregado.
Veja a implementação de ambas as entidades.
Empregado (cod_empregado, nome)
Dependente (num_seq, cod_empregado, nome)
cod_empregado referencia Empregado
As regras para esse tipo de implementação são:
- Para cada relacionamento identificador, é criada uma chave estrangeira na tabela que implementa a entidade identificada pelo relacionamento. Esta chave estrangeira é composta pelas colunas da chave primária da tabela referenciada.
- A chave primária da tabela que implementa a entidade identificada pelo relacionamento identificador é composta por:
- colunas correspondentes aos atributos identificadores da entidade
- chaves estrangeiras que implementam os relacionamentos identificadores
Veja mais um exemplo na figura a seguir.
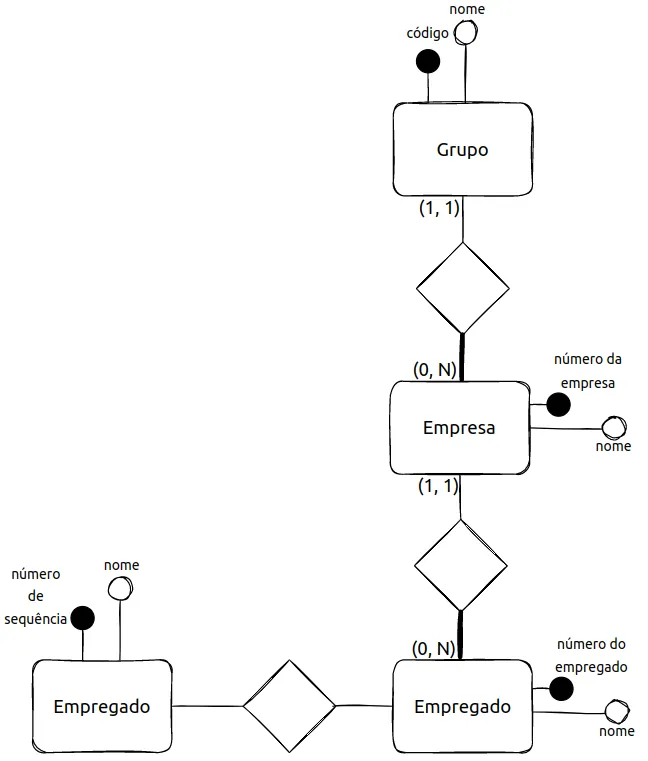
Figura 2.2.2: relacionamentos identificadores em cadeia.
Veja a sua implementação:
Grupo (cod_grupo, nome)
Empresa (cod_grupo, num_empresa, nome)
cod_grupo referencia Grupo
Empregado (cod_grupo, num_empresa, num_empregado, nome)
cod_grupo, num_empresa referencia Empresa
Dependente (cod_grupo, num_empresa, num_empregado, num_sequencia, nome)
cod_grupo, num_empresa, num_empregado referencia Empregado
4. Três formas de implementar relacionamentos
Há três formas principais para a implementação de um relacionamento:
- fusão de tabelas
- tabela própria
- adição de coluna
Vejamos exemplos de cada uma antes de estudarmos aspectos que podem tornar uma opção mais interessante do que outra.
Tabela própria
Considere o DER da figura a seguir. Observe como a implementação sugerida foi feita utilizando-se uma tabela própria para o relacionamento.
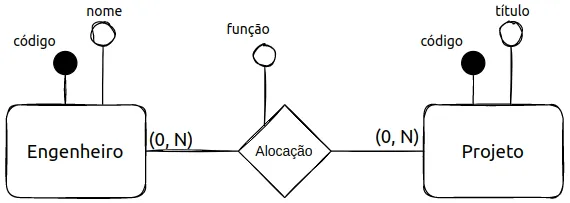
Figura 2.3.1: relacionamento NxN Alocação.
Implementação utilizando uma tabela própria para o relacionamento:
Engenheiro (cod_engenheiro, nome)
Projeto (cod_projeto, titulo)
Alocacao (cod_engenheiro, cod_projeto, funcao)
cod_engenheiro referencia Engenheiro
cod_projeto referencia Projeto
Adição de colunas
A implementação de relacionamento por adição de colunas requer que pelo menos uma cardinalidade máxima do relacionamento seja 1. Ou seja, relacionamentos NxN somente podem ser implementados com tabelas próprias. Quando uma das cardinalidades máximas é 1, a implementação consiste em inserir, na tabela correspondente à entidade com cardinalidade máxima 1, as seguintes colunas:
- colunas correspondentes ao identificador da entidade relacionada. Elas formam uma chave estrangeira em relação à tabela que implementa a entidade relacionada
- colunas correspondentes aos atributos do relacionamento
Veja a figura a seguir.
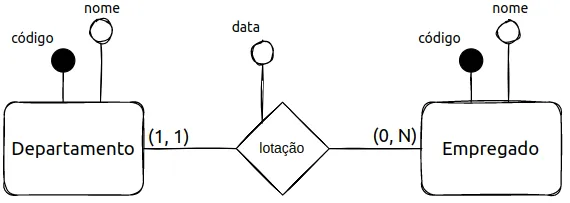
Figura 2.3.2: relacionamento 1xN lotação.
Veja a sua implementação por meio da adição de colunas:
Departamento (cod_departamento, nome)
Empregado (cod_empregado, nome, cod_departamento, data)
cod_departamento referencia Departamento
Fusão de tabelas de entidades
Esta técnica somente pode ser usada para relacionamentos de cardinalidade 1x1. A implementação consiste em definir uma única tabela com colunas para todos os atributos de ambas as entidades e também do relacionamento, caso existam. Veja a figura a seguir.
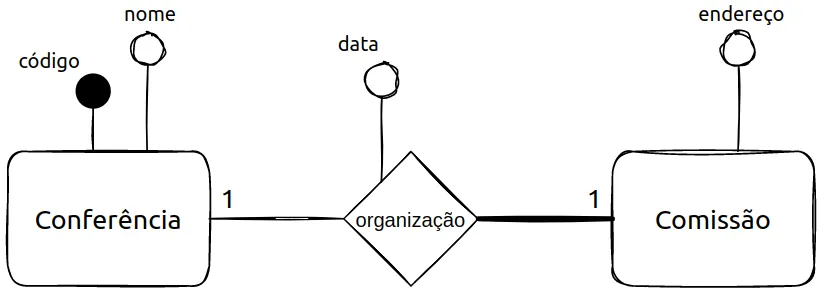
Figura 2.3.3: relacionamento 1x1 organização.
Veja uma possível implementação:
Conferencia (cod_conferencia, nome, data, endereco)
5. Relacionamentos 1x1
Ambas as entidades com participação opcional
A figura a seguir mostra um relacionamento desse tipo.
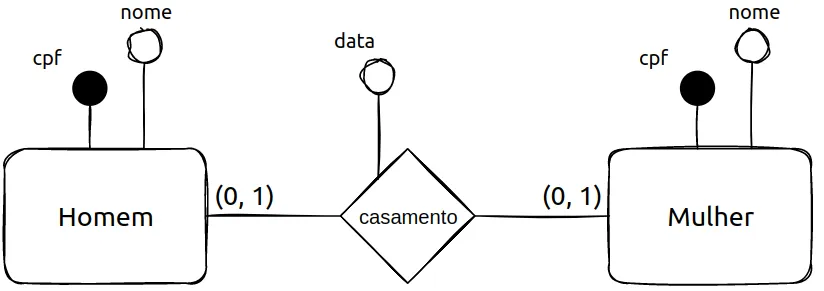
Figura 2.3.4: relacionamento 1x1 com participação opcional dos dois lados.
A implementação preferida para esse tipo de relacionamento é feita por meio da adição de colunas, que pode ser feita em qualquer uma das tabelas. Veja:
Mulher (cpf_mulher, cpf_homem, nome_mulher, data)
cpf_homem referencia Homem
Homem (cpf_homem, nome)
Neste exemplo, a tabela Mulher foi escolhida arbitrariamente para conter a coluna de implementação do relacionamento. Nada impede que a tabela Homem seja utilizada.
Também é possível implementar relacionamentos 1x1 em que ambas as entidades têm participação opcional usando uma tabela própria. Veja:
Mulher (cpf_mulher, nome)
Homem (cpf_homem, nome)
Casamento (cpf_mulher, cpf_homem, data)
cpf_mulher referencia Mulher
cpf_homem referencia Homem
Aspectos a se considerar são os seguintes:
- A implementação por tabela própria custa mais caro computacionalmente, por demandar mais operações de junção na recuperação de dados.
- A implementação por adição de coluna implica em um número potencialmente alto de campos vazios, o que é indesejável.
Observe que a alternativa por fusão de tabelas, neste caso, não pode ser usada. Isso acontece pelo fato de ambos os CPFs, de homem e mulher, serem opcionais. Veja que não temos nenhuma chave candidata.
Apenas uma entidade com participação opcional
Veja um exemplo deste caso na figura a seguir.
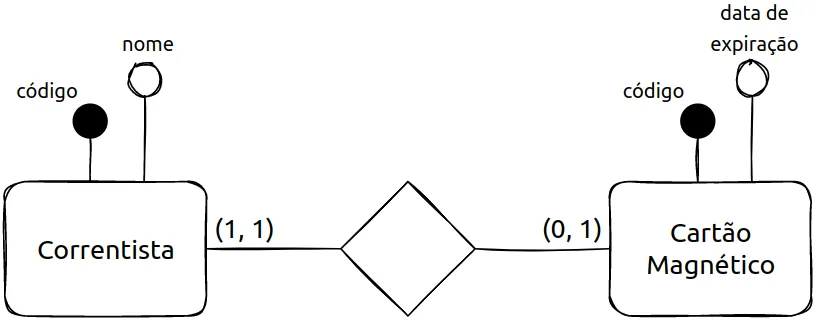
Figura 2.3.5: relacionamento 1x1 em que apenas uma entidade tem participação opcional.
Neste caso, a alternativa preferida é a fusão de tabelas. Veja como fica:
Correntista (cod_correntista, nome, cod_cartao, data_expiracao)
Também é possível fazer a implementação por meio da adição de colunas. Veja.
Correntista (cod_correntista, nome)
Cartao (cod_cartao, data_expiracao, cod_correntista)
cod_correntista referencia Correntista
Veja algumas considerações:
- A implementação por fusão de tabelas minimiza o número de junções na recuperação de dados. Por outro lado, ela pode dar origem a linhas com muitos campos vazios.
- A implementação por adição de coluna requer uma junção para a recuperação de dados e pode reduzir o número de campos vazios.
- Implementar o relacionamento usando tabela própria custa ainda mais caro computacionalmente, considerando o número de junções necessárias para a recuperação de dados.
Ambas as entidades com participação obrigatória
Veja um exemplo deste caso na figura a seguir.
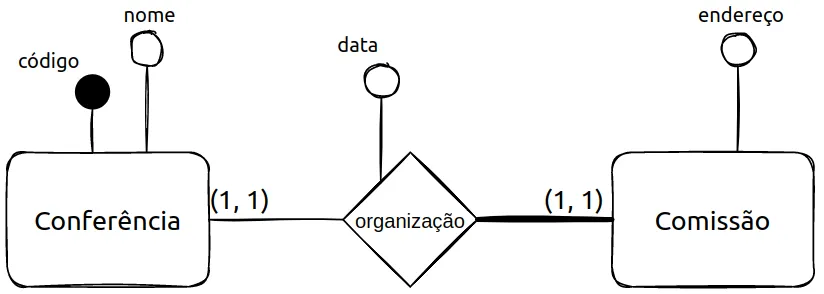
Figura 2.3.6: relacionamento 1x1 com participação obrigatória dos dois lados.
Neste caso, a opção preferida é a fusão de tabelas. Veja como fica:
Conferencia (cod_conferencia, nome, data, endereco)
Observe como as demais opções (adição de coluna e tabela própria) demandam um maior número de junções para a recuperação de dados e não trazem vantagem alguma. Como o relacionamento é obrigatório para ambas as entidades, há uma relação de um para um entre as linhas de cada tabela.
6. Relacionamentos 1xN e NxN
Relacionamentos 1xN
Para esse tipo de relacionamento, a opção preferida é a adição de colunas. Veja um exemplo de relacionamento 1xN na figura a seguir.
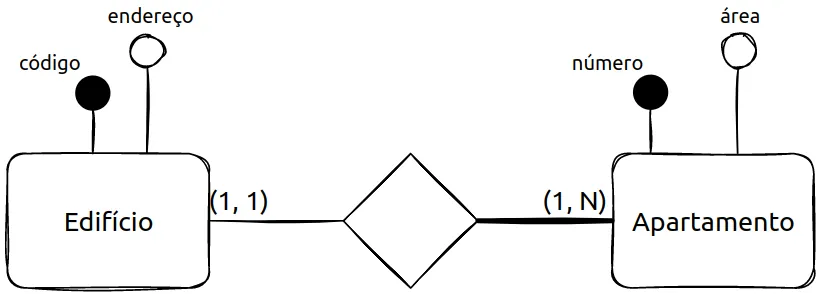
Figura 2.3.7: relacionamento 1xN entre Edifício e Apartamento.
Veja sua implementação usando adição de colunas:
Edificio (cod_edificio, endereco)
Apartamento (cod_edificio, num_apartamento, area)
cod_edificio referencia Edificio
Quando um relacionamento 1xN tem uma entidade cuja participação é opcional, pode-se considerar a implementação utilizando-se uma tabela própria. Veja um exemplo na figura a seguir.
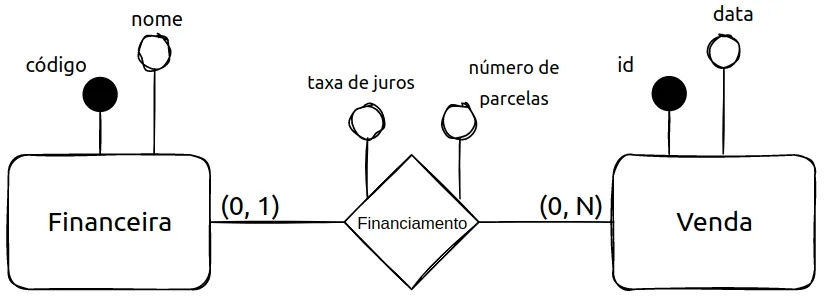
Figura 2.3.8: relacionamento 1xN com participação opcional.
Veja a sua implementação por adição de colunas, que é a preferida também neste caso:
Financeira (cod_financeira, nome)
Venda (id_venda, cod_financeira, data, taxa_juros, num_parcelas)
cod_financeira referencia Financeira
A implementação por tabela própria fica assim:
Financeira (codigo_financeira, nome)
Venda (id_venda, data)
Financiamento (id_venda, codigo_financeira, numero_parcelas, taxa_juros)
id_venda referencia Venda
codigo_financeira referencia Financeira
A implementação por tabela própria tem duas desvantagens:
- Número de junções.
- As tabelas Venda e Financiamento possuem a mesma chave primária, sendo o conjunto de valores de Financiamento um subconjunto de Venda. Temos um problema de armazenamento e processamento duplicado de valores.
Relacionamentos NxN
Neste caso, a única opção é o uso de tabela própria para o relacionamento. A figura a seguir relembra o exemplo visto anteriormente.
Figura 2.3.9: relacionamento NxN Alocação.
E sua implementação:
Engenheiro (cod_engenheiro, nome)
Projeto (cod_projeto, titulo)
Alocacao (cod_engenheiro, cod_projeto, funcao)
cod_engenheiro referencia Engenheiro
cod_projeto referencia Projeto
7. Generalização/especialização
Há pelo menos duas opções de implementação para hierarquias de generalização/especialização. Vejamos.
Uma tabela por hierarquia
Nesta alternativa, todas as tabelas referentes às especializações de uma entidade genérica são fundidas em uma única tabela, composta por:
- chave primária correspondente ao identificador da entidade mais genérica
- caso não exista, uma coluna tipo que identifica que tipo de entidade está sendo representada em cada linha da tabela
- uma coluna para cada atributo da entidade genérica
- colunas referentes aos relacionamentos dos quais participa a entidade genérica e que sejam implementados por adição de coluna
- uma coluna para cada atributo de cada entidade especializada (opcionais)
Veja um exemplo na figura a seguir.
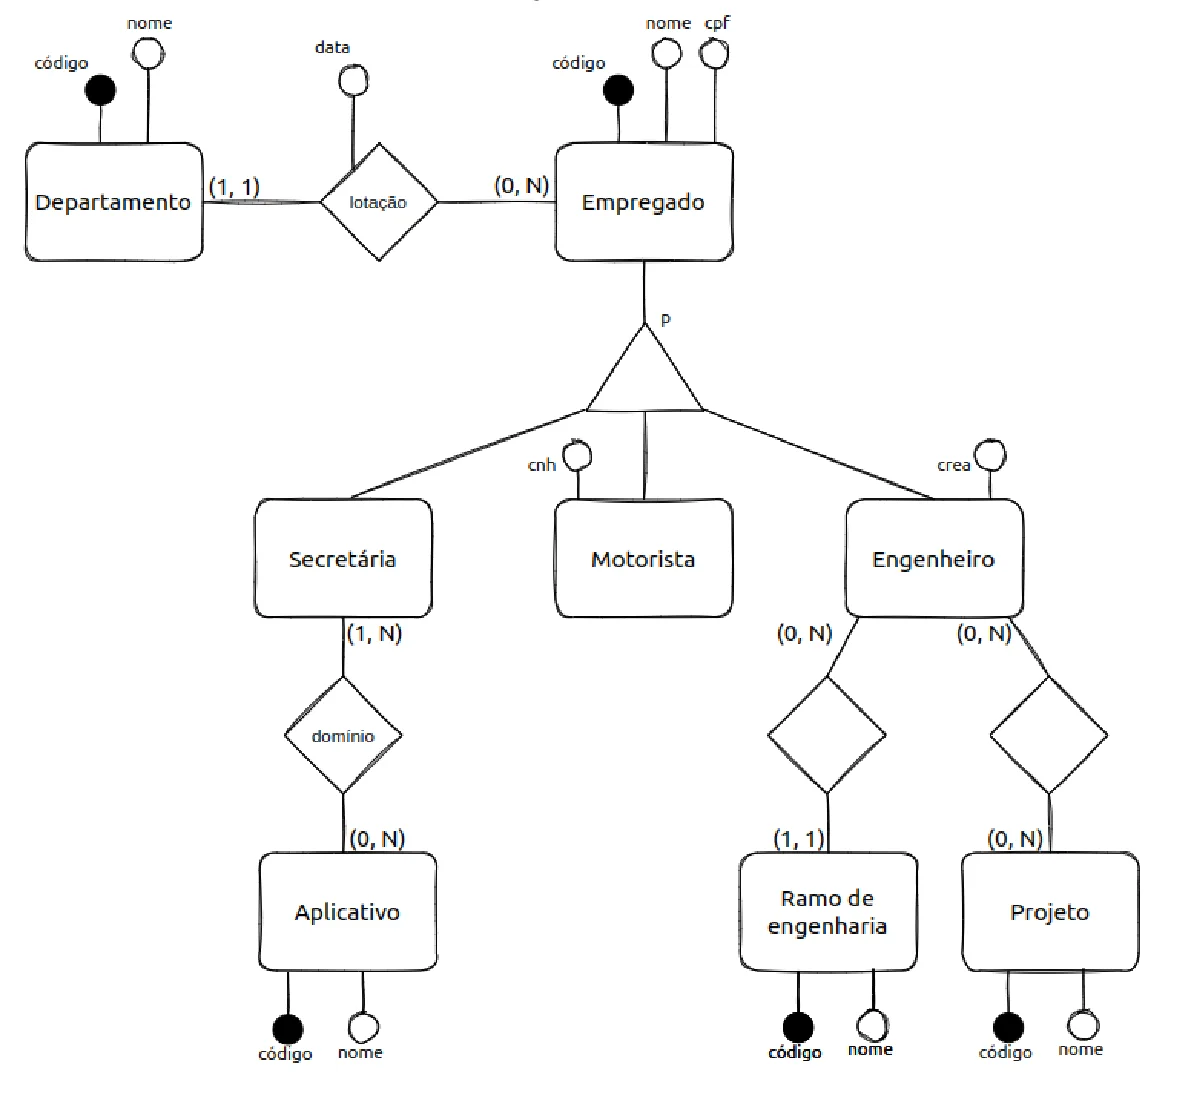
Figura 2.4.1: hierarquia de especialização de Empregado.
Veja a implementação usando uma única tabela para a hierarquia inteira:
Departamento (cod_departamento, nome)
Ramo (cod_ramo, nome)
Aplicativo (cod_aplicativo, nome)
Projeto (cod_projeto, nome)
Empregado (cod_empregado, nome, cpf, cnh, crea, cod_ramo, cod_departamento, tipo)
cod_ramo referencia Ramo (supondo adição de coluna)
cod_departamento referencia Departamento
Dominio (cod_empregado, cod_aplicativo)
cod_empregado referencia Empregado
cod_aplicativo referencia Aplicativo
EngenheiroProjeto (cod_empregado, cod_projeto)
cod_empregado referencia Empregado
cod_projeto referencia Projeto
Uma tabela por entidade especializada
Outra implementação possível é feita por meio da criação de uma tabela para cada entidade especializada. Veja como fica:
Departamento (cod_departamento, nome)
Ramo (cod_ramo, nome)
Aplicativo (cod_aplicativo, nome)
Projeto (cod_projeto, nome)
Empregado (cod_empregado, nome, cpf, cod_departamento)
cod_departamento referencia Departamento
Motorista (cod_empregado, cnh)
cod_empregado referencia Empregado
Engenheiro (cod_empregado, crea, cod_ramo)
cod_empregado referencia Empregado
cod_ramo referencia Ramo
Dominio (cod_empregado, cod_aplicativo)
cod_empregado referencia Empregado
cod_aplicativo referencia Aplicativo
EngenheiroProjeto (cod_empregado, cod_projeto)
cod_empregado referencia Engenheiro
cod_projeto referencia Projeto
8. Exercícios e encerramento
Exercícios
Dada a seguinte descrição textual:
Clientes alugam veículos por meio de contratos de aluguel. Um cliente pode contratar diversos aluguéis. Um aluguel pertence a apenas um cliente. Um contrato de aluguel pertence a um escritório e cada escritório pode realizar múltiplos contratos de aluguel. Cada contrato de aluguel envolve apenas um veículo. Um veículo pode ser envolvido em múltiplos contratos de aluguel. Há dois tipos de veículos: Automóvel e Ônibus. Um veículo é similar a diversos veículos. Um veículo tem diversos veículos similares a ele.
- Construa um DER que retrate as características descritas. Invente atributos para entidades que façam sentido no mundo real.
- Projete um banco de dados relacional em função do DER que você construiu.
Parabéns!
Você viu como levar cada construção da modelagem ER para tabelas do modelo relacional e como escolher entre fusão de tabelas, tabela própria e adição de colunas. Com isso, a revisão de modelagem está completa e você está pronto para começar a programar no banco de dados com PL/pgSQL.
Bibliografia
- HEUSER, Carlos Alberto. Projeto de Banco de Dados. 6ª ed. Bookman, 2008.