Microsserviços, parte 2: classificação, eventos perdidos e Docker
Continue a aplicação de lembretes em microsserviços com Node.js criando o microsserviço de classificação de observações, tratando eventos perdidos no barramento de eventos, comparando estratégias de implantação e executando cada microsserviço em um contêiner Docker.
1. Visão geral
Este codelab é a parte 2 de 3 da apostila Arquiteturas de Sistemas Computacionais. Ele continua a aplicação de lembretes e observações construída na parte 1, formada pelos microsserviços de lembretes (porta 4000), observações (porta 5000), consulta (porta 6000) e pelo barramento de eventos (porta 10000).
O que você vai aprender
- Como avaliar alternativas de arquitetura para uma nova funcionalidade (classificação de observações)
- Como implementar o microsserviço de classificação e o fluxo de eventos
ObservacaoCriada,ObservacaoClassificadaeObservacaoAtualizada - Como fazer os microsserviços descartarem eventos que não lhes interessam
- Como lidar com eventos perdidos armazenando eventos no barramento
- Vantagens e desvantagens de diferentes estratégias de implantação
- O que são contêineres e como eles se comparam a máquinas virtuais
- Como criar imagens com um
Dockerfile, usar o.dockerignoree executar contêineres com o Docker
O que você vai precisar
- Ter concluído a parte 1 (codelab
mss-microsservicos-parte-1), com os microsserviços de lembretes, observações, consulta e o barramento de eventos - Node.js, npm, um editor de código e o Postman
- O Docker Desktop (Windows e MacOS) ou o Docker para Linux, que você instala neste codelab
2. Classificação de observações: alternativas
Suponha que desejamos classificar algumas observações realizadas, indicando que elas são "importantes". Para que uma observação seja considerada importante, basta que ela contenha a palavra "importante". Trata-se de uma funcionalidade extremamente simples e podemos empregar diversas técnicas para implementá-la.
Implementação no próprio microsserviço de observações
Neste cenário, o microsserviço de observações se encarregaria de analisar o conteúdo de cada observação, como ilustra a figura a seguir.
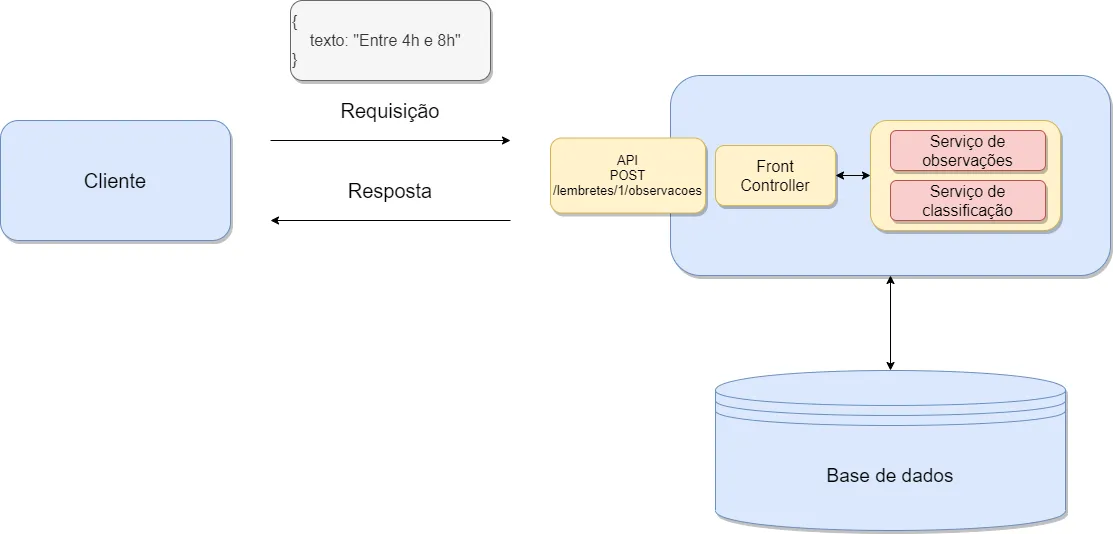
Classificação implementada dentro do próprio microsserviço de observações.
Embora essa implementação seja simples, ela tem algumas características que podem ser indesejáveis.
- A razão de ser do microsserviço de observações é fazer manipulações de acesso a dados envolvendo observações. A classificação tem uma regra um tanto específica que, inclusive, pode mudar com o tempo e se tornar mais complexa. Entregar essa nova responsabilidade ao microsserviço de observações pode comprometer a sua alta coesão, o que traz como consequência níveis mais baixos de manutenibilidade e reusabilidade.
- A sua implementação feita no microsserviço de observações pode comprometer uma das principais vantagens obtidas quando a arquitetura baseada em microsserviços é empregada: a possibilidade de equipes diferentes serem responsáveis por microsserviços diferentes e utilizarem tecnologias completamente diferentes em suas implementações.
- A classificação de uma observação não necessariamente é imediata. Ela não necessariamente ocorre assim que uma observação é inserida no sistema. É claro que estamos lidando com um exemplo didático, simples. No entanto, a classificação poderia ser um processo demorado que poderia, inclusive, requerer intervenção manual. Assim, em um determinado instante, pode ser de interesse manter a funcionalidade de classificação de observações em funcionamento mesmo se eventualmente o microsserviço de observações estiver indisponível.
Microsserviço próprio para a classificação
Implementar a funcionalidade de classificação como um novo microsserviço parece natural. Uma possibilidade é ilustrada na figura a seguir.
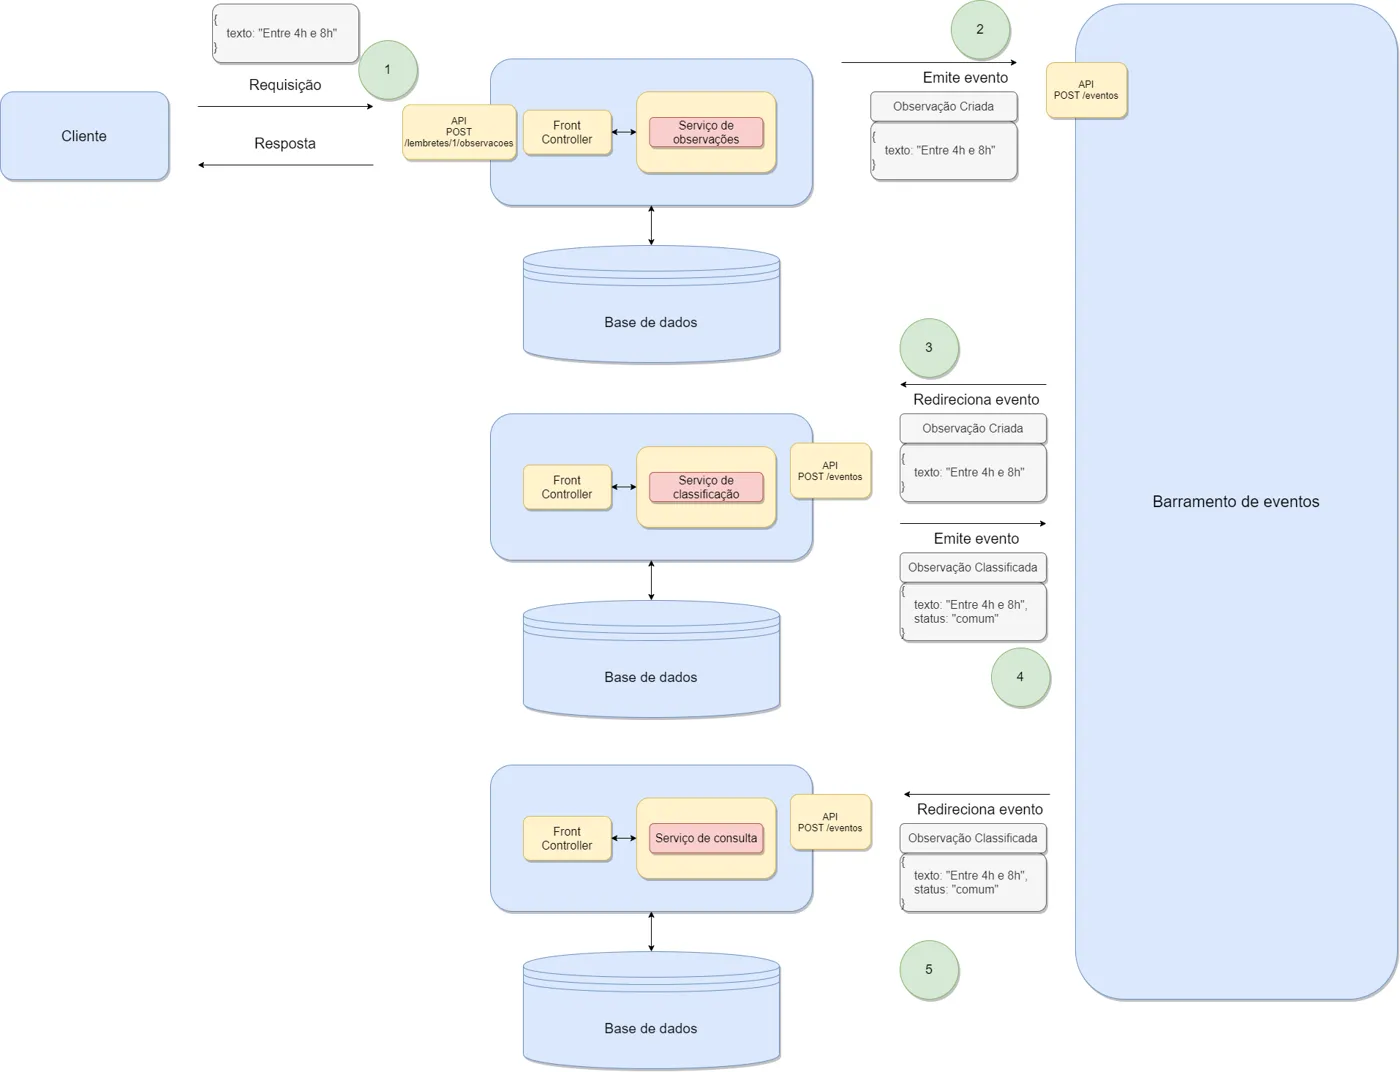
Microsserviço próprio para a classificação, conectado ao barramento de eventos.
Essa alternativa ilustra uso apropriado da arquitetura baseada em microsserviços. Entretanto, dependendo da natureza da aplicação, ela pode trazer consequências também indesejáveis.
- Um usuário que faz a inserção de uma nova observação espera ser capaz de vê-la no sistema (na interface gráfica que está utilizando para acessar as funcionalidades) imediatamente. Ela precisa, pelo menos, ser apresentada com o status sendo avaliada ou algo parecido. Se o microsserviço de classificação demorar para realizar o seu trabalho, a base de dados do microsserviço de consulta ficará desatualizada e ela não poderá ser visualizada.
Microsserviço próprio para a classificação: atualização feita pelo microsserviço de consulta
Outra possibilidade de implementação é ilustrada pela figura a seguir.
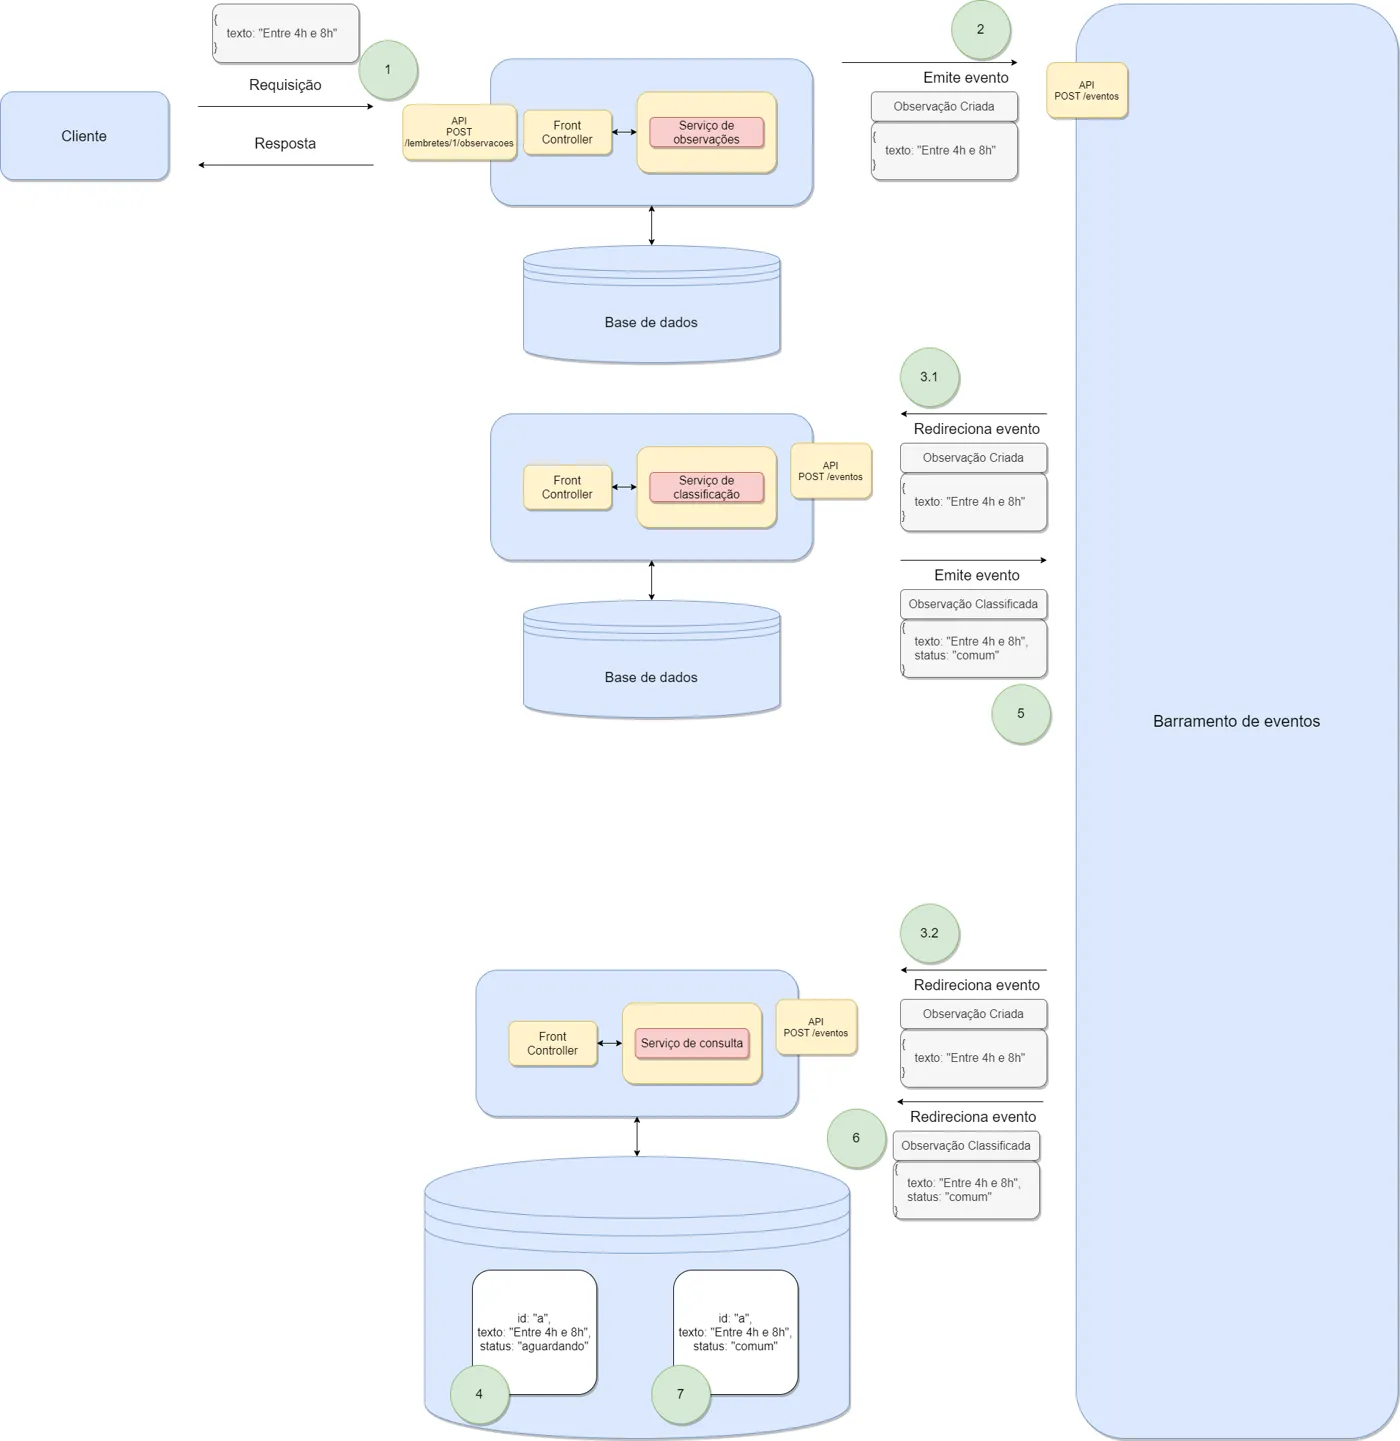
O microsserviço de consulta passa a interpretar o evento de classificação.
Com esta opção, o microsserviço de consulta passa a ter novas responsabilidades. Ele já é responsável por preparar os dados para disponibilização para aplicações clientes. Ele passa a ser responsável por interpretar outros tipos de eventos. Na figura ele está lidando somente com um novo tipo de evento. Entretanto, novos tipos de atualizações podem ser necessárias e, assim, a sua simplicidade e alta coesão seriam comprometidas.
Microsserviço próprio para a classificação: evento genérico de atualização
A manipulação de eventos envolvendo observações cabe, afinal, ao microsserviço de observações. Embora não deva ser responsável pela classificação, uma vez que ela estiver pronta, ele deve ser o responsável por interpretá-la e atualizar a base de acordo. Além disso, ele deve gerar um evento genérico de atualização direcionado ao microsserviço de consulta. Ele vai simplesmente atualizar a base sem saber a que se refere aquela atualização. Sem, portanto, saber de detalhes específicos de observações. A figura a seguir ilustra essa estratégia.
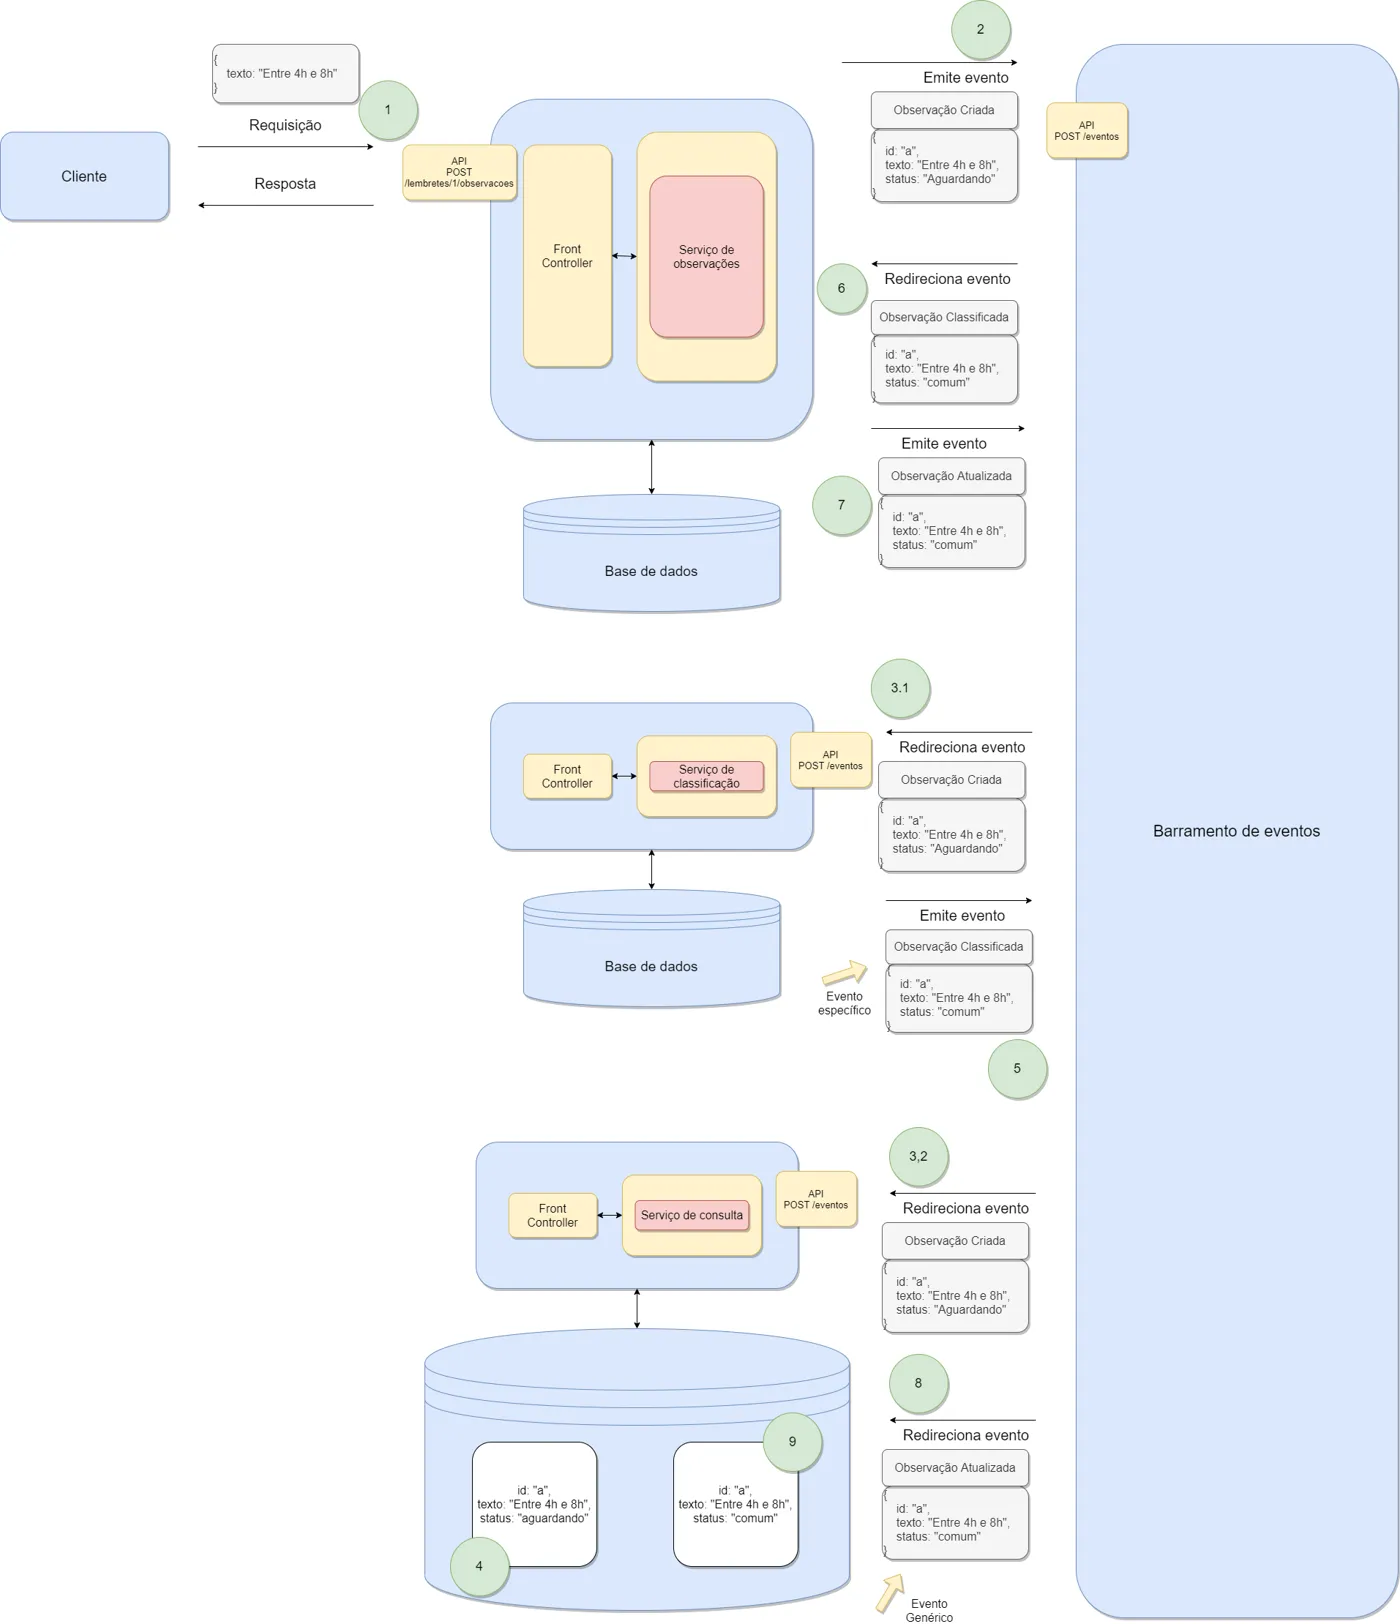
Estratégia adotada: o microsserviço de observações emite um evento genérico de atualização.
3. O microsserviço de classificação
Diante de todas as observações e vantagens e desvantagens abordadas, adotaremos esta última estratégia. Crie uma pasta chamada classificacao, lado a lado com as demais, como mostra a figura a seguir.
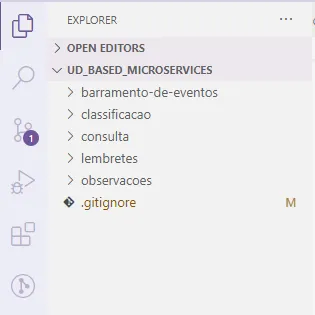
A pasta classificacao ao lado dos demais microsserviços.
Ela irá abrigar os arquivos referentes à implementação do microsserviço de classificação. A seguir, execute
Terminal (pasta classificacao)
npm init -y
para criar um projeto. As dependências podem ser instaladas com
Terminal (pasta classificacao)
npm install express nodemon axios
Crie também um arquivo chamado index.js dentro da pasta classificacao. A seguir, no arquivo package.json, adicione o script para execução como fizemos com os demais microsserviços. Veja o código a seguir.
classificacao/package.json
{
  "name": "classificacao",
  "version": "1.0.0",
  "description": "",
  "main": "index.js",
  "scripts": {
    "test": "echo \"Error: no test specified\" && exit 1",
    "start": "nodemon index.js"
  },
  "keywords": [],
  "author": "",
  "license": "ISC",
  "dependencies": {
    "axios": "^0.21.1",
    "express": "^4.17.1",
    "nodemon": "^2.0.7"
  }
}
A princípio, o microsserviço de classificação irá aguardar por eventos do tipo observação criada. O código a seguir mostra seu código inicial, que deve ficar no arquivo index.js.
classificacao/index.js
const express = require("express");
const app = express();
app.use(express.json());

app.post('/eventos', (req, res) =>{

});

app.listen(7000, () => console.log ("Classificação. Porta 7000"));
Execute o novo microsserviço com
Terminal (pasta classificacao)
npm start
4. Status das observações e entrega à classificação
Microsserviço de observações registra status para cada nova observação
Passamos agora a fazer os ajustes necessários para que a solução fique condizente com a arquitetura escolhida no passo anterior. Quando o microsserviço de observações recebe uma nova requisição para criação de nova observação, ele a armazena na base com id e texto. A partir de agora, ele irá armazenar o status inicial, que será aguardando para todas as novas observações. Além disso, ao emitir um evento de observação criada, ele deve incluir o status. Veja o código a seguir.
observacoes/index.js
app.put("/lembretes/:id/observacoes", async (req, res) => {
  const idObs = uuidv4();
  const { texto } = req.body;
  //req.params dá acesso à lista de parâmetros da URL
  const observacoesDoLembrete = observacoesPorLembreteId[req.params.id] || [];
  observacoesDoLembrete.push({ id: idObs, texto, status: 'aguardando' });
  observacoesPorLembreteId[req.params.id] = observacoesDoLembrete;
  await axios.post("http://localhost:10000/eventos", {
    tipo: "ObservacaoCriada",
    dados: {
      id: idObs,
      texto,
      lembreteId: req.params.id,
      status: 'aguardando'
    },
  });
  res.status(201).send(observacoesDoLembrete);
});
Barramento de eventos entrega eventos ao microsserviço de classificação
Quando o barramento de eventos recebe um evento de observação criada, ele precisa redirecioná-lo para o microsserviço de classificação. O código a seguir destaca esse ajuste (as duas últimas chamadas a axios.post antes da resposta).
barramento-de-eventos/index.js
app.post("/eventos", (req, res) => {
  const evento = req.body;
  //envia o evento para o microsserviço de lembretes
  axios.post("http://localhost:4000/eventos", evento);
  //envia o evento para o microsserviço de observações
  axios.post("http://localhost:5000/eventos", evento);
  //envia o evento para o microsserviço de consulta
  axios.post("http://localhost:6000/eventos", evento);
  //envia o evento para o microsservico de classificacao
  axios.post("http://localhost:7000/eventos", evento);
  res.status(200).send({ msg: "ok" });
});
5. O fluxo de classificação
Microsserviço de classificação trata eventos recebidos
O microsserviço de classificação, por sua vez, recebe um evento do tipo ObservacaoCriada e emite um outro evento do tipo ObservacaoClassificada, como no código a seguir.
classificacao/index.js
const express = require("express");
const axios = require("axios");
const app = express();
app.use(express.json());
const palavraChave = "importante";
const funcoes = {
  ObservacaoCriada: (observacao) => {
    observacao.status =
      observacao.texto.includes(palavraChave)
        ? "importante"
        : "comum";
    axios.post("http://localhost:10000/eventos", {
      tipo: "ObservacaoClassificada",
      dados: observacao,
    });
  },
};
app.post("/eventos", (req, res) => {
  funcoes[req.body.tipo](req.body.dados);
  res.status(200).send({ msg: "ok" });
});

app.listen(7000, () => console.log("Classificação. Porta 7000"));
Microsserviço de observações lida com eventos emitidos pelo microsserviço de classificação
O responsável por manipular eventos do tipo ObservacaoClassificada é o microsserviço de observações. Quando recebe um desses, ele atualiza a sua base e emite um evento genérico, do tipo ObservacaoAtualizada. Veja o código a seguir.
observacoes/index.js
...
const observacoesPorLembreteId = {};
...
const funcoes = {
  ObservacaoClassificada: (observacao) => {
    const observacoes = observacoesPorLembreteId[observacao.lembreteId];
    const obsParaAtualizar = observacoes.find(o => o.id === observacao.id)
    obsParaAtualizar.status = observacao.status;
    axios.post('http://localhost:10000/eventos', {
      tipo: "ObservacaoAtualizada",
      dados: {
        id: observacao.id,
        texto: observacao.texto,
        lembreteId: observacao.lembreteId,
        status: observacao.status
      }
    });
  }
}
...
app.post("/eventos", (req, res) => {
  funcoes[req.body.tipo](req.body.dados);
  res.status(200).send({ msg: "ok" });
});
Microsserviço de consulta lida com eventos de observações atualizadas após classificação
O evento do tipo ObservacaoAtualizada tem como destino o microsserviço de consulta. Ele busca a observação pelo id e substitui o objeto existente por aquele incluído no evento. É fundamental que essa atualização seja "burra". Não cabe ao microsserviço de consulta saber, por exemplo, que essa é uma atualização envolvendo o status da observação recebida. Veja o código a seguir.
consulta/index.js
const funcoes = {
  LembreteCriado: (lembrete) => {
    baseConsulta[lembrete.contador] = lembrete;
  },
  ObservacaoCriada: (observacao) => {
    const observacoes =
      baseConsulta[observacao.lembreteId]["observacoes"] || [];
    observacoes.push(observacao);
    baseConsulta[observacao.lembreteId]["observacoes"] = observacoes;
  },
  ObservacaoAtualizada: (observacao) => {
    const observacoes = baseConsulta[observacao.lembreteId]["observacoes"];
    const indice = observacoes.findIndex((o) => o.id === observacao.id);
    observacoes[indice] = observacao;
  },
};
6. Descartando eventos que não interessam
Neste momento, alguns dos microsserviços estão gerando erros em tempo de execução, especialmente aqueles que fazem o tratamento dos eventos recebidos utilizando um mapa de funções. Ocorre que o barramento de eventos faz um simples broadcast a cada vez que recebe um evento. Isso quer dizer que cada microsserviço recebe todo tipo de evento. Obviamente, eles não estão preparados para lidar com todos os tipos de eventos. O microsserviço de consulta, por exemplo, não está interessado no evento de tipo ObservacaoClassificada. O microsserviço de classificação, por sua vez, não está interessado no evento de tipo ObservacaoAtualizada. Assim, precisamos tratar os casos em que os microsserviços recebem eventos que não lhes são de interesse, caso contrário, o acesso ao mapa de funções que cada um possui causará erros em tempo de execução.
O que faremos é extremamente simples. Utilizaremos uma estrutura try/catch para, como o nome sugere, "tentar" acessar o mapa de funções utilizando o tipo do evento recebido como chave. Caso o acesso ocorra com sucesso, o evento recebido é de interesse e o tratamento será realizado por uma das funções do mapa. A execução do bloco try termina com sucesso nesse caso. E o bloco catch é ignorado. Caso contrário, o evento recebido não é de interesse e haverá um erro, já que não existirá função para seu tratamento no mapa. A execução do try é interrompida e desviada para o bloco catch. O bloco catch apenas ignora o fluxo de execução recebido. Assim, eventos que não são de interesse são apenas ignorados. Começamos ajustando o microsserviço de observações. Veja o código a seguir.
observacoes/index.js
...
app.post("/eventos", (req, res) => {
  try{
    funcoes[req.body.tipo](req.body.dados);
  }
  catch (err){}
  res.status(200).send({ msg: "ok" });
});
O microsserviço de consulta também precisa de tratamento, como mostra o código a seguir.
consulta/index.js
...
app.post("/eventos", (req, res) => {
  try {
    funcoes[req.body.tipo](req.body.dados);
  } catch (err) {}
  res.status(200).send({ msg: "ok" });
});
...
O microsserviço de classificação também requer ajustes, de maneira análoga aos demais. Veja o código a seguir.
classificacao/index.js
...
app.post("/eventos", (req, res) => {
  try {
    funcoes[req.body.tipo](req.body.dados);
  } catch (err) {}
  res.status(200).send({ msg: "ok" });
});
...
7. Testando a solução completa
Para testar o funcionamento do sistema, pode ser uma boa ideia reiniciar todos os microsserviços. Assim garantimos que suas bases de dados não têm dados antigos que poderiam estar incondizentes com os novos detalhes de implementação. Feito isso, comece fazendo a inserção de um novo lembrete, como na figura a seguir.
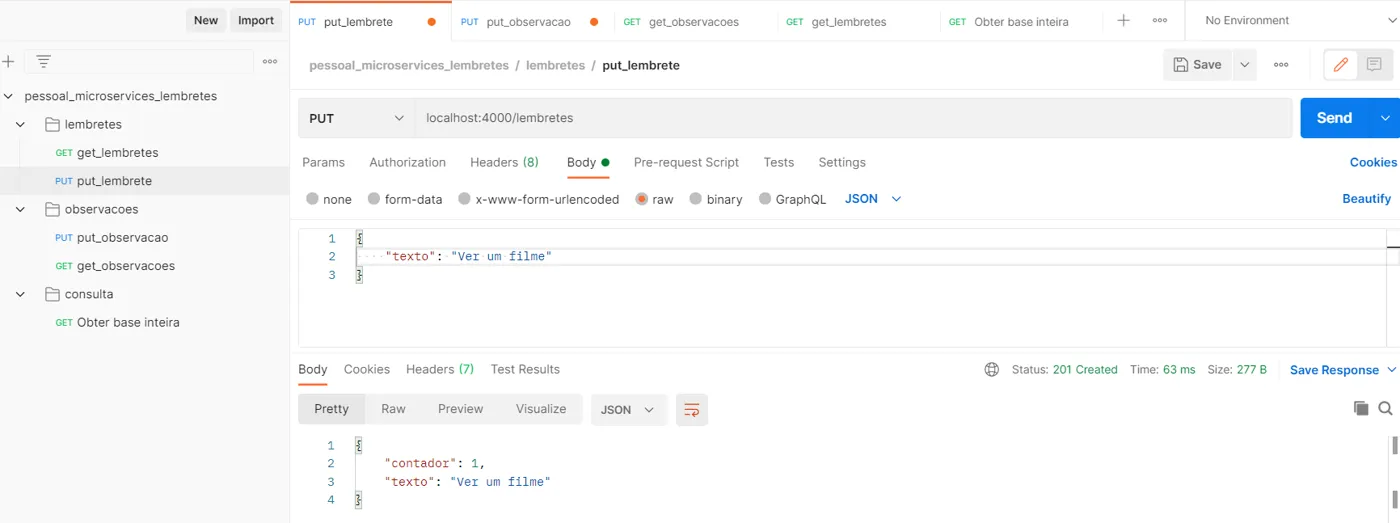
Inserção de um novo lembrete.
Anote o valor devolvido como identificador do lembrete inserido. Ele será usado para a inserção de novas observações. Faça as inserções de observações ilustradas nas duas figuras a seguir. Observe os resultados esperados. Quando a primeira inserção acontece, o microsserviço de observações nos devolve a base inteira imediatamente. Neste instante, a observação ainda não está classificada. Entretanto, ele já emitiu um evento de criação de observação que disparou todo o fluxo de classificação e atualização da base de consulta e de sua própria base.
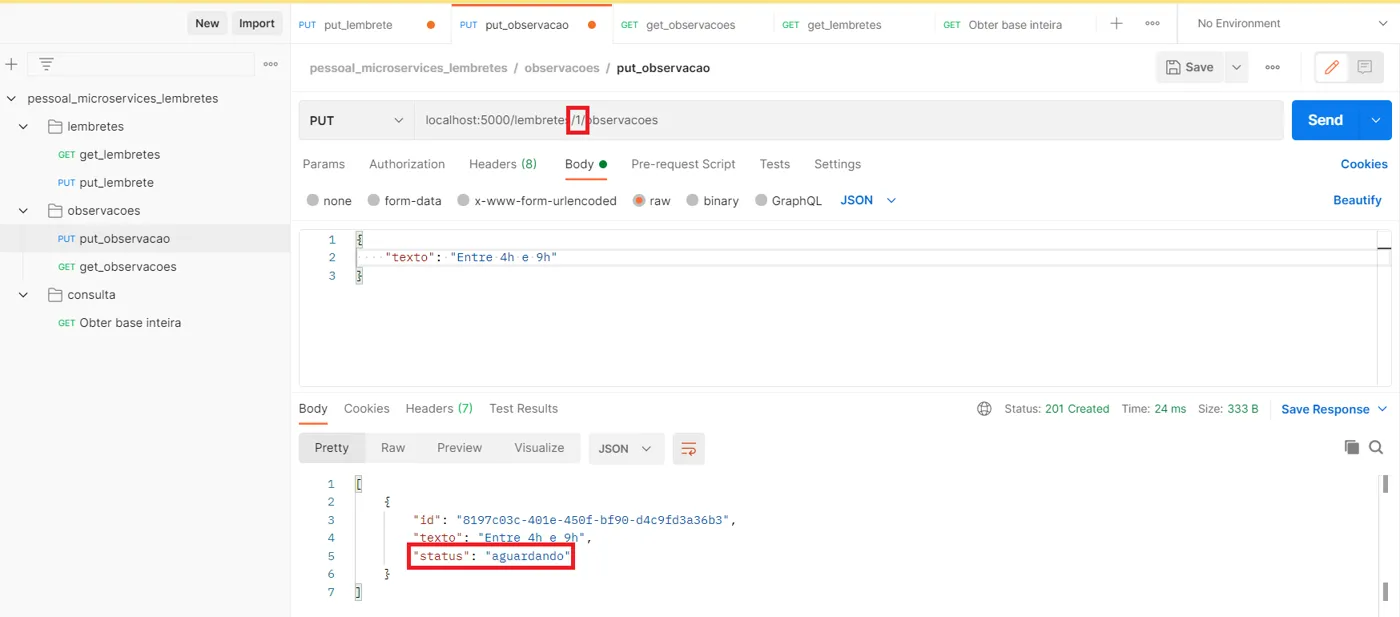
Primeira observação: a resposta imediata ainda mostra o status aguardando.
Repare no resultado esperado depois de fazer a segunda inserção de observação.
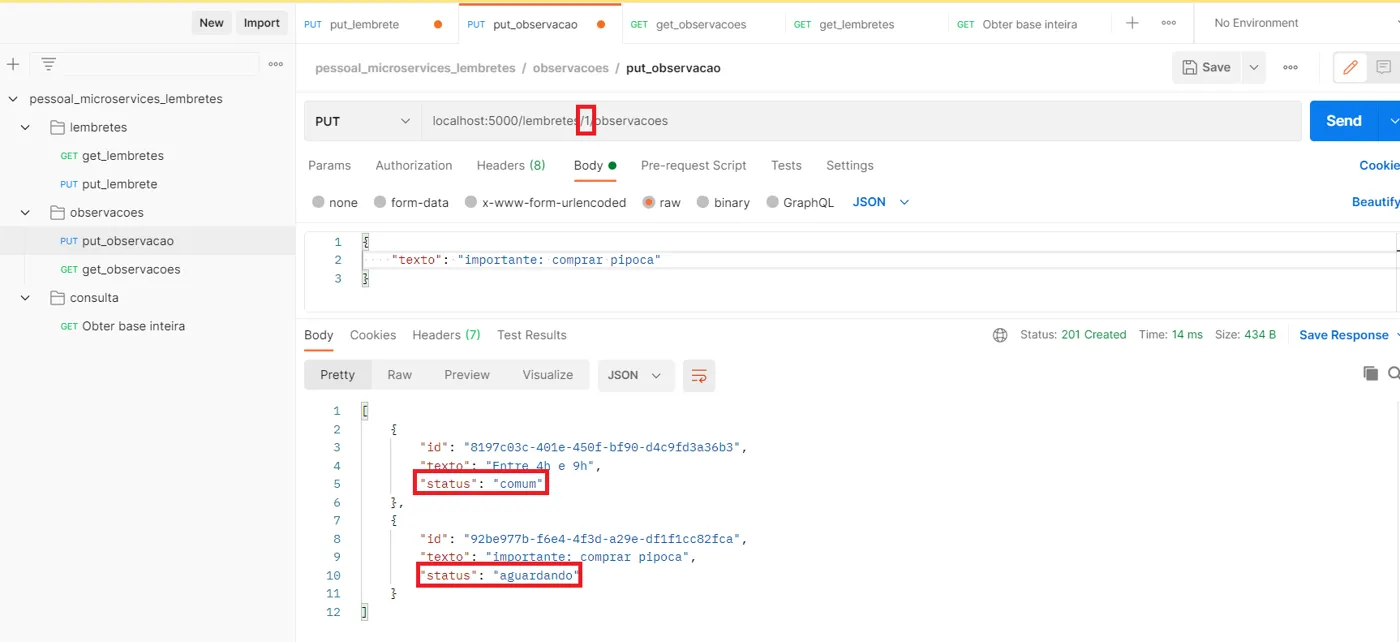
Segunda observação: a primeira já foi classificada.
Envie uma requisição GET para o microsserviço de observações e verifique que todas as observações existentes em sua base já estão classificadas, como ilustra a figura a seguir.
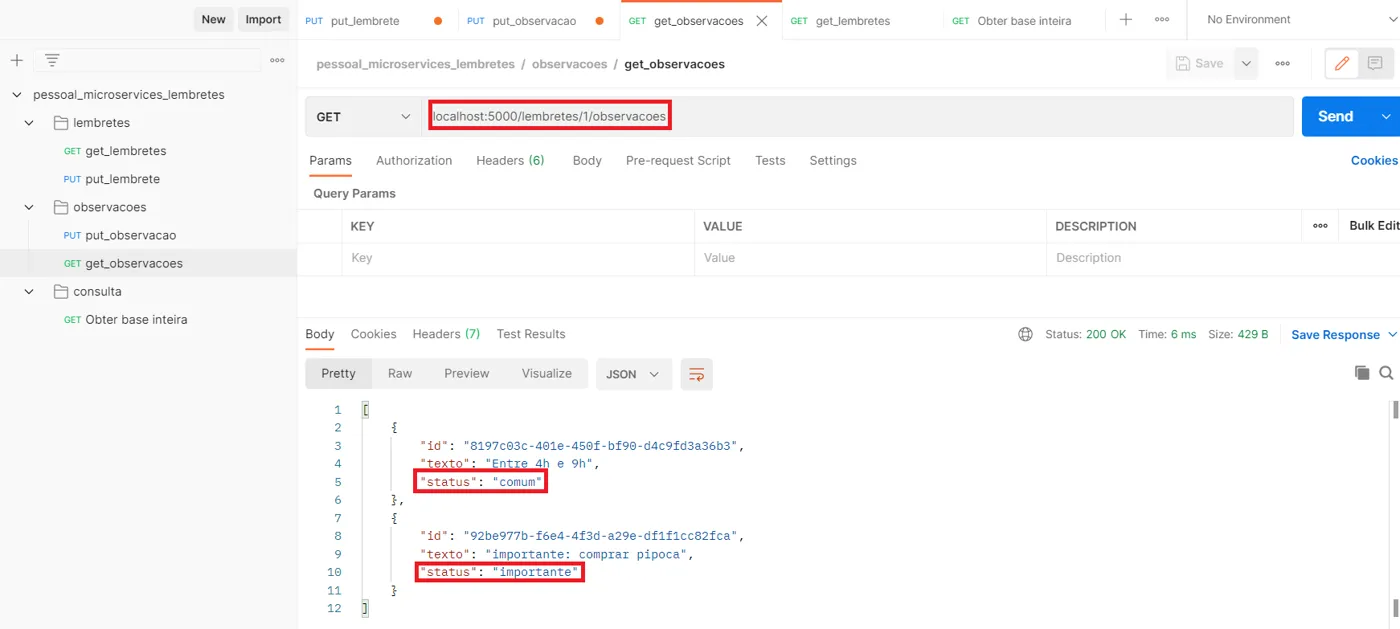
Todas as observações classificadas na base do microsserviço de observações.
Finalmente, envie uma requisição GET para o microsserviço de consulta a fim de obter uma cópia da base inteira, incluindo lembretes e observações. Veja a figura a seguir.
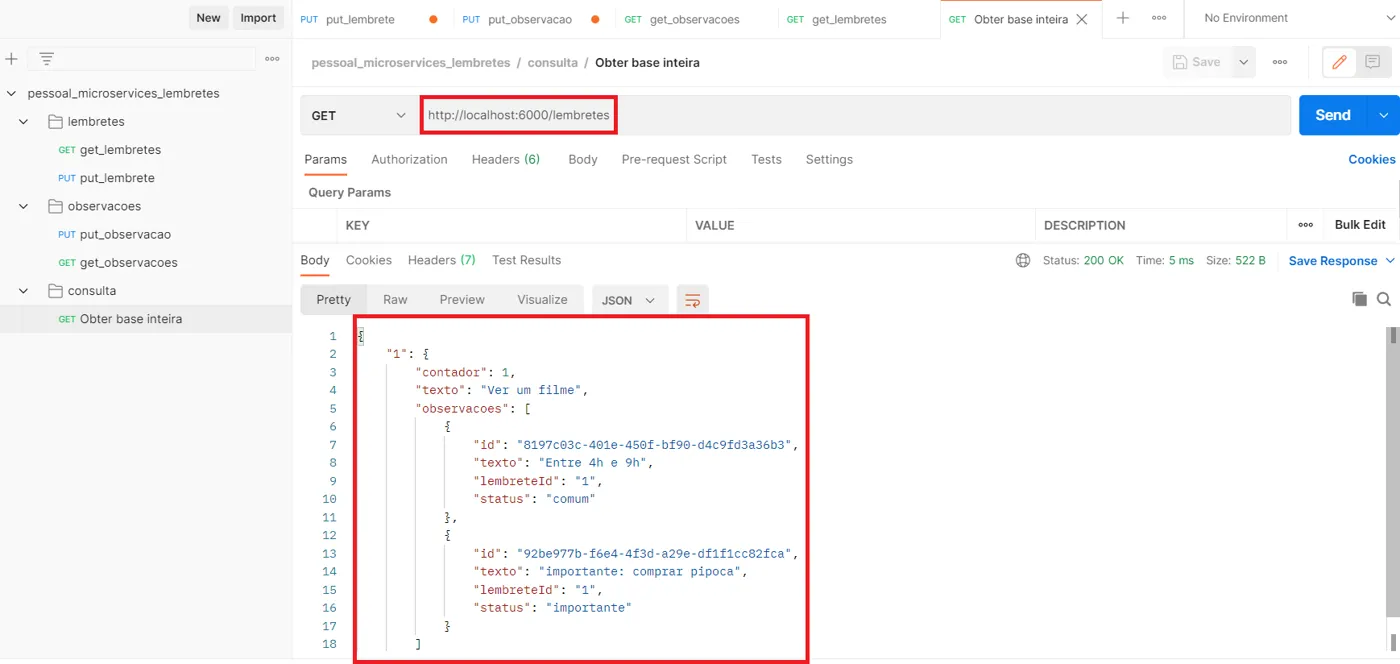
Base do microsserviço de consulta com lembretes e observações classificadas.
8. Como lidar com eventos perdidos?
O sistema funciona adequadamente desde que todos os microsserviços estejam em pleno funcionamento. O que ocorre com uma observação inserida em algum momento em que o microsserviço de classificação não está em funcionamento? Veja a figura a seguir.
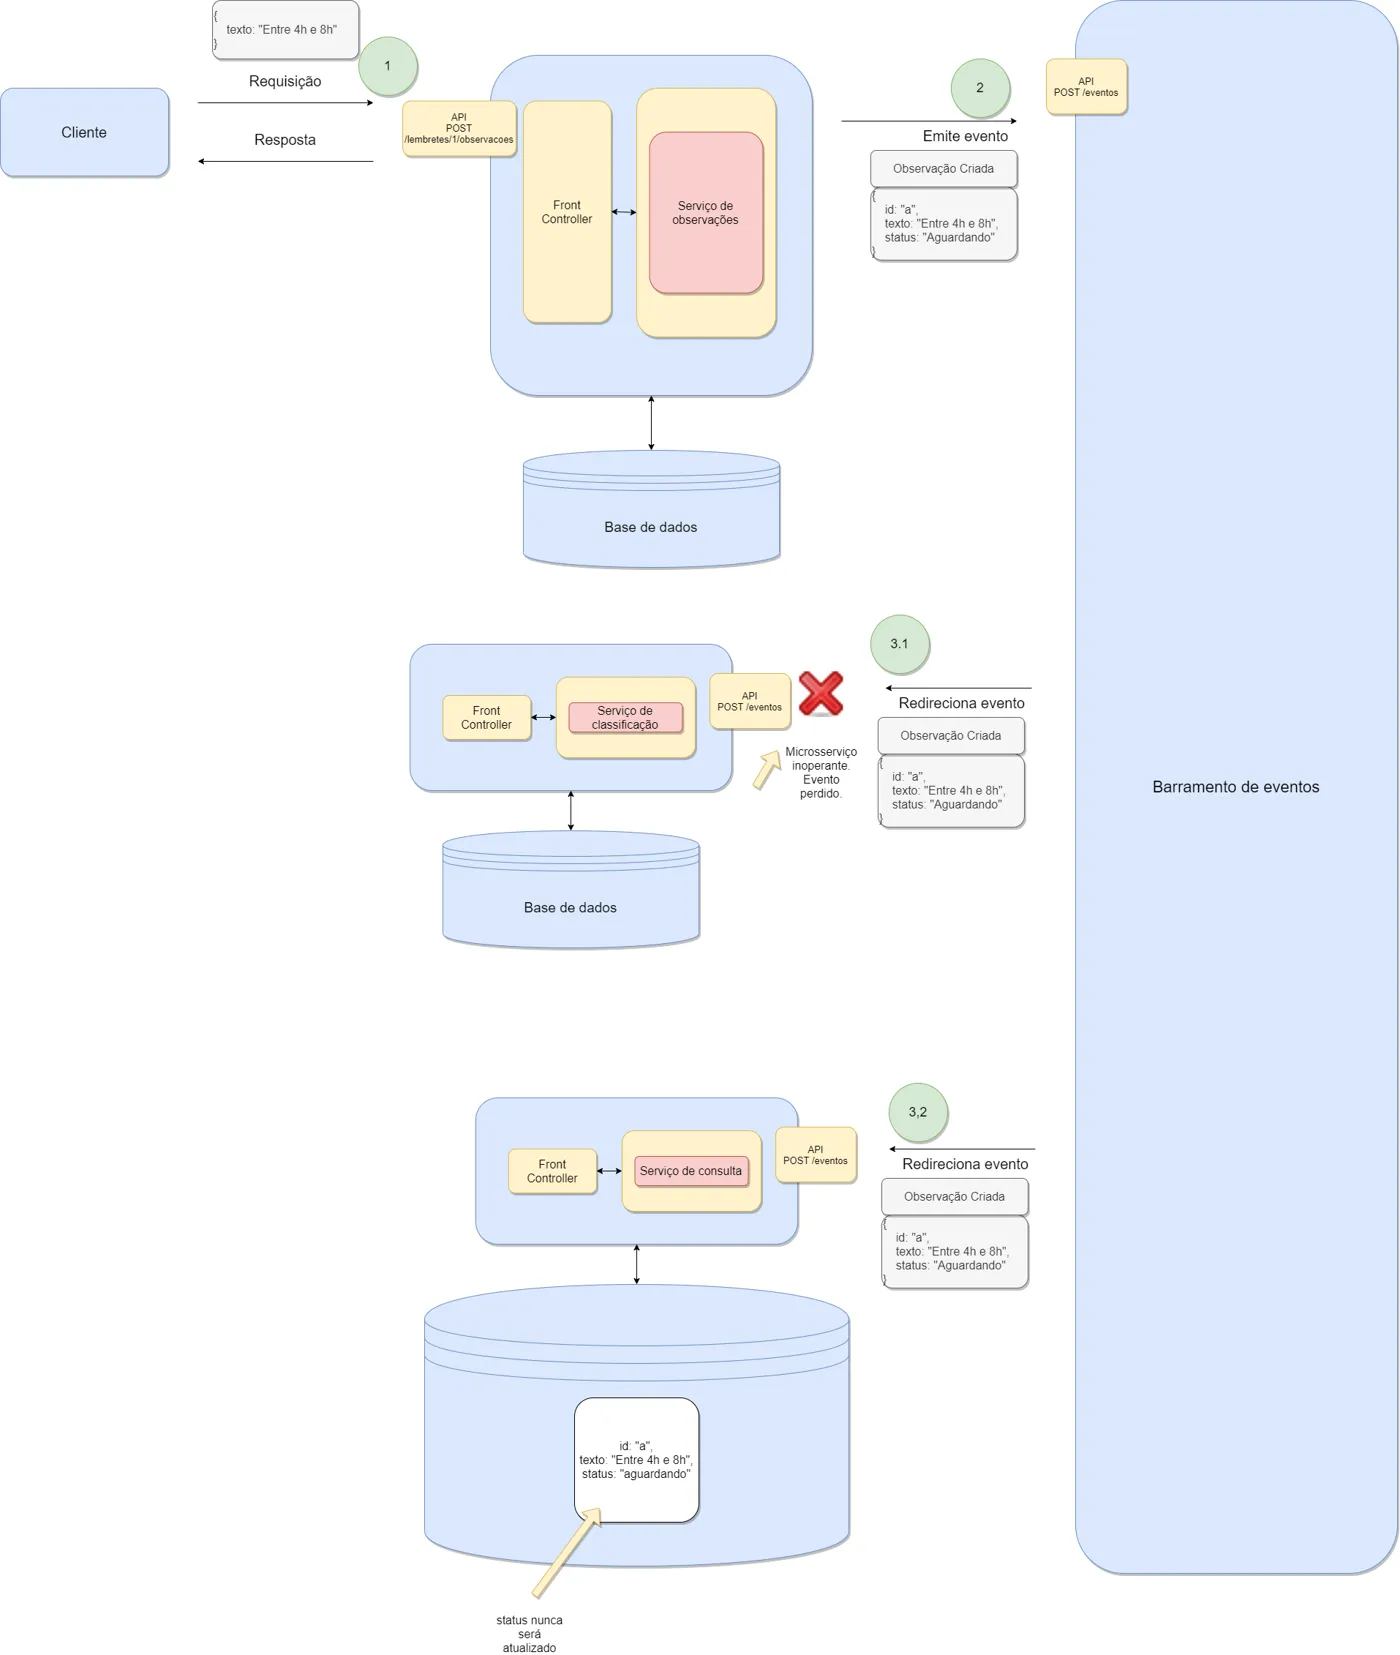
Um evento perdido enquanto o microsserviço de classificação estava inoperante.
Uma vez que um evento tenha sido perdido, os microsserviços que tinham interesse por ele nunca mais poderão vê-lo novamente. Como ilustra a figura, um exemplo de consequência são as observações que nunca são classificadas caso tenham sido inseridas em algum momento em que o microsserviço de classificação estava inoperante.
Eventos perdidos: requisição síncrona
Há algumas possibilidades para resolver esse problema. Uma delas consiste em fazer com que o microsserviço de classificação, uma vez que volte a operar, peça uma cópia das bases de lembretes e observações para seus respectivos microsserviços. Essa possibilidade é ilustrada na figura a seguir.
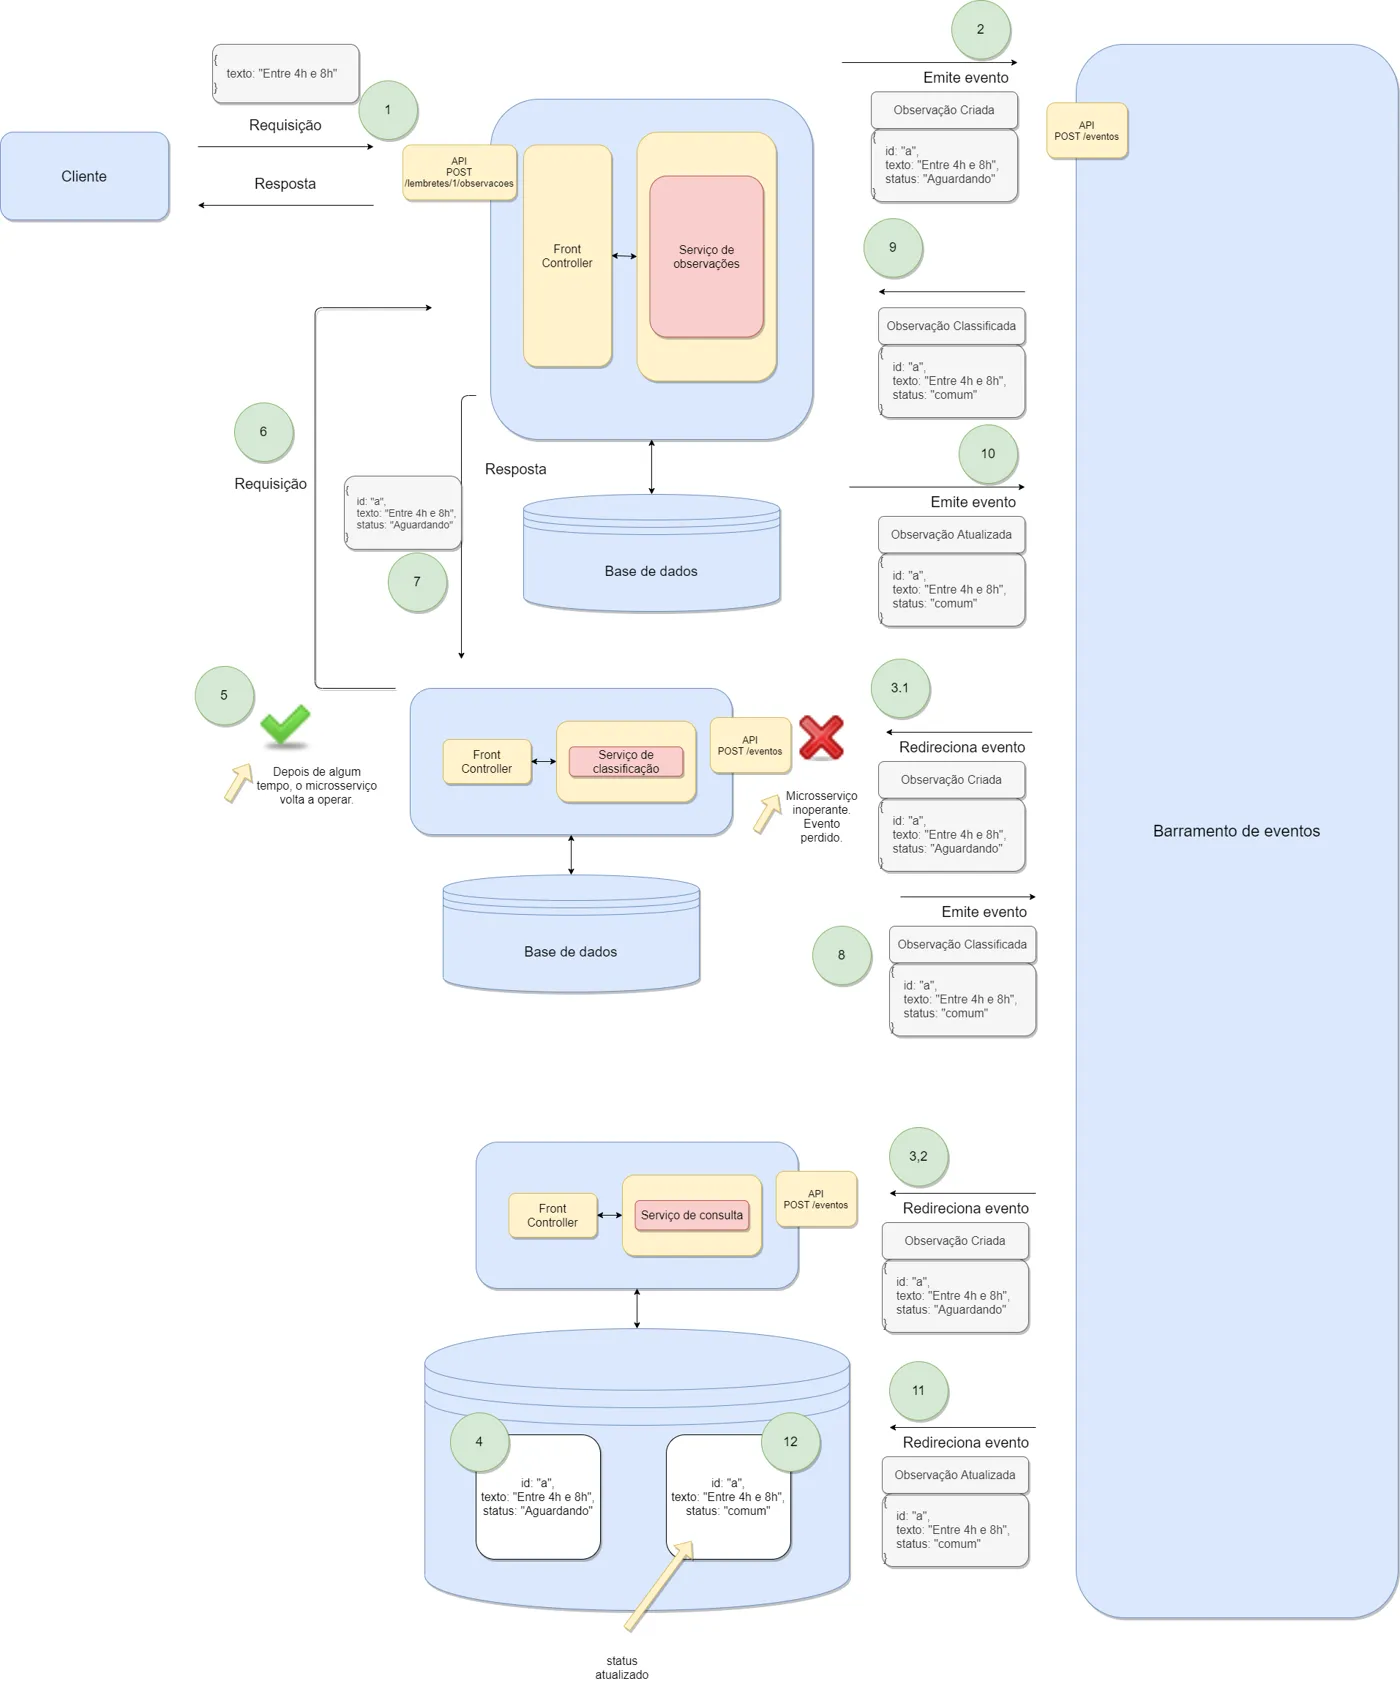
Recuperação por requisições síncronas aos demais microsserviços.
Embora resolva o problema, esta estratégia traz o uso da comunicação síncrona entre microsserviços, algo que temos tentado evitar.
Eventos perdidos: armazenamento de eventos no barramento de eventos
Outra possibilidade é fazer com que o barramento de eventos armazene os eventos que não conseguir entregar aos destinatários. Neste cenário, caso o microsserviço de classificação fique inoperante por algum tempo e perca alguns eventos, quando voltar a operar ele pode solicitar ao barramento os eventos que deixou de receber. Veja a figura a seguir.
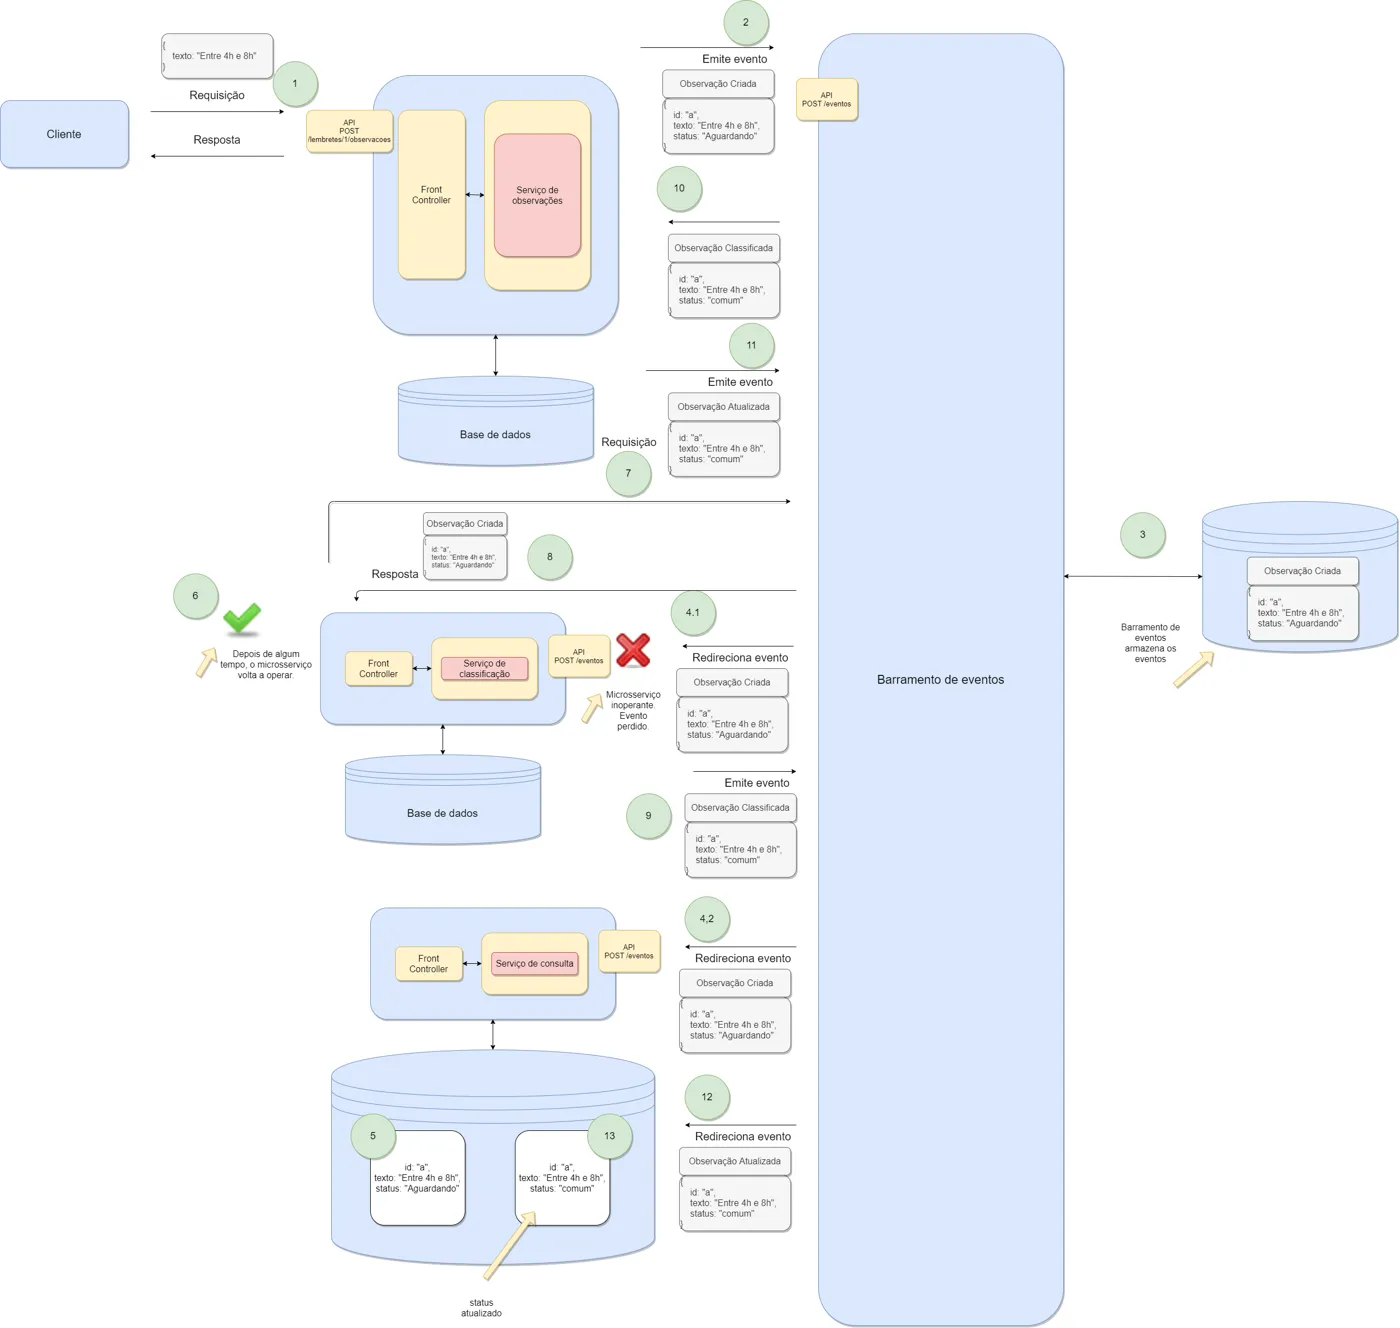
O barramento de eventos armazena eventos para entrega posterior.
9. Barramento de eventos armazena eventos
Adotaremos a estratégia em que o barramento de eventos armazena os eventos recebidos. No código a seguir, definimos uma base de dados (em memória volátil) para o barramento de eventos e fazemos com que ele armazene cada evento recebido. Além disso, adicionamos um novo endpoint que viabiliza a obtenção da base.
barramento-de-eventos/index.js
...
const eventos = []

app.post("/eventos", (req, res) => {
  const evento = req.body;
  eventos.push(evento)
  //envia o evento para o microsserviço de lembretes
  axios.post("http://localhost:4000/eventos", evento);
  //envia o evento para o microsserviço de observações
  axios.post("http://localhost:5000/eventos", evento);
  //envia o evento para o microsserviço de consulta
  axios.post("http://localhost:6000/eventos", evento);
  //envia o evento para o microsservico de classificacao
  axios.post("http://localhost:7000/eventos", evento);
  res.status(200).send({ msg: "ok" });
});

app.get('/eventos', (req, res) => {
  res.send(eventos)
})
...
Microsserviço de consulta solicita eventos potencialmente perdidos
Um dos microsserviços que está interessado em eventos potencialmente perdidos é o microsserviço de consulta. Se ele ficar inoperante em um período de tempo em que inserções de novos lembretes e/ou novas observações ocorrerem, a sua base de dados ficará desatualizada. Por isso, sempre que entrar em funcionamento, ele enviará um pedido ao barramento de eventos pelos eventos em que ele está interessado. Tal envio será feito por uma requisição HTTP, o que quer dizer que ele passa a precisar do pacote axios. Faça a sua instalação com
Terminal (pasta consulta)
npm install axios
O código a seguir mostra o microsserviço de consulta entrando em execução e fazendo o pedido ao barramento de eventos. A seguir, ele processa cada evento recebido, ignorando aqueles que não lhe são de interesse. O axios entrega os resultados de uma requisição GET em uma propriedade chamada data. Veja o esquema de resposta do axios.
consulta/index.js
...
const axios = require("axios");
...
//não esqueça do async
app.listen(6000, async () => {
  console.log("Consultas. Porta 6000");
  const resp = await axios.get("http://localhost:10000/eventos");
  //axios entrega os dados na propriedade data
  resp.data.forEach((valor, indice, colecao) => {
    try {
      funcoes[valor.tipo](valor.dados);
    } catch (err) {}
  });
});
Testando a solução após implementação do tratamento de eventos perdidos
Realize um teste da seguinte forma.
- Certifique-se de que todos os microsserviços estão operando e com a base limpa.
- Faça a inserção de um novo lembrete.
- Consulte a base do microsserviço de consulta. Ela deve incluir o lembrete recém inserido.
- Interrompa o funcionamento do microsserviço de consulta.
- Faça a inserção de um novo lembrete.
- Coloque o microsserviço de consulta novamente em funcionamento.
- Consulte a base do microsserviço de consulta. A base deverá incluir os dois lembretes.
O tratamento é análogo para os demais microsserviços: todos os que tiverem interesse por determinados eventos precisam consultar o barramento de eventos quando entrarem em funcionamento.
10. Implantação
Há diferentes formas viáveis para a implantação da solução, cada qual com vantagens e desvantagens. Nesta seção avaliamos algumas possibilidades.
Única máquina virtual, única instância por microsserviço
Uma forma de implantação da solução consiste na alocação de uma máquina virtual em um serviço de computação em nuvem, como ilustra a figura a seguir.
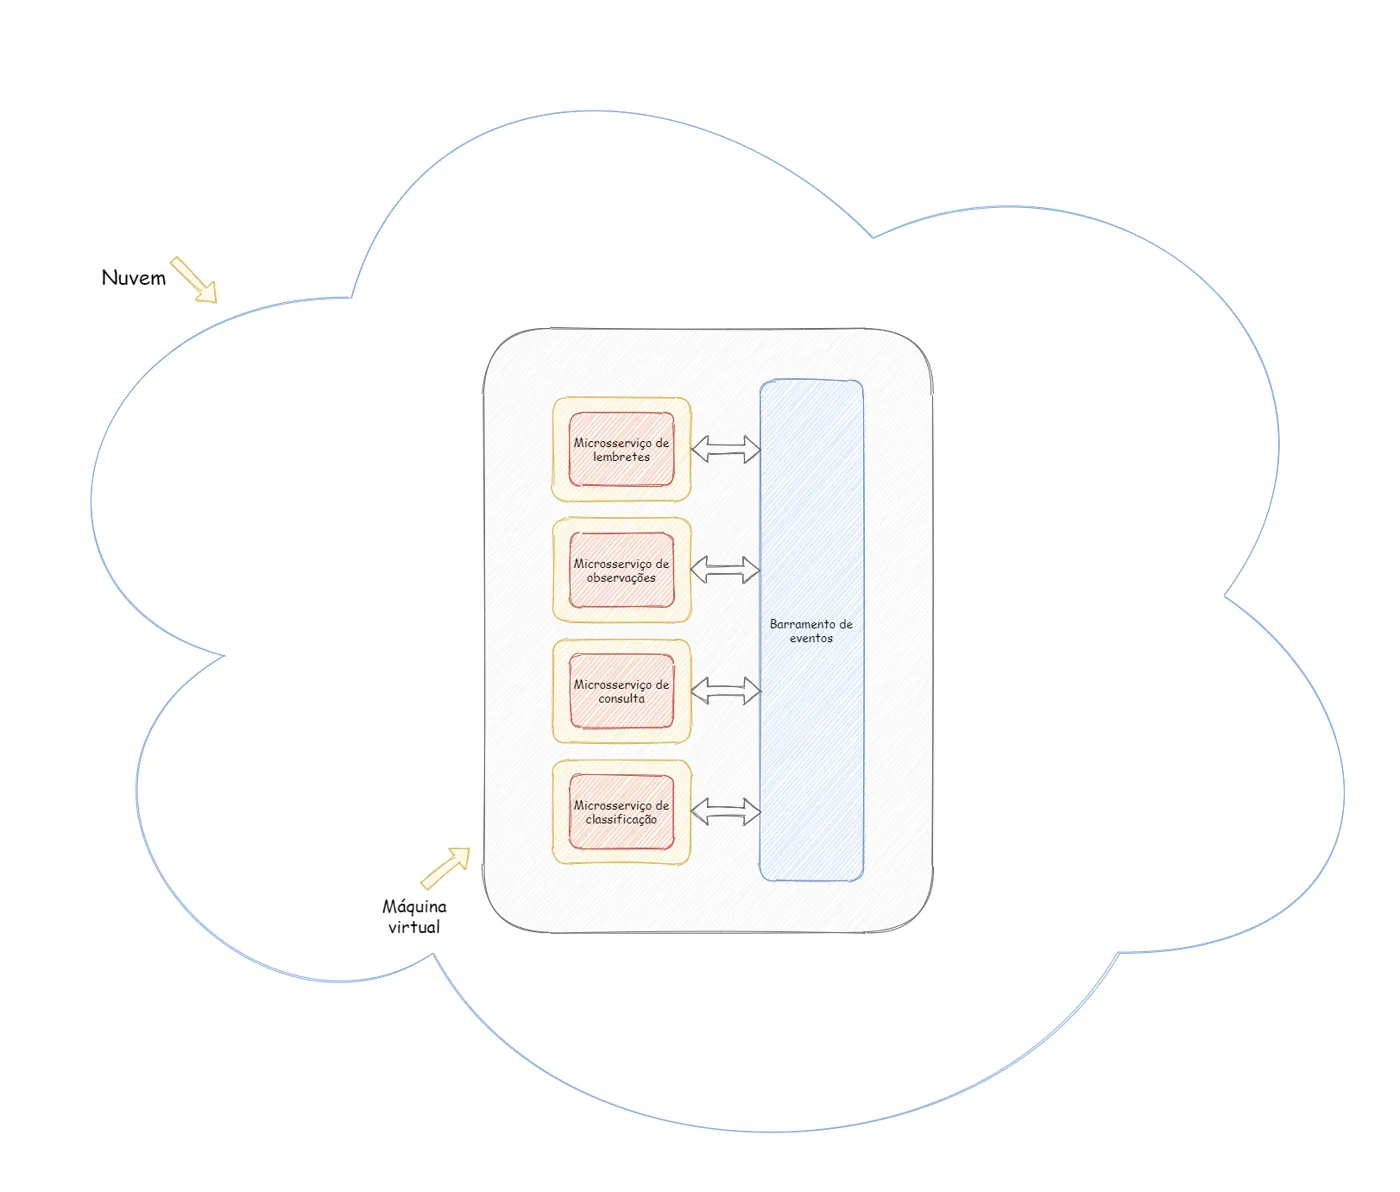
Uma única máquina virtual com uma instância de cada microsserviço.
- Vantagens
- Simplicidade. O modelo é muito fácil de se entender e o seu uso é extremamente simples.
- Custo. A tendência é que essa solução seja relativamente barata.
- Desvantagens
- Único ponto de falha. Esta desvantagem pode ser abstraída caso um serviço de computação em nuvem seja utilizado. Entretanto, se for necessário reiniciar a máquina virtual, por exemplo, todos os microsserviços se tornarão inoperantes durante aquele período.
- Escalabilidade não trivial. O que fazer caso um dos microsserviços fique sobrecarregado?
Múltiplas máquinas virtuais, potenciais múltiplas instâncias para cada microsserviço
Uma das desvantagens do modelo anterior está associada à escalabilidade. Esse problema pode ser resolvido colocando-se em funcionamento múltiplas instâncias dos microsserviços que tiverem maior carga de trabalho potencial. A figura a seguir ilustra essa possibilidade.
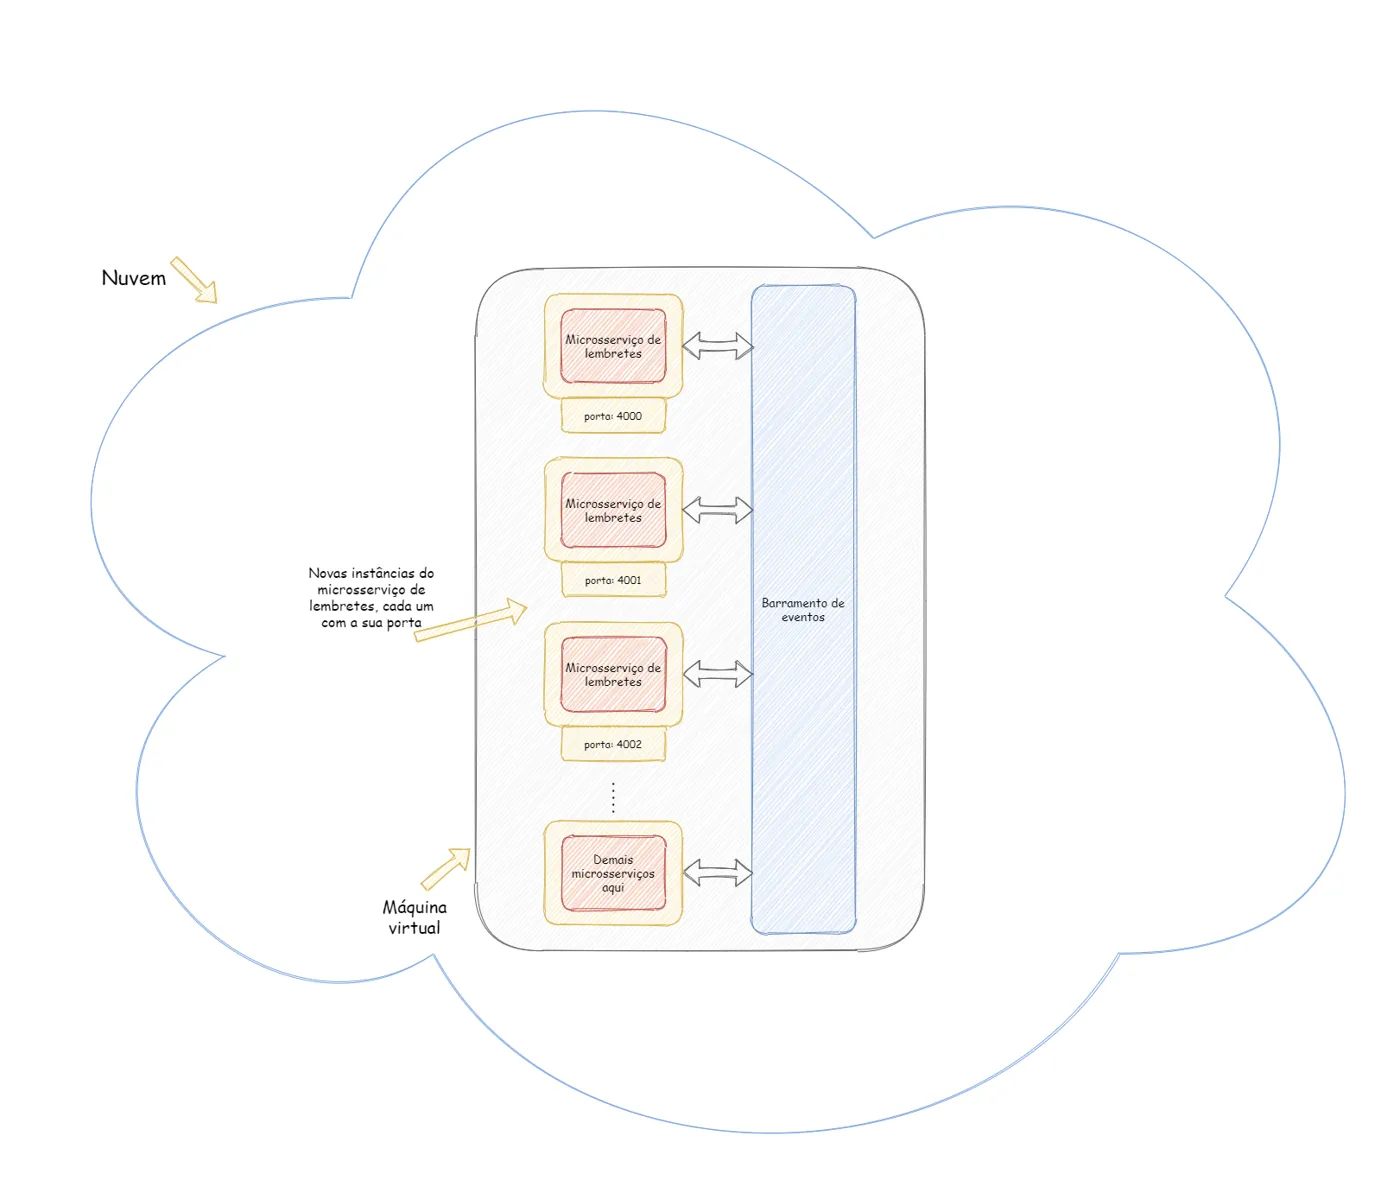
Múltiplas instâncias dos microsserviços mais demandados na mesma máquina virtual.
Embora esse modelo de certa forma resolva o problema de instâncias com alta demanda, ainda há o problema de todas elas estarem sob gerenciamento de uma única máquina virtual. Nada impede, entretanto, que múltiplas máquinas virtuais sejam alocadas, como na figura a seguir.
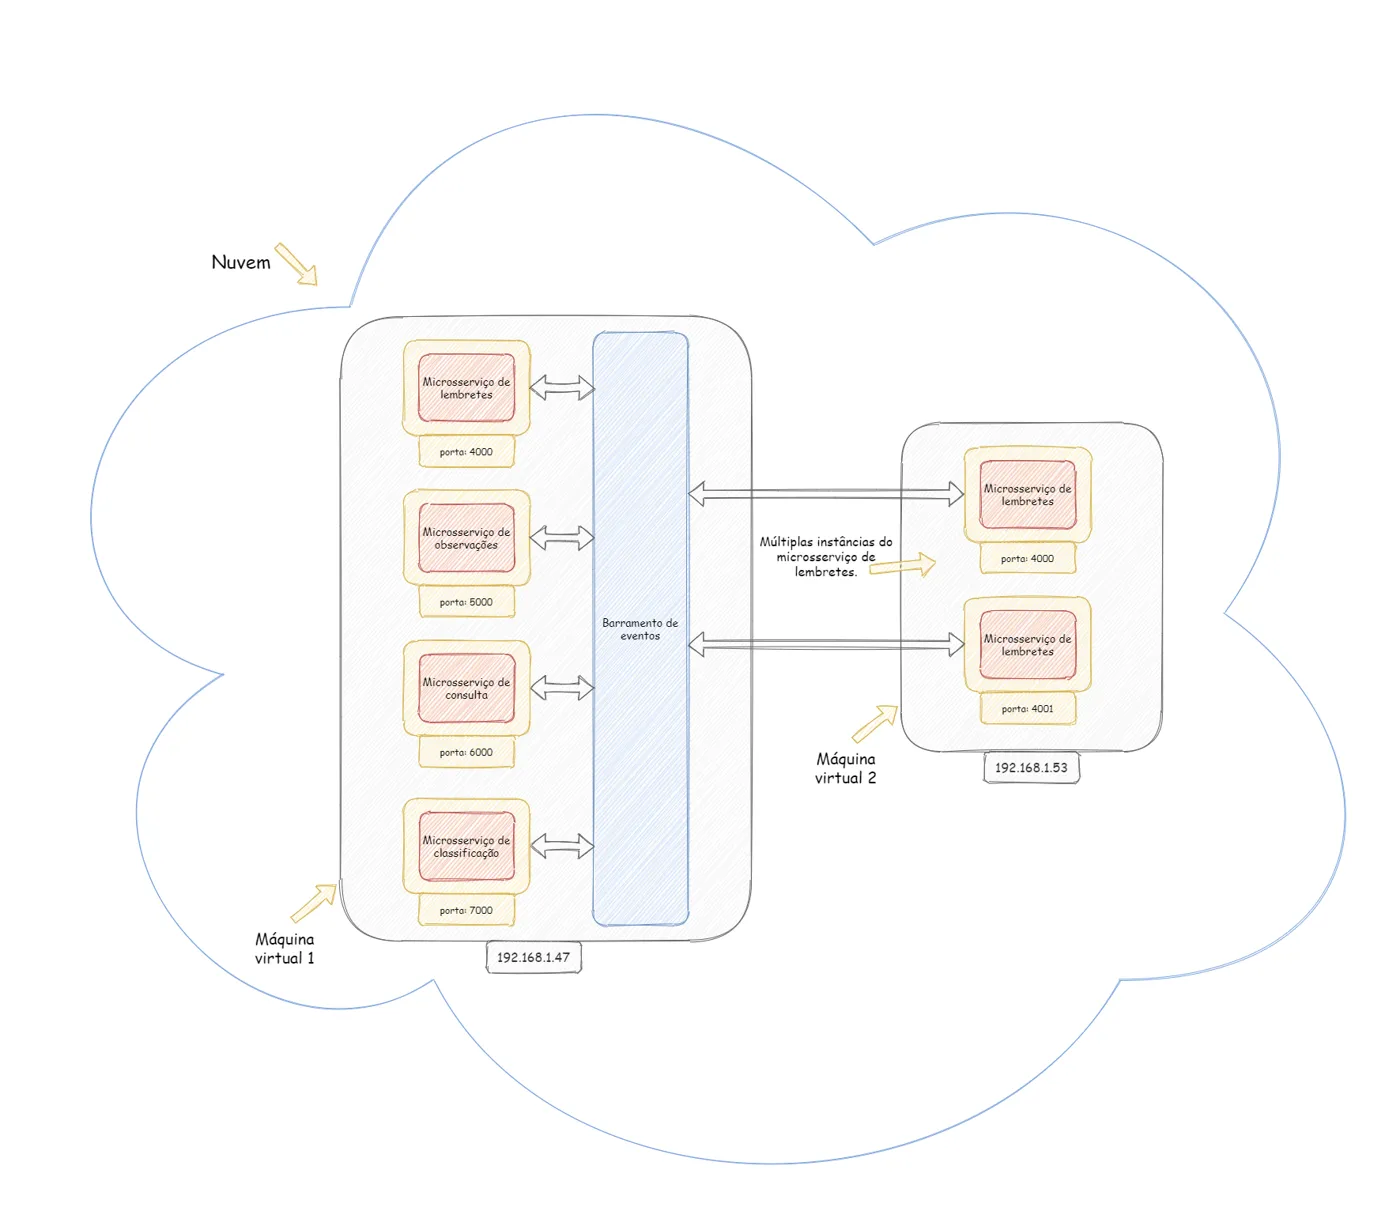
Múltiplas máquinas virtuais com instâncias adicionais dos microsserviços.
Seja com uma única máquina virtual, seja utilizando diversas máquinas virtuais, esta estratégia tende a tornar a implementação do barramento de eventos mais complexa e acoplada a essa solução computacional específica. Ou seja, comprometemos o nível de reusabilidade do barramento de eventos. Inclusive, o problema pode se tornar maior caso o número de instâncias de cada microsserviço ou mesmo de máquinas virtuais possa variar ao longo do tempo. Sob forte demanda, pode ser interessante manter um número alto de máquinas virtuais alocadas. Quando a demanda baixar, pode ser interessante reduzir o número de recursos alocados.
- Vantagens
- Escalabilidade. O modelo pode se ajustar de acordo com a demanda, poupando recursos quando possível.
- Desvantagens
- Implementação do barramento de eventos. A implementação do barramento de eventos torna-se não trivial e acoplada a essa solução específica. A cada instante, ele precisa decidir quais são as portas e quais são os endereços IP para os quais enviar os eventos. Não é razoável manter essa estrutura de seleção no barramento de eventos.
11. Docker
O Docker é uma ferramenta utilizada para criar e gerenciar contêineres.
Contêiner
Um contêiner é uma unidade de software isolada com código a ser executado incluindo as suas dependências.
Quando utilizamos um contêiner, a expectativa é que ele execute sem interferência do ambiente externo. Espera-se, também, que a sua existência não traga impactos relevantes ao desempenho da aplicação. Quando uma aplicação é distribuída utilizando-se um contêiner, temos a vantagem de garantir que as dependências de que necessita, cada uma em sua versão correta, estejam disponíveis. Veja a figura a seguir.
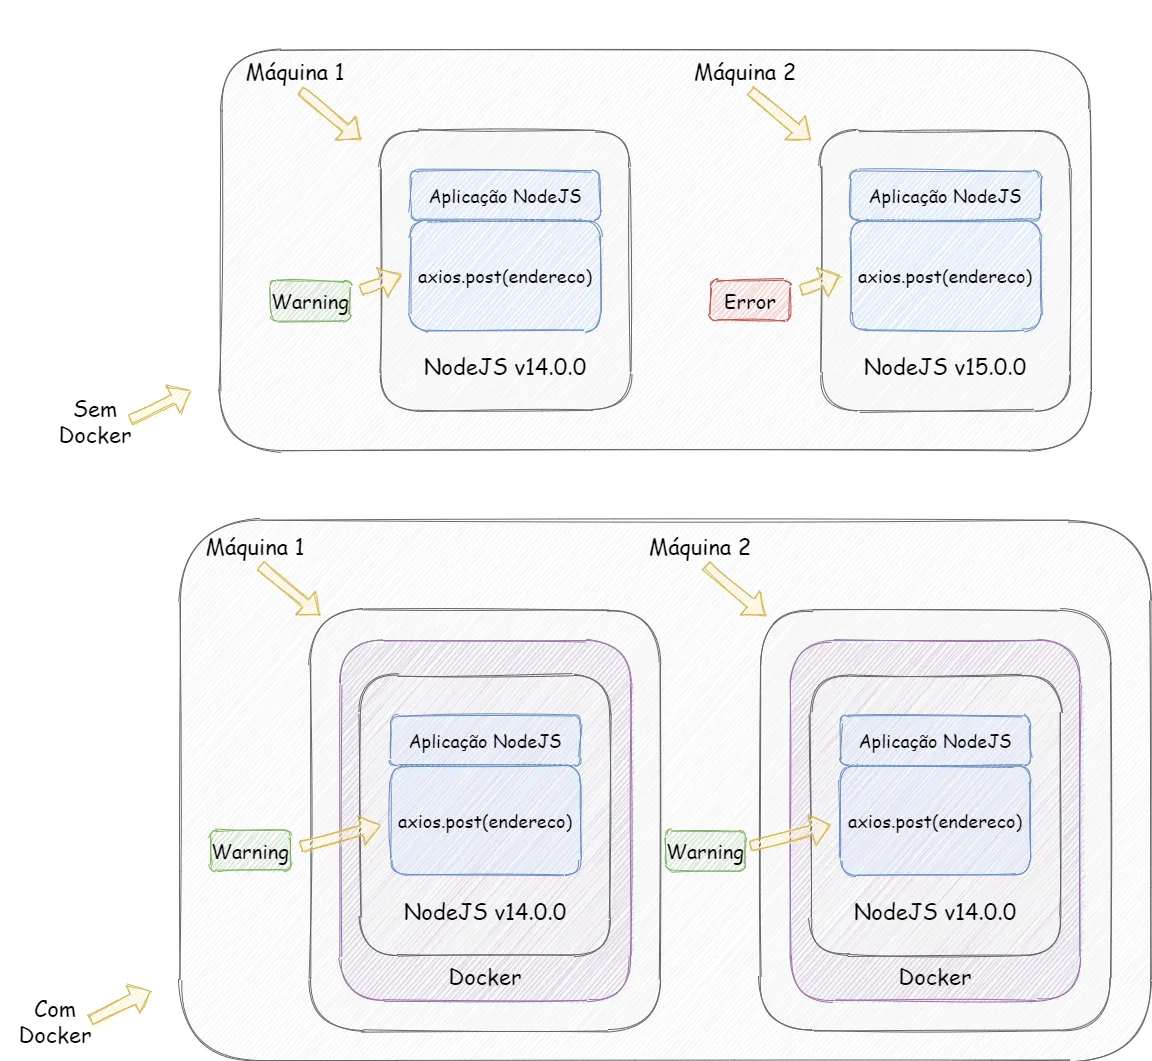
Com contêineres, cada aplicação leva consigo as dependências nas versões corretas.
O uso do Docker se assemelha ao uso de máquinas virtuais. Entretanto, há diferenças fundamentais que, em geral, o tornam mais vantajoso. A figura a seguir ilustra o uso de máquinas virtuais.
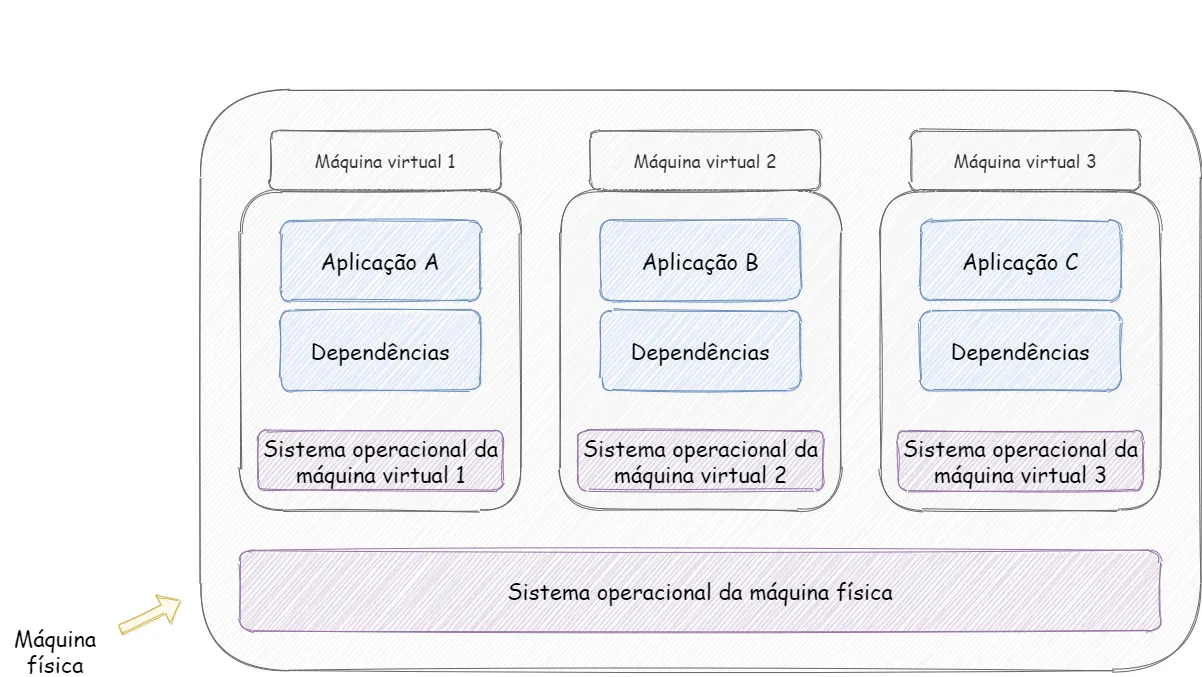
Máquinas virtuais: cada uma carrega um sistema operacional completo.
Do ponto de vista de isolamento e distribuição de aplicações com dependências e suas versões garantidas, as máquinas virtuais resolvem o problema tão bem quanto os contêineres. Entretanto, seu uso traz algumas desvantagens.
- Código duplicado, especialmente dos sistemas operacionais.
- Desperdício de espaço.
- Potencial perda de desempenho.
Usando o Docker, o equivalente da figura anterior é exibido na figura a seguir.
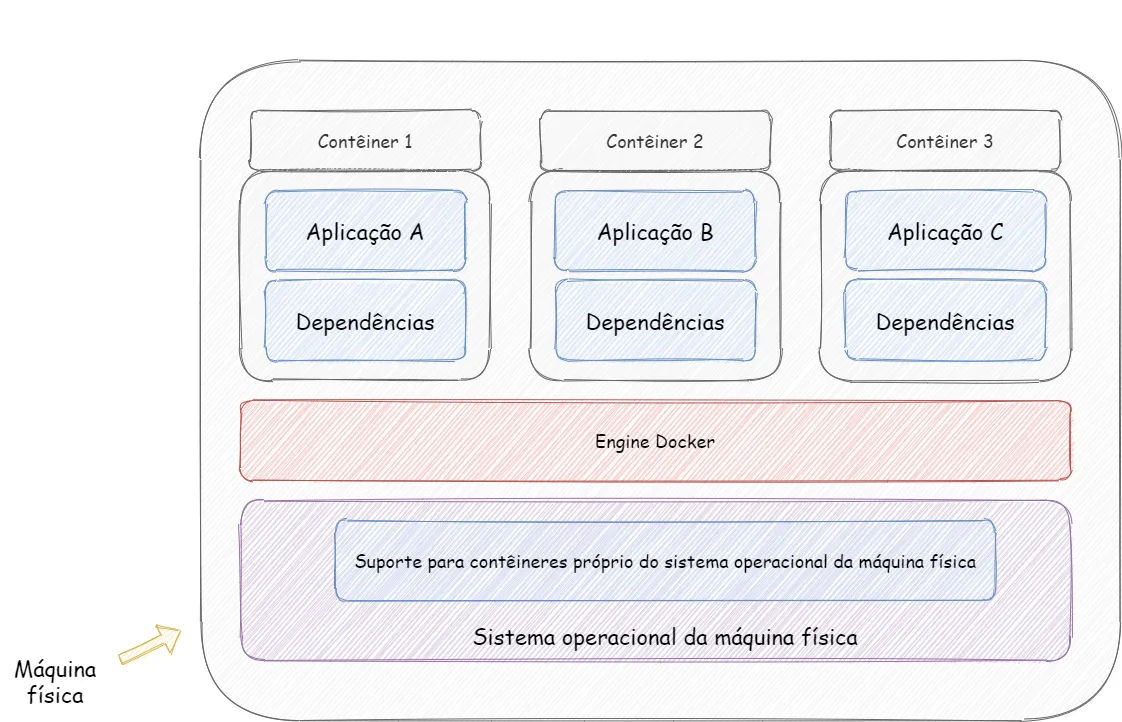
Contêineres compartilham o sistema operacional da máquina física por meio do Engine Docker.
Algumas considerações importantes observadas na figura.
- O engine do Docker é significativamente mais "leve" quando comparado a uma máquina virtual.
- Cada contêiner pode, de fato, ter partes de um sistema operacional nele presentes. Entretanto, nada comparado a um sistema operacional completo.
12. Obtendo o Docker
Há versões do Docker para Linux, MacOS e Windows. Visite https://www.docker.com/products/docker-desktop e obtenha o Docker Desktop caso esteja utilizando Windows ou MacOS. Quando terminar, use
Terminal
docker version
para testar a instalação. É importante entender quais são as principais ferramentas envolvidas.
- Docker Engine viabiliza a execução de contêineres.
- Docker CLI é um cliente de linha de comando por meio do qual pode-se interagir com o Docker, como o nome sugere, pela linha de comando.
- Docker Compose é uma ferramenta que viabiliza a execução de aplicações que utilizam múltiplos contêineres. Basta um arquivo YAML em que os serviços são configurados para que, a seguir, com um único comando, eles possam ser executados.
- Kubernetes é uma plataforma que gerencia serviços executados por contêineres. Ele é capaz de disponibilizar acesso a múltiplos serviços por meio de um único endereço e operar como um balanceador de carga. Além disso, também é capaz de reiniciar contêineres, substituir contêineres, entre muitas outras funcionalidades. (Pronúncia e origem da palavra Kubernetes: https://www.youtube.com/watch?v=uMA7qqXIXBk.)
- Docker Desktop é um pacote que inclui o Docker Engine, o Docker CLI, o Docker Compose e o Kubernetes.
- Docker Hub é um repositório de imagens Docker.
13. Hello, Docker!
Nesta seção, construiremos uma pequena aplicação com Node.js com o intuito de entender as partes mais fundamentais do Docker.
Crie uma nova pasta em seu workspace e execute
Terminal
npm init -y
para criar um projeto Node.js. A seguir, execute
Terminal
npm install express
para instalar o pacote Express. Caso utilize o VS Code, pode ser interessante instalar a extensão Docker. Ela é desenvolvida pela própria Microsoft. Para fazer a sua instalação, clique no ícone de extensões e busque por docker. A seguir, clique install. Veja a figura a seguir.
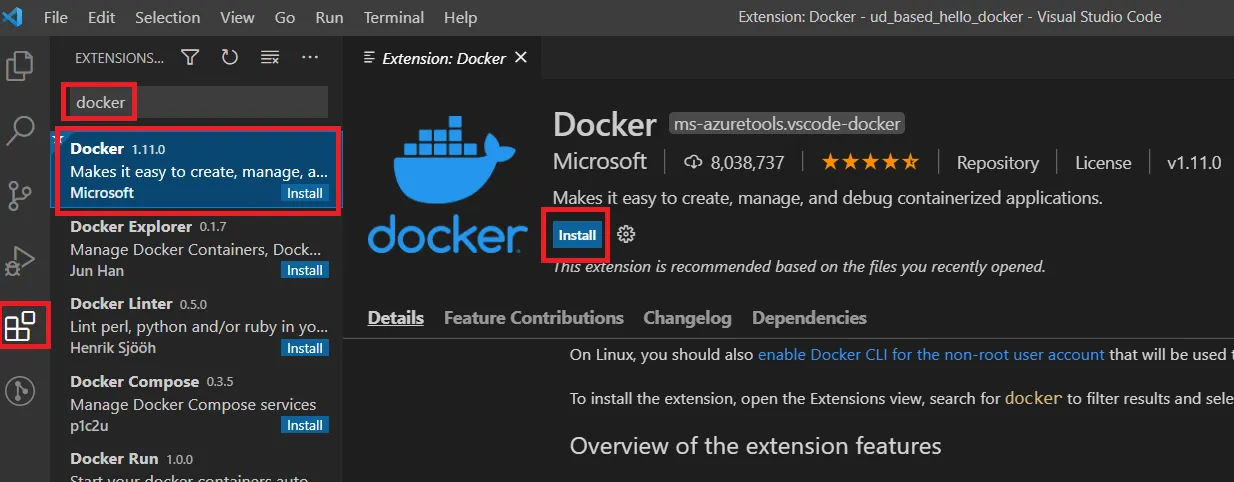
Instalando a extensão Docker no VS Code.
Crie um arquivo chamado index.js. Seu conteúdo aparece a seguir.
index.js
const express = require("express");
const app = express();
app.use(express.json());

app.get("/hey-docker", (req, res) => {
  res.status(200).json({
    mensagem: "Hey, Docker!!",
  });
});
app.listen(5200, () => console.log("up and running inside docker"));
O próximo passo é criar um arquivo chamado Dockerfile, sem extensão alguma. Nele podemos descrever uma imagem Docker. Ou seja, os arquivos, ferramentas etc que desejamos que estejam disponíveis quando um contêiner Docker for colocado em execução em função dela. Pense em uma imagem Docker como uma classe, uma descrição. Por outro lado, pense em um contêiner Docker como um objeto construído a partir desta classe. Veja o conteúdo do arquivo Dockerfile.
Dockerfile
#comentários são feitos com #
#desde que # seja o primeiro símbolo na linha
#essa linguagem não é case sensitive
#mas é boa prática usar maiúsculas para diferenciar comandos de argumentos
#queremos uma imagem com o node versão 14
FROM node:14

# um diretório no sistema de arquivos do contêiner para os comandos a seguir
WORKDIR /app

#copiamos o package.json para poder executar npm install
COPY package.json .

#executamos npm install

RUN npm install

#copiamos os demais arquivos
COPY . .

#tornamos o contêiner disponível na porta 5200
EXPOSE 5200

#colocamos o aplicativo em execução
CMD ["node", "index.js"]
O ícone do Docker na "system tray" indica que ele está em execução.
A seguir, use
Terminal
docker build .
para construir a imagem. O símbolo "." indica o diretório em que se encontra o arquivo Dockerfile. Uma vez construída a imagem, você verá um feedback textual parecido com aquele exibido pela figura a seguir.
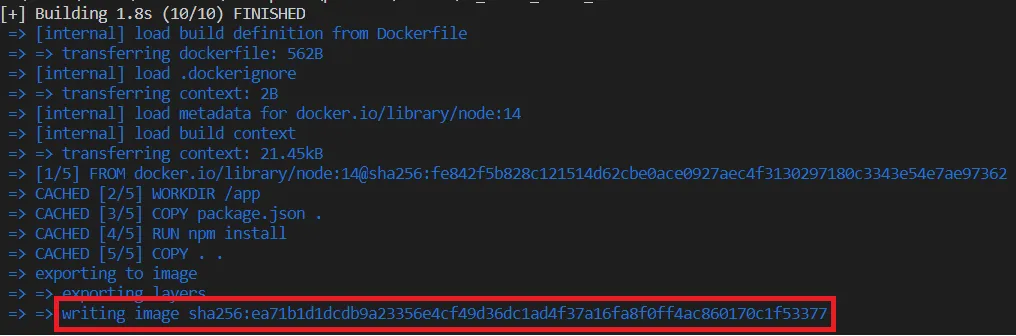
Saída do docker build: a última linha mostra o identificador da imagem.
A última linha, destacada na figura, mostra o identificador da imagem gerada. Neste exemplo, ele é igual a
ea71b1d1dcdb9a23356e4cf49d36dc1ad4f37a16fa8f0ff4ac860170c1f53377
Ele pode ser usado para colocar a imagem em execução. Para isso, use
Terminal
docker run -p 5200:5200 ea71b1d1dcdb
Basta usar os 12 primeiros caracteres. Especificamos duas portas: primeiro dizemos qual a porta do computador host para a qual as requisições serão enviadas. A seguir, especificamos qual a porta do contêiner para a qual elas devem ser direcionadas. Faça um teste usando um cliente HTTP (como o seu navegador ou o Postman) visitando
http://localhost:5200/hey-docker
Cada contêiner colocado em execução recebe um nome automático. Use
Terminal
docker ps
para verificar o nome do seu. Veja o resultado esperado a seguir; o nome aparece na coluna NAMES.
Terminal
CONTAINER ID   IMAGE          COMMAND                  CREATED          STATUS          PORTS                    NAMES
d96c092ff53c   ea71b1d1dcdb   "docker-entrypoint.s…"   17 minutes ago   Up 17 minutes   0.0.0.0:5200->5200/tcp   clever_turing
Para encerrar a sua execução, use
Terminal
docker stop nome_do_conteiner
14. Comandos Docker
O Docker possui diversos comandos que podem ser úteis.
| Comando | Descrição |
|---|---|
docker build -t tag_para_o_conteiner . |
Cria uma imagem e associa a ela a tag tag_para_o_conteiner. O "." ao final indica o diretório em que se encontra o arquivo Dockerfile. |
docker run [id ou tag] |
Um contêiner pode ser colocado em execução por meio de seu id e por meio de sua tag. |
docker run -it [id ou tag] [novo_comando] |
Coloca um contêiner em execução substituindo o comando padrão por novo_comando. |
docker ps |
Traz informações sobre todos os contêineres ativos no momento. |
docker exec -it id comando |
Executa um comando em um contêiner que já está em execução. Exemplo: docker exec -it id sh coloca um "shell" em execução dentro do contêiner. |
docker logs id |
Exibe os logs do contêiner cujo id foi especificado. |
docker help |
Exibe os comandos Docker disponíveis. |
docker comando --help |
Exibe as opções do comando especificado. Exemplo: docker build --help. |
docker images |
Lista informações sobre as imagens existentes. |
15. Os microsserviços no Docker
Implantando o microsserviço de lembretes com Docker
Para colocar o microsserviço de lembretes em execução, crie um arquivo Dockerfile (sem extensão) no seu diretório raiz (mesmo diretório em que se encontra o arquivo package.json). Veja o seu conteúdo a seguir.
lembretes/Dockerfile
#alpine: imagem Linux "pequena"
FROM node:alpine

# um diretório no sistema de arquivos do contêiner para os comandos a seguir
WORKDIR /app

#copia o arquivo package.json para poder executar npm install
COPY package.json .

#instala as dependências
RUN npm install

#copia todo o conteúdo .local para a imagem
COPY . .

#executa quando o contêiner entrar em execução
CMD ["npm", "start"]
O comando COPY está copiando todo o conteúdo do diretório local para o sistema de arquivos da imagem. Entretanto, a pasta node_modules não é de interesse já que o comando npm install é executado quando a imagem é criada. Além disso, pode ser que existam dependências locais necessárias somente em tempo de desenvolvimento que não são necessárias em tempo de execução. Por isso, vamos criar um arquivo chamado .dockerignore e especificar que node_modules não deve ser copiada. Ele precisa ficar no diretório em que o comando build será executado. Neste caso, no mesmo diretório em que se encontra o arquivo Dockerfile. Veja a figura a seguir.
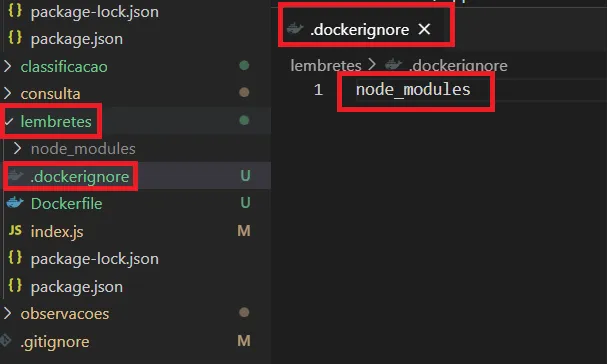
O arquivo .dockerignore na pasta do microsserviço de lembretes.
O conteúdo do arquivo .dockerignore é
lembretes/.dockerignore
node_modules
ou seja, o nome da pasta que não deve ser copiada para a imagem. Construa a imagem com
Terminal (pasta lembretes)
docker build .
Se desejar, use
Terminal (pasta lembretes)
docker build -t mss-lembretes .
para associar a tag mss-lembretes à imagem. Lembre-se de pegar o seu id assim que a execução do comando terminar. Também é possível pegar o id na interface gráfica do Docker, que pode ser aberta clicando-se no ícone na "system tray" do sistema operacional. Veja a figura a seguir.
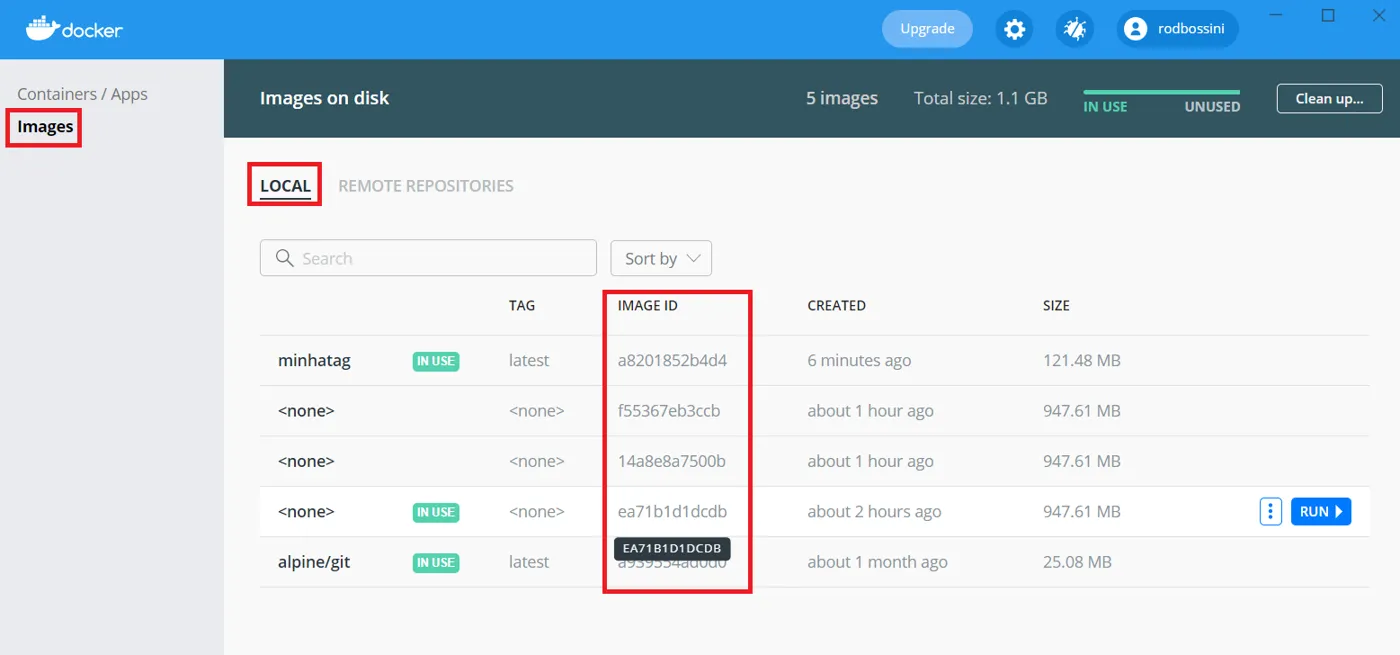
O id das imagens na interface gráfica do Docker Desktop.
A seguir, coloque um contêiner em execução com
Terminal
docker run -p 4000:4000 id_da_imagem
Testando o microsserviço de lembretes com Docker
Neste instante, já é possível enviar requisições ao microsserviço de lembretes por meio de http://localhost:4000/lembretes. Entretanto, note que os demais microsserviços não estão em execução. Isso quer dizer que um erro será gerado. Faça uma requisição com o Postman e use
Terminal
docker logs id_do_conteiner
para verificar as mensagens de erro. Você também pode usar
Terminal
docker ps
para pegar o id de cada contêiner em execução e então usar
Terminal
docker logs id_do_conteiner
para cada um deles.
Implantando os demais microsserviços com Docker
Repita o processo para colocar os demais microsserviços em execução usando o Docker. Os arquivos Dockerfile e .dockerignore são iguais. Basta copiá-los para as pastas de cada microsserviço. A seguir, use (cada comando na pasta do respectivo microsserviço)
Terminal
docker build -t mss-observacoes .
docker build -t mss-consulta .
docker build -t mss-classificacao .
docker build -t mss-barramento-de-eventos .
Assim você terá construído uma imagem para cada microsserviço. Na interface gráfica do Docker, o resultado deve ser parecido com aquele exibido pela figura a seguir.
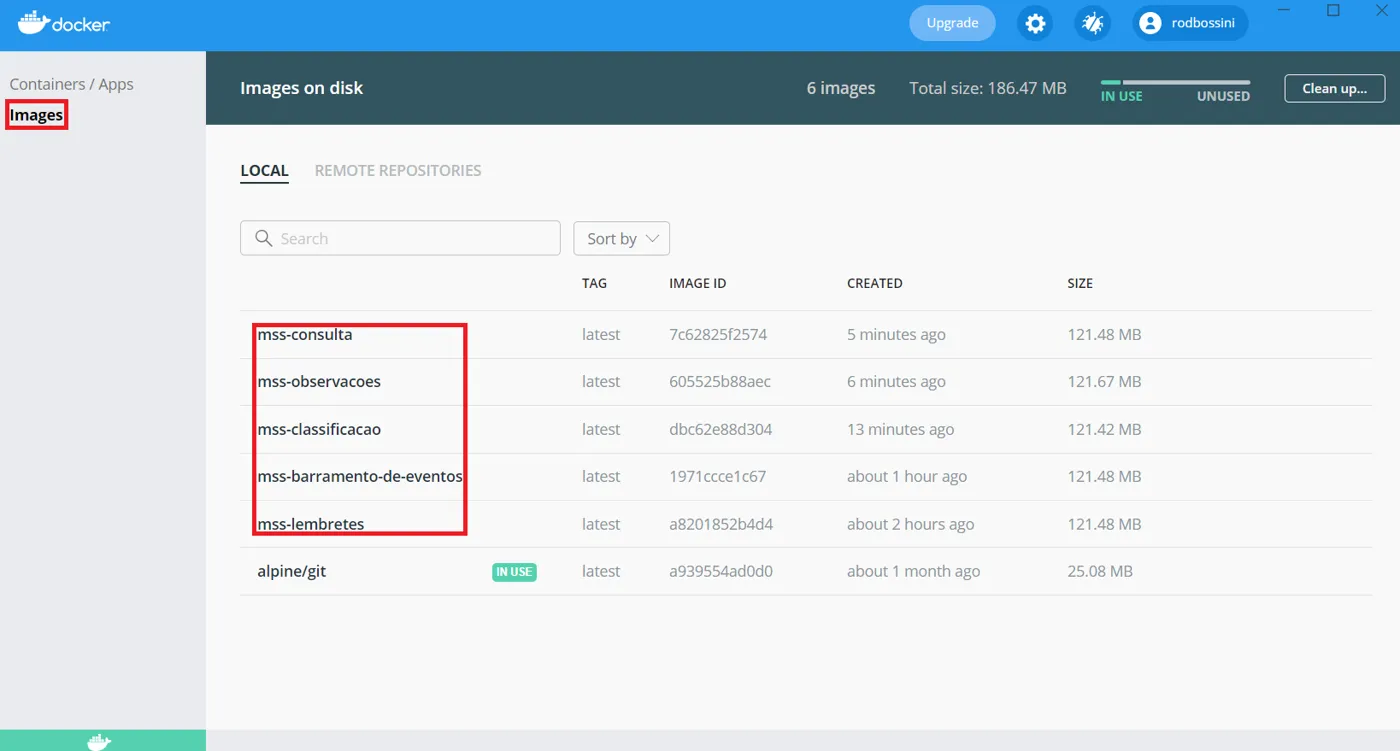
Uma imagem para cada microsserviço.
Testando os demais microsserviços com Docker
Use
Terminal
#importante subir o barramento antes dos demais
#pois ele é consultado por eles
docker run -p 10000:10000 mss-barramento-de-eventos
docker run -p 4000:4000 mss-lembretes
docker run -p 5000:5000 mss-observacoes
docker run -p 6000:6000 mss-consulta
docker run -p 7000:7000 mss-classificacao
para colocar todos os microsserviços em execução, cada qual em um contêiner separado. Abra o Postman e realize alguns testes.
16. Encerramento da parte 2
Parabéns! Você concluiu a parte 2. Até aqui você:
- avaliou alternativas de arquitetura e implementou o microsserviço de classificação com o fluxo de eventos
ObservacaoCriada,ObservacaoClassificadaeObservacaoAtualizada; - fez os microsserviços ignorarem eventos que não lhes interessam;
- tratou eventos perdidos armazenando eventos no barramento;
- comparou estratégias de implantação;
- criou imagens Docker e executou cada microsserviço em seu próprio contêiner.
Próximo passo
Continue na parte 3 (codelab mss-microsservicos-parte-3, Microsserviços, parte 3: orquestração com Kubernetes), em que você conhece a arquitetura do Kubernetes, pratica com o kubectl, cria Deployments e Services com arquivos de configuração, publica imagens no Docker Hub e faz os microsserviços se comunicarem dentro do cluster.