O protocolo HTTP: entendendo a comunicação na Web
Entenda como a comunicação na Web funciona com o protocolo HTTP: modelo cliente–servidor, anatomia de requisições e respostas, códigos de status, métodos GET, POST, PUT, PATCH e DELETE, URLs, a natureza stateless e o HTTPS.
1. Visão geral
O HTTP (Hypertext Transfer Protocol) é a "língua" que navegadores, servidores e APIs usam para conversar na Web. Neste codelab você entende, do zero, como essa conversa acontece: quem pede, quem responde, como as mensagens são escritas e o que cada parte significa.
O que você vai aprender
- O que é a Internet e o que é um protocolo
- O modelo cliente–servidor e por que cliente e servidor são papéis exercidos por software
- A origem do HTTP e como ele funciona (modelo requisição–resposta)
- A anatomia de uma requisição e de uma resposta HTTP
- Os códigos de status e suas faixas
- Os métodos GET, POST, PUT, PATCH e DELETE, com exemplos completos
- As partes de uma URL
- O que significa o HTTP ser stateless e a diferença entre HTTP e HTTPS
O que você vai precisar
- Apenas um navegador e curiosidade: este é um codelab conceitual
2. A Internet: uma rede de redes
A Internet é uma gigantesca rede mundial que conecta bilhões de dispositivos. Computadores, celulares, tablets, servidores e até geladeiras inteligentes podem trocar informações entre si por meio dessa rede.
No fundo, a Internet é uma infraestrutura de comunicação: cabos submarinos, fibras ópticas, torres de celular e satélites que transportam dados de um ponto a outro do planeta. Mas o que nos interessa agora é entender como dois programas se comunicam usando essa infraestrutura.
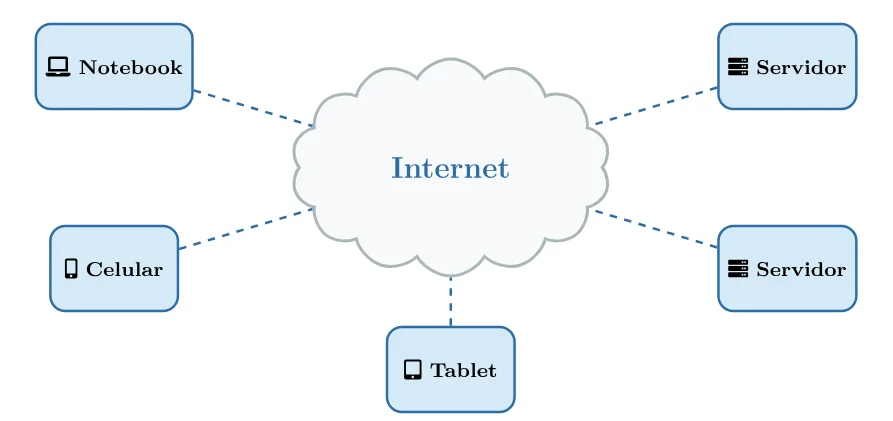
A Internet conecta dispositivos de todos os tipos.
Quando você abre um site no navegador, o seu computador está se comunicando com outro computador (um servidor) que pode estar do outro lado do mundo. Essa comunicação acontece por meio de protocolos: regras que ambos os lados combinam de seguir para que a conversa funcione.
Protocolo
Um protocolo é um conjunto de regras que define como dois sistemas devem trocar informações. Assim como as pessoas seguem convenções sociais para conversar (cumprimentar, esperar a vez, despedir-se), os computadores seguem protocolos para se comunicarem de forma organizada.
3. Clientes e servidores
Na Web, a comunicação segue um modelo chamado cliente–servidor. Funciona assim:
- O cliente é o programa que faz pedidos (requisições). Exemplo: o navegador.
- O servidor é o programa que responde aos pedidos. Exemplo: o Apache, o Nginx ou o Express.
O cliente envia uma requisição e o servidor devolve uma resposta. Sempre nessa ordem: primeiro o cliente pede, depois o servidor responde.
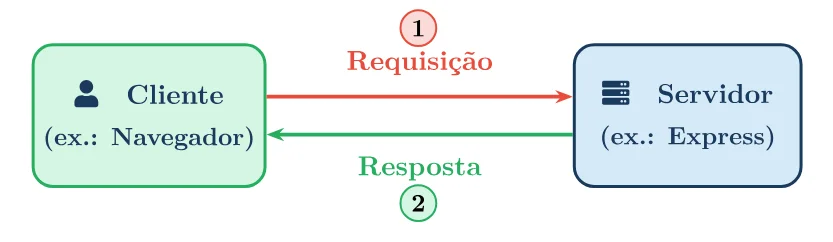
O modelo cliente–servidor.
O fluxo é sempre o mesmo: (1) o cliente envia uma requisição e (2) o servidor devolve uma resposta. Esse modelo é a base de toda a comunicação na Web.
Cliente e servidor são software!
Um ponto fundamental que muitas vezes gera confusão: quando dizemos cliente e servidor, estamos nos referindo a programas de computador (software), e não necessariamente a máquinas físicas diferentes.
Por exemplo, quando um desenvolvedor trabalha em uma aplicação React com Vite, o navegador (cliente) e o servidor de desenvolvimento do Vite (servidor) executam no mesmo computador. A figura a seguir ilustra esse cenário.
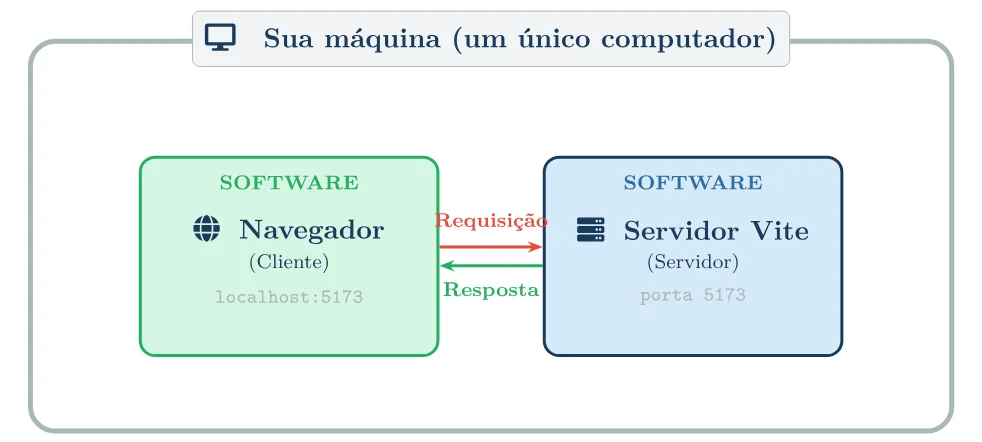
Cliente e servidor executando na mesma máquina.
Perceba que ambos os programas estão dentro do mesmo computador. O navegador acessa o endereço localhost:5173, que significa "conecte-se a esta mesma máquina, na porta 5173".
4. O que é HTTP?
Origem e significado
A sigla HTTP significa HyperText Transfer Protocol (Protocolo de Transferência de Hipertexto). Ele foi criado por Tim Berners-Lee no início da década de 1990, no laboratório CERN (Organização Europeia para a Pesquisa Nuclear), na Suíça. O HTTP nasceu junto com a própria World Wide Web (WWW) e tinha um objetivo claro: permitir que documentos de hipertexto fossem transferidos pela rede.
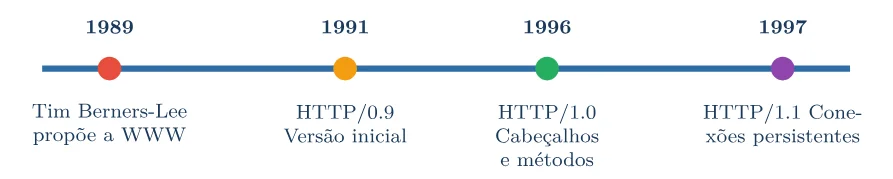
A evolução inicial do HTTP.
A primeira versão do HTTP era extremamente simples: o cliente enviava apenas o caminho do documento desejado, e o servidor respondia com o conteúdo. Com o tempo, o protocolo evoluiu para suportar cabeçalhos, diferentes métodos, códigos de status e muito mais.
O que é Hipertexto?
Hipertexto é um texto que contém links para outros textos. Quando você clica em um link em uma página web, está navegando por hipertexto. O formato mais comum de hipertexto na Web é o HTML (HyperText Markup Language).
Como funciona o HTTP?
O HTTP é um protocolo baseado em texto e segue o modelo requisição–resposta:
- O cliente envia uma requisição em formato textual ao servidor.
- O servidor interpreta essa requisição e devolve uma resposta, também em formato textual.
- Cada requisição é independente das anteriores (o HTTP é stateless).
A figura a seguir mostra uma visão geral de como ficam escritas uma requisição e uma resposta HTTP.
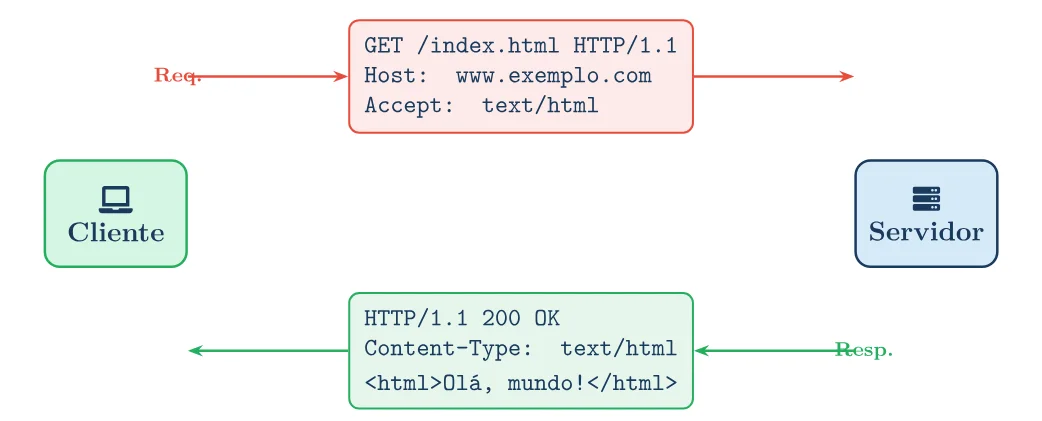
Uma requisição e uma resposta HTTP.
Observe que tanto a requisição quanto a resposta são compostas por texto legível. Essa é uma das características que torna o HTTP relativamente fácil de entender e depurar.
5. Anatomia de requisições e respostas
Anatomia de uma requisição HTTP
Toda requisição HTTP é composta por três partes: a linha de requisição, os cabeçalhos e, opcionalmente, o corpo. A figura a seguir apresenta essa estrutura visualmente.
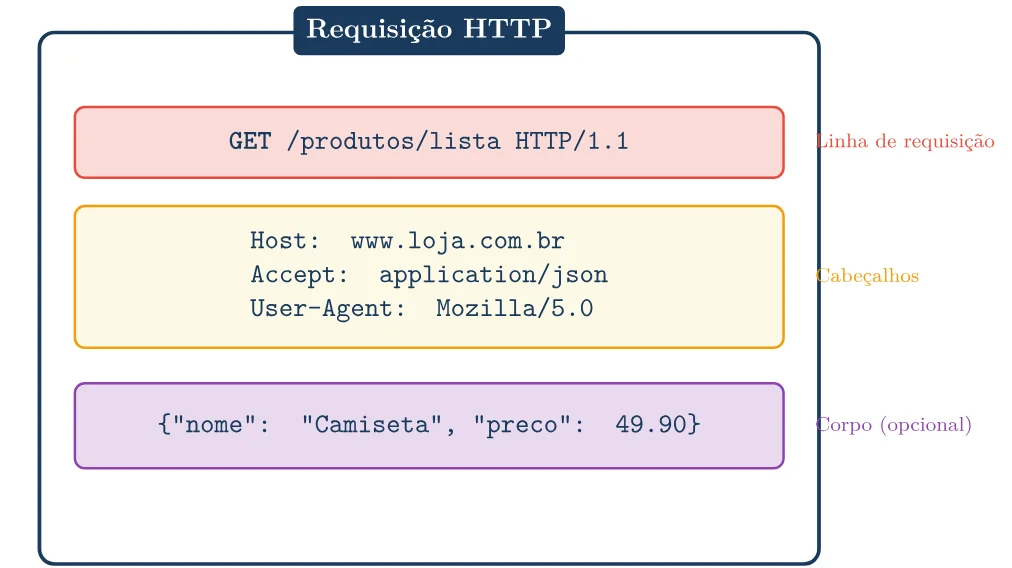
As partes de uma requisição HTTP.
Requisição HTTP
GET /produtos/lista HTTP/1.1
Host: www.loja.com.br
Accept: application/json
User-Agent: Mozilla/5.0

{"nome": "Camiseta", "preco": 49.90}
- Linha de requisição — contém o método HTTP (o que se deseja fazer), o caminho do recurso e a versão do protocolo.
- Cabeçalhos (headers) — pares chave-valor que fornecem informações extras: o tipo de conteúdo aceito, o endereço do servidor, dados sobre o navegador etc.
- Corpo (body) — contém os dados enviados ao servidor. É opcional e geralmente está presente em métodos como POST e PUT.
Anatomia de uma resposta HTTP
A resposta segue uma estrutura semelhante.
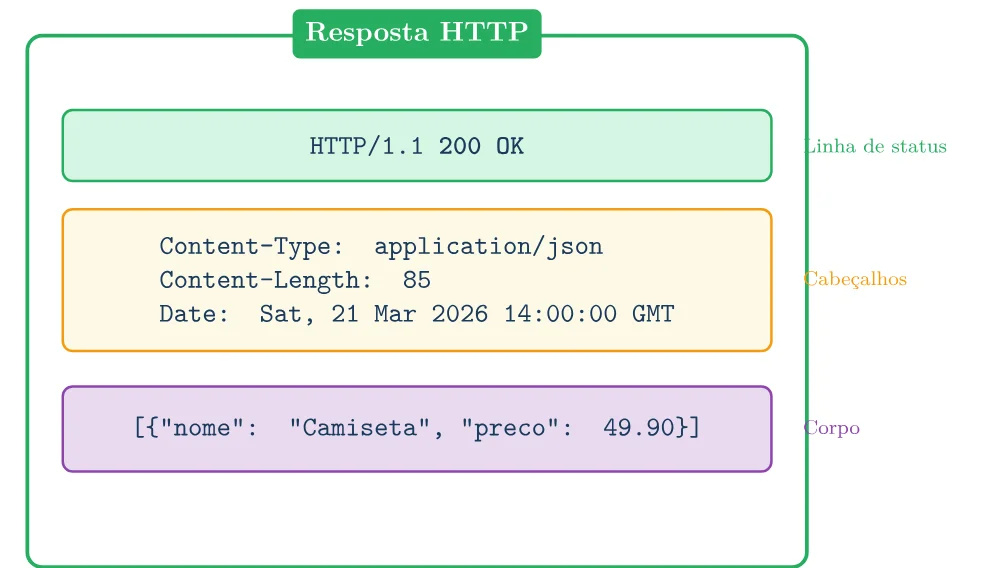
As partes de uma resposta HTTP.
Resposta HTTP
HTTP/1.1 200 OK
Content-Type: application/json
Content-Length: 85
Date: Sat, 21 Mar 2026 14:00:00 GMT

[{"nome": "Camiseta", "preco": 49.90}]
A diferença principal é que a primeira linha agora contém a linha de status, com um código numérico (200, 404, 500 etc.) que indica se a requisição foi bem-sucedida ou não.
6. Códigos de status HTTP
Toda resposta HTTP contém um código de status de três dígitos. Esse código indica ao cliente o resultado da requisição. Os códigos são organizados em cinco faixas.
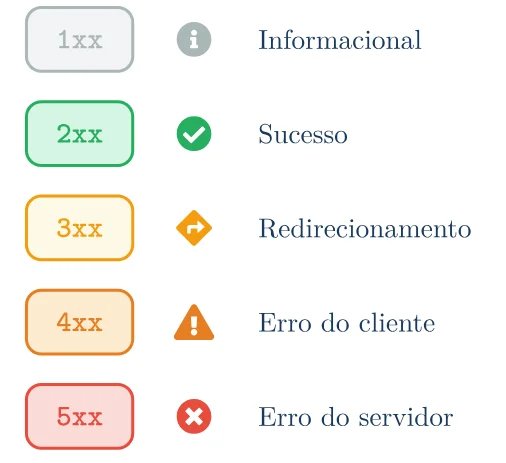
As cinco faixas de códigos de status.
A tabela a seguir apresenta os códigos mais comuns no dia a dia.
| Código | Nome | Significado |
|---|---|---|
200 |
OK | Requisição bem-sucedida. |
201 |
Created | Recurso criado com sucesso (usado com POST). |
204 |
No Content | Sucesso, mas sem conteúdo na resposta (usado com DELETE). |
301 |
Moved Permanently | O recurso mudou de endereço. |
400 |
Bad Request | Requisição com dados inválidos. |
401 |
Unauthorized | Autenticação necessária. |
403 |
Forbidden | Acesso negado, mesmo autenticado. |
404 |
Not Found | Recurso não encontrado. |
500 |
Internal Server Error | Erro interno do servidor. |
7. Os métodos HTTP
O método HTTP indica a ação que o cliente deseja realizar. A tabela a seguir resume os cinco métodos mais utilizados.
| Método | Descrição | Envia corpo? |
|---|---|---|
GET |
Solicita a leitura de um recurso. | Não |
POST |
Envia dados para criar um novo recurso. | Sim |
PUT |
Substitui completamente um recurso existente. | Sim |
PATCH |
Atualiza parcialmente um recurso existente. | Sim |
DELETE |
Solicita a remoção de um recurso. | Geralmente não |
A seguir, veremos cada método em detalhes, com exemplos que mostram a requisição e a resposta completas.
Resumo visual — a analogia da estante de livros
Imagine que o servidor é uma estante de livros e cada livro é um recurso.
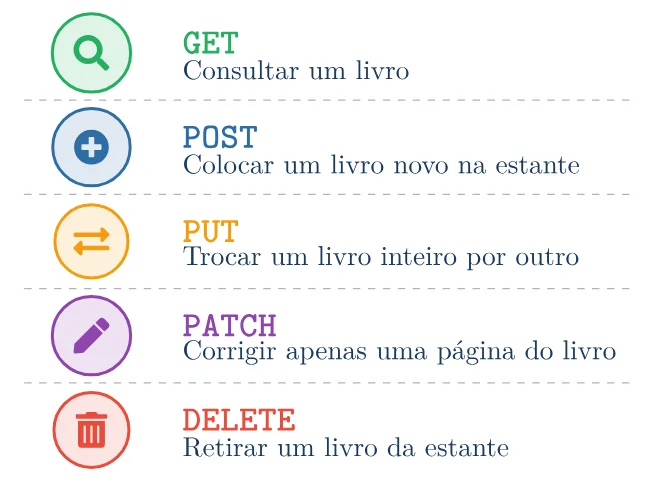
Os métodos HTTP como ações sobre uma estante de livros.
8. GET e POST
GET — buscando informações
O método GET é usado para ler informações. É o mais comum: toda vez que você digita uma URL e pressiona Enter, um GET é enviado.
(1) Requisição do cliente
GET /usuarios/42 HTTP/1.1
Host: api.exemplo.com
Accept: application/json
(2) Resposta do servidor
HTTP/1.1 200 OK
Content-Type: application/json

{"id": 42, "nome": "Ana"}
O cliente solicita os dados do usuário com identificador 42. O servidor responde com 200 OK e o conteúdo em formato JSON. Observe que a requisição GET não possui corpo.
POST — criando novos recursos
O método POST é usado para enviar dados ao servidor e criar algo novo (cadastrar um usuário, enviar um formulário etc.).
(1) Requisição do cliente
POST /usuarios HTTP/1.1
Host: api.exemplo.com
Content-Type: application/json

{"nome": "Carlos",
  "email": "carlos@email.com"}
(2) Resposta do servidor
HTTP/1.1 201 Created
Content-Type: application/json

{"id": 43, "nome": "Carlos"}
A requisição possui um corpo com os dados do novo usuário. O servidor responde com 201 Created, indicando que o recurso foi criado com sucesso, e devolve os dados (incluindo o id gerado automaticamente).
9. PUT, PATCH e DELETE
PUT — substituindo um recurso
O método PUT substitui integralmente um recurso existente. O corpo da requisição deve conter todos os campos do recurso, mesmo os que não mudaram.
(1) Requisição do cliente
PUT /usuarios/43 HTTP/1.1
Host: api.exemplo.com
Content-Type: application/json

{"nome": "Carlos Silva", "email": "carlos@email.com"}
(2) Resposta do servidor
HTTP/1.1 200 OK
Content-Type: application/json

{"id": 43, "nome": "Carlos Silva"}
O nome do usuário 43 é atualizado de "Carlos" para "Carlos Silva". Note que todos os campos são enviados, inclusive o email que não mudou.
PATCH — atualizando parcialmente
O PATCH é semelhante ao PUT, mas atualiza apenas os campos enviados no corpo. Não é necessário enviar todos os dados.
(1) Requisição do cliente
PATCH /usuarios/43 HTTP/1.1
Host: api.exemplo.com
Content-Type: application/json

{"email": "novo@email.com"}
(2) Resposta do servidor
HTTP/1.1 200 OK
Content-Type: application/json

{"id": 43, "nome": "Carlos Silva", "email": "novo@email.com"}
Apenas o campo email é enviado. O servidor atualiza somente esse campo e retorna o recurso completo atualizado.
DELETE — removendo recursos
O DELETE solicita a remoção de um recurso no servidor.
(1) Requisição do cliente
DELETE /usuarios/43 HTTP/1.1
Host: api.exemplo.com
(2) Resposta do servidor
HTTP/1.1 204 No Content
A requisição DELETE geralmente não possui corpo. O servidor responde com 204 No Content, indicando que o recurso foi removido e não há conteúdo a retornar.
10. URLs e recursos
Cada "coisa" que o servidor disponibiliza (um usuário, um produto, uma imagem) é chamada de recurso. Para acessar um recurso, usamos uma URL (Uniform Resource Locator). A figura a seguir mostra as partes de uma URL.
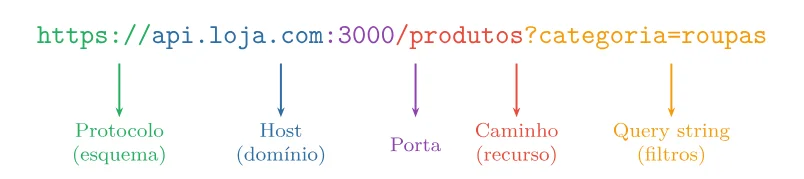
As partes de uma URL.
- Protocolo — define como a comunicação acontece (
httpouhttps). - Host — o endereço do servidor.
- Porta — o "número da porta" do servidor (opcional; o padrão do HTTP é 80 e o do HTTPS é 443).
- Caminho — identifica o recurso desejado no servidor.
- Query string — parâmetros extras para filtrar ou configurar a requisição.
11. Stateless e HTTPS
HTTP é sem estado (stateless)
Uma característica essencial do HTTP é que ele é sem estado (stateless). Isso significa que cada requisição é independente: o servidor não guarda nenhuma informação sobre requisições anteriores.
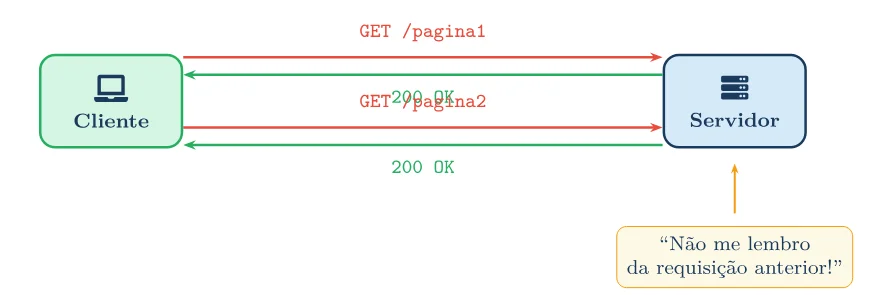
Para o servidor, cada requisição é independente.
Para o servidor, cada requisição é como se fosse a primeira vez que o cliente fala com ele. Isso traz vantagens (simplicidade, escalabilidade), mas também desafios — por exemplo, como manter um usuário "logado" se o servidor não lembra das requisições anteriores?
HTTP vs. HTTPS
O HTTPS é a versão segura do HTTP. A letra "S" vem de Secure. A diferença é que o HTTPS adiciona uma camada de criptografia (usando TLS/SSL) sobre a comunicação, protegendo os dados contra interceptação.
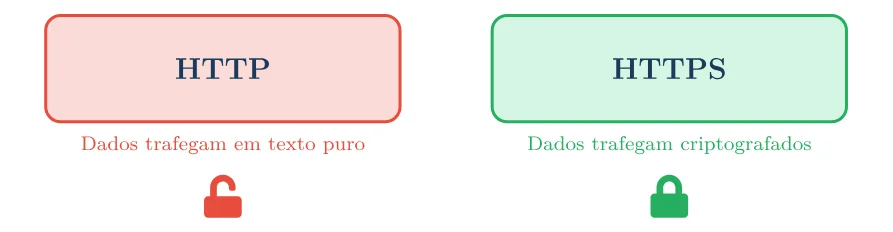
HTTP e HTTPS.
Atualmente, o HTTPS é o padrão recomendado para qualquer site. Navegadores como o Chrome exibem um aviso de "Não seguro" para sites que ainda usam HTTP puro.
12. HTTP na prática e resumo
Um exemplo completo
Para consolidar tudo o que aprendemos, vamos acompanhar o que acontece quando você digita https://www.google.com no navegador e pressiona Enter.
- Você digita
https://www.google.come pressiona Enter. - O navegador descobre o endereço IP do servidor (DNS).
- Uma conexão segura (TLS/SSL) é estabelecida.
- O navegador envia:
GET / HTTP/1.1 | Host: www.google.com - O servidor responde:
HTTP/1.1 200 OK+ HTML da página. - O navegador interpreta o HTML e renderiza a página na tela.
Tudo isso acontece em frações de segundo. O HTTP é a "língua" que o navegador e o servidor usam para se entender — e agora você sabe como essa conversa funciona!
Resumo visual
A figura a seguir sintetiza os conceitos principais abordados neste material.
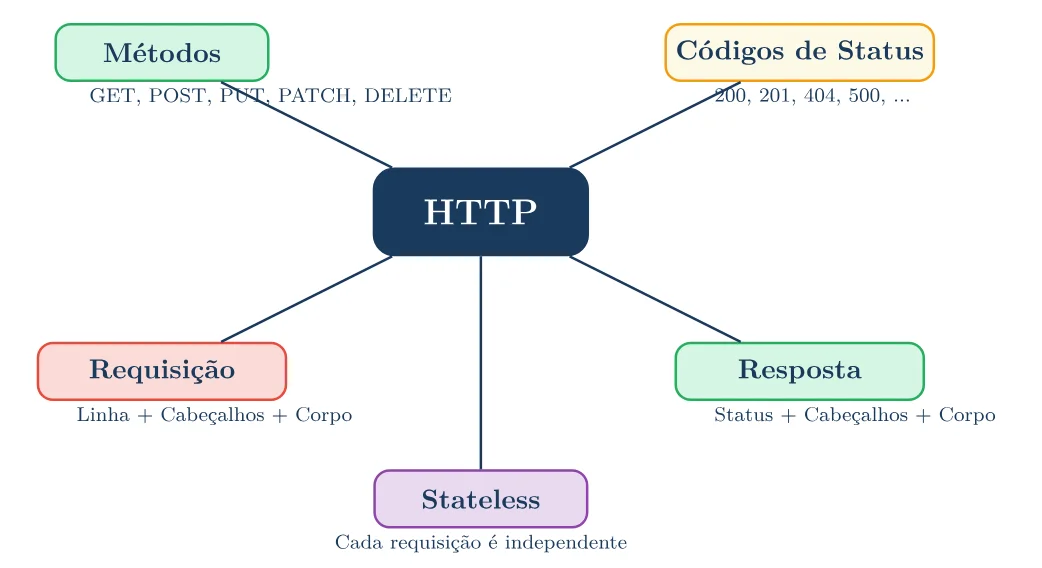
Os conceitos principais do HTTP.
13. Encerramento
Parabéns! Agora você entende o modelo cliente–servidor, a estrutura das mensagens HTTP, os códigos de status, os métodos, as URLs, a natureza stateless do protocolo e o papel do HTTPS. Esses conceitos são a base para construir e consumir APIs e microsserviços.
Referências
- BERNERS-LEE, T. Information Management: A Proposal. CERN, 1989. Disponível em https://www.w3.org/History/1989/proposal.html. Acesso em março de 2026.
- MDN WEB DOCS. An overview of HTTP. 2024. Disponível em https://developer.mozilla.org/en-US/docs/Web/HTTP/Overview. Acesso em março de 2026.
- MDN WEB DOCS. HTTP request methods. 2024. Disponível em https://developer.mozilla.org/en-US/docs/Web/HTTP/Methods. Acesso em março de 2026.
- MDN WEB DOCS. HTTP response status codes. 2024. Disponível em https://developer.mozilla.org/en-US/docs/Web/HTTP/Status. Acesso em março de 2026.
- RFC 2616. Hypertext Transfer Protocol – HTTP/1.1. 1999. Disponível em https://datatracker.ietf.org/doc/html/rfc2616. Acesso em março de 2026.