GraphQL: mutations de remoção e organização do projeto
Implemente mutations de remoção de pessoas, livros e comentários (com remoção em cascata) e reorganize a API GraphQL em arquivos: schema.graphql, db.js, o objeto context e um arquivo por tipo de resolver.
1. Visão geral
Até então, estudamos a operação query e começamos a trabalhar com a operação mutation, que permite realizar as demais operações de um CRUD básico: inserção, atualização e remoção. Neste material, implementamos as remoções e reorganizamos a aplicação em arquivos menores.
O que você vai aprender
- Definir mutations de remoção e seus resolvers
- Usar o método
splicede arrays JavaScript - Remover dados relacionados em cascata (livros e comentários de uma pessoa, comentários de um livro)
- Mover o schema para um arquivo
schema.graphqle lê-lo com o módulofs - Fazer o nodemon observar arquivos
.graphql - Separar a base de dados em
db.jse compartilhá-la com os resolvers pelo objeto context - Separar os resolvers em um arquivo por tipo
O que você vai precisar
- O projeto do codelab "GraphQL: mutations e o tipo input"
- Node.js e um editor de código
2. Projeto da aula anterior e o modelo
Abra um terminal e navegue até o diretório do projeto. Use o comando a seguir para abri-lo no VS Code.
Terminal
code .
A seguir, coloque o servidor em execução com
Terminal
npm run start
Lembre-se que o script start está configurado para executar o nodemon, responsável pelo live reload feito quando atualizamos os arquivos da aplicação.
O modelo da aplicação que estamos utilizando é aquele exibido pela figura a seguir. Lembre-se que no projeto feito até então, as operações Query implementam os relacionamentos em modo bidirecional.
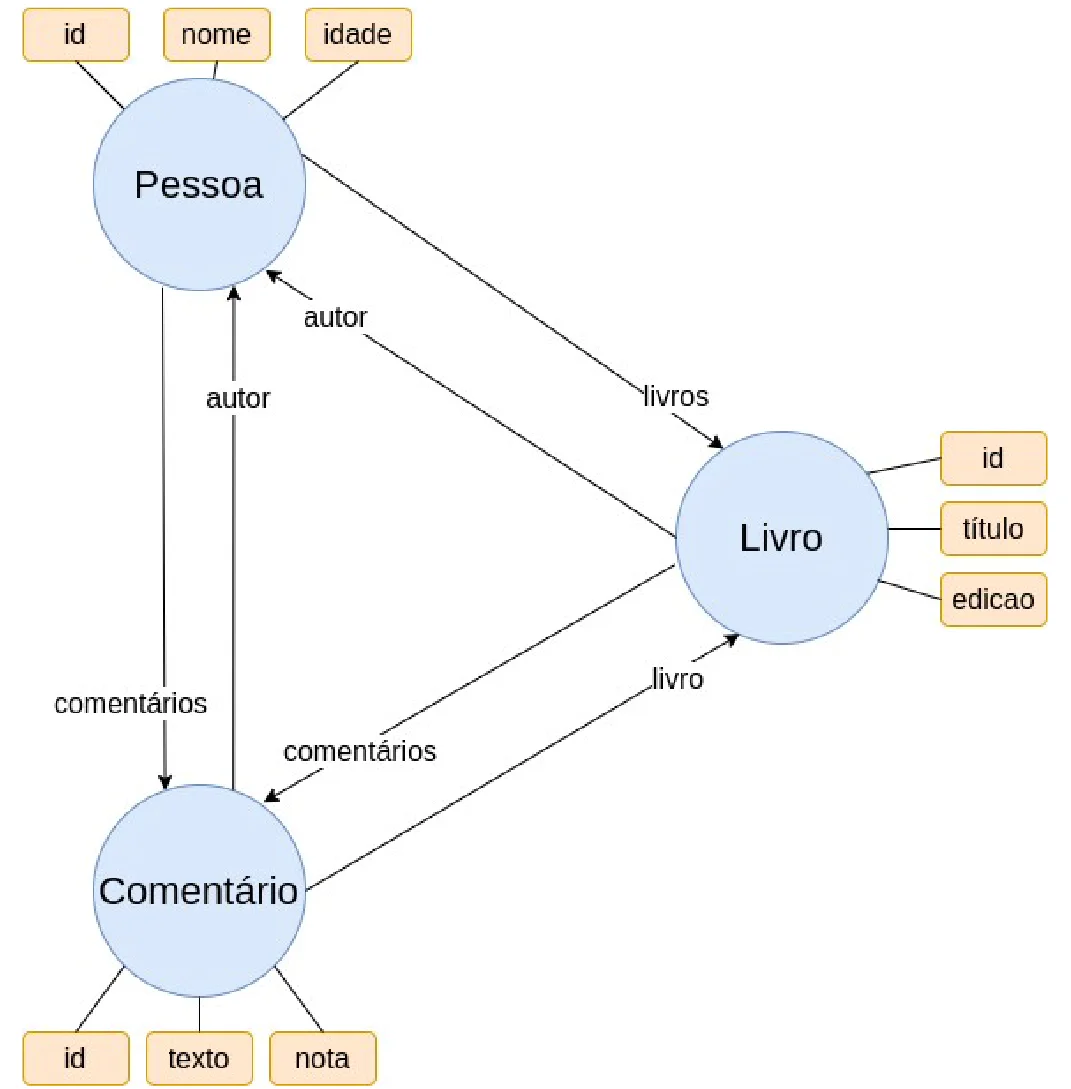
Figura 2.2.1: o modelo da aplicação.
3. Remoção de pessoas
Como vimos, operações que têm como efeito colateral algum tipo de escrita (remoção, atualização, inserção) são implementadas por meio de mutations. A definição de uma mutation para remoções consiste em:
- definição da operação
- implementação de um resolver
A listagem a seguir mostra a definição da operação para remoção de uma pessoa. Note que a remoção requer somente o identificador da pessoa a ser removida.
src/index.js · Listagem 2.3.1 (type Mutation)
type Mutation{
   inserirPessoa (pessoa: InserirPessoaInput): Pessoa!
   removerPessoa (id: ID!): Pessoa!
   inserirLivro (livro: InserirLivroInput): Livro!
   inserirComentario (comentario: InserirComentarioInput): Comentario!
 }
O resolver é a função que entra em execução quando o cliente faz a requisição. Para a remoção, ela fará o seguinte:
- Verificar se o identificador recebido existe na base. Se não existir, lançar um erro.
- Se o identificador existir, remover a pessoa, os livros que ela tenha eventualmente escrito (e os comentários a eles associados) e os comentários que ela tenha eventualmente realizado.
- Devolver os dados da pessoa removida.
O método splice
splice significa algo como "emendar". É um método que pode ser utilizado tanto para a remoção quanto para a inserção de elementos. Ele recebe:
- start: índice a partir do qual a alteração começará
- deleteCount: número de itens a remover a partir de start (inclusive)
- item1, item2…: coleção de itens de tamanho arbitrário a serem inseridos na coleção
Veja os exemplos a seguir.
Listagem 2.3.2
let v = ["a", "b", "c", "d", "e"]
v.splice (0, 1) // ["b", "c", "d", "e"]
v.splice (2, 0, "j") // ["b", "c", "j", "d", "e"]
v.splice (1, 2, "k") //["b", "k", "d", "e"]
Veja mais sobre o método splice em https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/Array/splice (Link 2.3.1).
O resolver removerPessoa
Veja a implementação do resolver.
src/index.js · Listagem 2.3.3 (resolvers de Mutation)
Mutation: {
    inserirPessoa (parent, args, ctx, info){
      const pessoa = {
        id: uuidv4(),
        nome: args.pessoa.nome,
        idade: args.pessoa.idade
      }
      pessoas.push(pessoa);
      return pessoa;
    },
    removerPessoa (parent, args, ctx, info){
      const indice = pessoas.findIndex((p) => {
        return p.id === args.id;
      });
      if (indice < 0)
        throw new Error ("Pessoa não existe!");

      //removendo a pessoa (opera in place)
      //devolve coleção com itens removidos
      const removido = pessoas.splice(indice, 1)[0];

      //removendo livros da pessoa
      livros = livros.filter((livro => {
        const remover = livro.autor === args.id;
        //removendo comentários de cada livro
        comentarios = comentarios.filter(c => {
          return remover && c.livro !== livro.id;
        });

        return !remover;
      }));
      //remove comentários que a pessoa fez
      comentarios = comentarios.filter(c => c.autor !== args.id);
      return removido;
    },
Lembre-se de ajustar as coleções para que elas não mais sejam constantes, afinal, a cada operação de remoção elas podem ser atualizadas.
src/index.js · Listagem 2.3.4 (trechos)
let pessoas = [{…

let livros = [{…

let comentarios = [{...
A operação de remoção de pessoas pode ser testada com a mutation a seguir. Note que a pessoa sendo removida tem id igual a 1. O resultado deve conter seus dados e coleções comentários e livros vazias.
GraphQL Playground · Listagem 2.3.5
mutation {
  removerPessoa (id:"1"){
    id
    nome
    idade
    livros{
      id
      titulo
      comentarios{
        texto
      }
    }
    comentarios{
      texto
    }
  }
}
4. Remoção de livros e de comentários
Remoção de livros
A remoção de livros pode ser implementada de maneira análoga, porém é um tanto mais simples, já que remover um livro implica em remover (além do livro propriamente dito, é claro) os comentários a ele associados.
O primeiro passo é definir a mutation.
src/index.js · Listagem 2.4.1 (type Mutation)
type Mutation{
   inserirPessoa (pessoa: InserirPessoaInput): Pessoa!
   removerPessoa (id: ID!): Pessoa!
   inserirLivro (livro: InserirLivroInput): Livro!
   removerLivro (id: ID!): Livro!
   inserirComentario (comentario: InserirComentarioInput): Comentario!
 }
A seguir, implementamos o resolver apropriado.
src/index.js · Listagem 2.4.2 (resolvers de Mutation)
inserirLivro (parent, args, ctx, info){
      const autorExiste = pessoas.some(
        (pessoa) => pessoa.id === args.livro.autor
      );
      if (!autorExiste){
        throw new Error ("Autor não existe")
      }
      const livro = {
        id: uuidv4(),
        titulo: args.livro.titulo,
        edicao: args.livro.edicao,
        autor: args.livro.autor
      };
      livros.push(livro);
      return livro;
    },
    removerLivro (parent, args, ctx, info){
      const indice = livros.findIndex ((l) => l.id === args.id)
      if (indice < 0)
        throw new Error ("Livro não existe")
      const removido = livros.splice(indice, 1)[0];
      comentarios = comentarios.filter(c => {
        return c.livro !== args.id
      })
      return removido;
    },
As operações a seguir, executadas no Playground (ou algum outro cliente, como o Postman), ilustram o funcionamento da nova operação. Primeiro, removemos o livro de id igual a 100. A seguir, verificamos a coleção inteira de comentários. O resultado esperado é ver todos os comentários na coleção, exceto aqueles que estavam associados ao livro removido. Execute-as, por exemplo, em abas diferentes do Playground.
GraphQL Playground · Listagem 2.4.3
mutation {
  removerLivro (id:"100"){
    id
    titulo
    comentarios{
      texto
    }
  }
}

query {
  comentarios{
    texto
    livro{
      id
    }
  }
}
Remoção de comentários
A remoção de um comentário é a mais simples. Não temos a preocupação de lidar com nenhum dado relacionado, já que remover um comentário não implica em remover o livro a que se refere e à pessoa que o criou.
O primeiro passo é definir uma nova mutation.
src/index.js · Listagem 2.5.1 (type Mutation)
type Mutation{
   inserirPessoa (pessoa: InserirPessoaInput): Pessoa!
   removerPessoa (id: ID!): Pessoa!
   inserirLivro (livro: InserirLivroInput): Livro!
   removerLivro (id: ID!): Livro!
   inserirComentario (comentario: InserirComentarioInput): Comentario!
   removerComentario (id: ID!): Comentario!
 }
O próximo passo é definir o resolver apropriado. Ele altera somente a coleção de comentários.
src/index.js · Listagem 2.5.2 (final do objeto Mutation)
    inserirComentario (parent, args, ctx, info){
      if (!pessoas.some((pessoa) => pessoa.id === args.comentario.autor) ||
        !livros.some((livro) => livro.id === args.comentario.livro)){
            throw new Error ('Autor e/ou Livro inexistente')
      }
      const comentario = {
        id: uuidv4(),
        texto: args.comentario.texto,
        nota: args.comentario.nota,
        livro: args.comentario.livro,
        autor: args.comentario.autor
      }
      comentarios.push(comentario);
      return comentario;

    },
    removerComentario (parent, args, ctx, info){
      const indice = comentarios.findIndex (c => c.id === args.id);
      if (indice < 0)
        throw new Error ("Comentário não existe!")
      return comentarios.splice (indice, 1)[0];
    }
  },
Para testar a remoção de comentários, use as operações a seguir.
GraphQL Playground · Listagem 2.5.3
mutation {
  removerComentario(id:"1001") {
    id
    texto
    livro{
      titulo
    }
  }
}

query {
  comentarios {
    id
    texto
  }
}
5. O schema em schema.graphql
Note que o arquivo index.js possui em torno de 250 linhas de código, o que já pode comprometer a sua manutenabilidade. Se mantivermos o desenvolvimento assim, chegará um momento em que, de fato, a manutenção será praticamente impossível. Por essa razão, nesta seção, estudaremos como podemos organizar a aplicação em diretórios e pequenos arquivos altamente coesos (com um único propósito), o que tende a promover aspectos fundamentais do desenvolvimento de software como a própria manutenabilidade e também a reusabilidade.
A primeira refatoração consiste em separar as definições feitas na string typeDefs em seu próprio arquivo. Crie um novo arquivo chamado schema.graphql (o nome é arbitrário) na pasta src e transporte as definições para lá (somente as definições, a string propriamente dita não).
src/schema.graphql · Listagem 2.6.1
#arquivo schema.graphql
type Pessoa {
   id: ID!
   nome: String!
   idade: Int
   livros: [Livro!]!
   comentarios: [Comentario!]!
 },
 type Livro {
   id: ID!
   titulo: String!
   edicao: Int!
   autor: Pessoa!
   comentarios: [Comentario!]!
 },
 type Comentario {
   id: ID!
   texto: String!
   nota: Int!
   livro: Livro!
   autor: Pessoa!
 },
 type Query {
   livros: [Livro!]!
   pessoas: [Pessoa!]!
   comentarios: [Comentario!]!

 }

 type Mutation{
   inserirPessoa (pessoa: InserirPessoaInput): Pessoa!
   removerPessoa (id: ID!): Pessoa!
   inserirLivro (livro: InserirLivroInput): Livro!
   removerLivro (id: ID!): Livro!
   inserirComentario (comentario: InserirComentarioInput): Comentario!
   removerComentario (id: ID!): Comentario!
 }

 input InserirLivroInput{
  titulo: String!
  edicao: Int!
  autor: ID!
 }

 input InserirPessoaInput {
   nome: String!
   idade: Int
 }

 input InserirComentarioInput {
   texto: String!
   nota: Int!
   livro: ID!
   autor: ID!
 }
A seguir, apague a definição da string typeDefs no arquivo index.js. Além disso, ajuste os imports e faça a leitura do arquivo schema.graphql utilizando o módulo fs (file system) do Node. Para tal, será necessário importá-lo.
src/index.js · Listagem 2.6.2 (trecho)
//...
import * as fs from 'fs';
//apagar essa constante
const typeDefs = `

`;
Note que a constante typeDefs costumava ser utilizada para inicializar o servidor GraphQL. Em sua construção, informamos a coleção de definições e a coleção de resolvers, lembra? Neste momento, não temos mais a string typeDefs, porém, seu conteúdo está presente no novo arquivo (schema.graphql). Assim, basta ajustar a construção do servidor para que ele o utilize.
src/index.js · Listagem 2.6.3 (trecho)
//…
const server = createServer({
  schema: {
    typeDefs: fs.readFileSync('./src/schema.graphql', 'utf-8'),
    resolvers
  }
})
//...
Salve o arquivo e veja que a aplicação voltou a funcionar.
O nodemon e arquivos .graphql
Segundo a documentação do nodemon, que pode ser encontrada em https://github.com/remy/nodemon (Link 2.6.1), por padrão, ele "observa" somente arquivos de extensão .js, .mjs, .coffee, .litcoffee e .json. Como temos um arquivo de extensão .graphql e desejamos que o live reload seja feito pelo nodemon quando ele for atualizado, vamos adicionar o parâmetro --ext ao script associado a start em package.json. Ali, especificamos as extensões desejadas.
package.json · Listagem 2.6.4 (trecho)
"scripts": {
    "test": "echo \"Error: no test specified\" && exit 1",
    "start": "nodemon src/index.js --ext js,graphql --exec babel-node"
  },
Feito esse ajuste, não deixe de reiniciar o servidor (CTRL+C no terminal e, então, npm run start).
6. A base em db.js e o objeto context
O próximo passo é separar a definição da base de dados (ainda volátil) em um arquivo próprio para ela. Seu nome pode ser algo como db.js e ele pode, por exemplo, ser criado diretamente na pasta src. A seguir, vamos transportar as definições das três coleções (pessoas, livros e comentários) existentes em index.js para o arquivo db.js.
src/db.js · Listagem 2.6.5
let pessoas = [{
    id: "1",
    nome: "Cormen",
    idade: 19,
  },
  {
    id: "2",
    nome: "Velleman",
  },
];

let livros = [{
    id: "100",
    titulo: "Introduction to Algorithms",
    edicao: 3,
    autor: "1",
  },
  {
    id: "101",
    titulo: "How to Prove it",
    edicao: 2,
    autor: "2",
  }
];

let comentarios = [{
    id: "1001",
    texto: "excelente",
    nota: 5,
    livro: "101",
    autor: '1'
  },
  {
    id: "1002",
    texto: "Gostei muito",
    nota: 5,
    livro: "101",
    autor: '1'

  },
  {
    id: "1003",
    texto: "Bacana",
    nota: 4,
    livro: "100",
    autor: '1'
  },
];
Como as coleções estão definidas em um arquivo à parte, elas já não podem ser acessadas no arquivo index.js. Poderíamos resolver esse problema da seguinte forma:
- exportamos um objeto contendo as coleções do arquivo
db.js - importamos o objeto exportado em
index.js - qualificamos o acesso a cada coleção utilizando o nome do objeto importado
Note, contudo, que esta solução pode ser inconveniente. Isso ocorre pois as demais definições ainda existentes no arquivo index.js também serão transportadas para seus arquivos próprios e, cada um deles, pode ter a necessidade de acessar uma ou mais coleções. Teríamos de repetir o processo de importar o objeto exportado por db e qualificar o acesso em cada arquivo.
Neste cenário, entra em cena o objeto ctx (de contexto) que cada resolver recebe. Quando o servidor GraphQL é construído, podemos entregar a ele um objeto associado ao nome context. Esse objeto será, por sua vez, passado para cada resolver quando em execução.
O primeiro passo é exportar um objeto contendo as coleções no arquivo db.js.
src/db.js · Listagem 2.6.6
/*no final do arquivo, depois das
definições das coleções */
export default {
  pessoas,
  comentarios,
  livros
}
A seguir, no arquivo index.js, importamos o objeto exportado em db.js.
src/index.js · Listagem 2.6.7
import db from './db';
Agora podemos passar o objeto db como argumento no momento em que o servidor GraphQL é construído, associado ao nome context.
src/index.js · Listagem 2.6.8 (trecho)
//…
const server = createServer({
  schema: {
    typeDefs, resolvers
  },
  context: {db: db}
})
//...
Feitas essas alterações, quando um resolver for colocado em execução, o seu parâmetro ctx fará referência ao objeto que contém db, especificado no momento em que o servidor foi construído.
Resta passarmos a utilizar o objeto db agora existente no contexto de cada resolver. Veja os ajustes a seguir.
src/index.js · Listagem 2.6.9
const resolvers = {
  Query: {
    livros(parent, args, ctx, info) {
      return ctx.db.livros;
    },
    pessoas(parent, args, ctx, info) {
      return ctx.db.pessoas;
    },
    comentarios(parent, args, ctx, info) {
      return ctx.db.comentarios;
    }
  },
  Mutation: {
    inserirPessoa (parent, args, ctx, info){
      const pessoa = {
        id: uuidv4(),
        nome: args.pessoa.nome,
        idade: args.pessoa.idade
      }
      ctx.db.pessoas.push(pessoa);
      return pessoa;
    },
    removerPessoa(parent, args, ctx, info) {
      const indice = ctx.db.pessoas.findIndex((p) => {
        return p.id === args.id;
      });
      if (indice < 0)
        throw new Error("Pessoa não existe!");

      //removendo a pessoa (opera in place)
      //devolve coleção com itens removidos
      const removido = ctx.db.pessoas.splice(indice, 1)[0];

      //removendo livros da pessoa
      ctx.db.livros = ctx.db.livros.filter((livro => {
        const remover = livro.autor === args.id;
        //removendo comentários de cada livro
        ctx.db.comentarios = ctx.db.comentarios.filter(c => {
          return remover && c.livro !== livro.id;
        });

        return !remover;
      }));
      //remove comentários que a pessoa fez
      ctx.db.comentarios = ctx.db.comentarios.filter(c => c.autor !== args.id);
      return removido;
    },

    inserirLivro (parent, args, ctx, info){
      const autorExiste = ctx.db.pessoas.some(
        (pessoa) => pessoa.id === args.livro.autor
      );
      if (!autorExiste){
        throw new Error ("Autor não existe")
      }
      const livro = {
        id: uuidv4(),
        titulo: args.livro.titulo,
        edicao: args.livro.edicao,
        autor: args.livro.autor
      };
      ctx.db.livros.push(livro);
      return livro;
    },
    removerLivro (parent, args, ctx, info){
      const indice = ctx.db.livros.findIndex((l) => l.id === args.id)
      if (indice < 0)
        throw new Error ("Livro não existe")
      const removido = ctx.db.livros.splice(indice, 1)[0];
      ctx.db.comentarios = ctx.db.comentarios.filter(c => {
        return c.livro !== args.id
      })
      return removido;
    },
    inserirComentario (parent, args, ctx, info){
      if (!ctx.db.pessoas.some((pessoa) => pessoa.id === args.comentario.autor) ||
        !ctx.db.livros.some((livro) => livro.id === args.comentario.livro)) {
            throw new Error ('Autor e/ou Livro inexistente')
      }
      const comentario = {
        id: uuidv4(),
        texto: args.comentario.texto,
        nota: args.comentario.nota,
        livro: args.comentario.livro,
        autor: args.comentario.autor
      }
      ctx.db.comentarios.push(comentario);
      return comentario;

    },
    removerComentario (parent, args, ctx, info){
      const indice = ctx.db.comentarios.findIndex(c => c.id === args.id);
      if (indice < 0)
        throw new Error ("Comentário não existe!")
      return ctx.db.comentarios.splice(indice, 1)[0];
    }
  },
  Livro: {
    autor(parent, args, ctx, info) {
      return ctx.db.pessoas.find((pessoa) => {
        return pessoa.id === parent.autor;
      });
    },
    comentarios(parent, args, ctx, info) {
      return ctx.db.comentarios.filter((comentario) => {
        return comentario.livro === parent.id
      })
    }
  },
  Pessoa: {
    livros(parent, args, ctx, info) {
      return ctx.db.livros.filter((livro) => {
        return livro.autor === parent.id;
      });
    },
    comentarios(parent, args, ctx, info) {
      return ctx.db.comentarios.filter((comentario) => {
        return comentario.autor === parent.id
      })
    }
  },
  Comentario: {
    livro(parent, args, ctx, info) {
      return ctx.db.livros.find((livro) => {
        return livro.id === parent.livro;
      });
    },
    autor(parent, args, ctx, info) {
      return ctx.db.pessoas.find((pessoa) => {
        return pessoa.id === parent.autor
      })
    }
  },
};
7. Um arquivo por tipo de resolver
A próxima refatoração pela qual nossa aplicação passará é a separação dos resolvers em pequenos arquivos, cada qual com a sua própria finalidade. Antes de mais nada, na pasta src, crie uma subpasta chamada resolvers. Teremos um arquivo para cada uma das propriedades "root" existentes no objeto resolvers: Query, Mutation, Pessoa, Livro e Comentario. Crie os seguintes arquivos na pasta resolvers:
Query.jsMutation.jsPessoa.jsLivro.jsComentario.js
Note que os nomes podem ser quaisquer, não necessariamente são iguais aos itens que farão parte de seu conteúdo.
Query.js
Transporte o objeto associado à chave Query no arquivo index.js para o arquivo Query.js (mantenha a chave no arquivo index.js). Além disso, no arquivo Query.js, crie uma nova constante e atribua o objeto transportado de index.js a ela.
src/index.js · Listagem 2.6.10 (como fica, por enquanto)
//arquivo index.js
const resolvers = {
  Query: ,
  Mutation: {…
src/resolvers/Query.js · Listagem 2.6.10
//arquivo Query.js
const Query = {
  livros(parent, args, ctx, info) {
    return ctx.db.livros;
  },
  pessoas(parent, args, ctx, info) {
    return ctx.db.pessoas;
  },
  comentarios(parent, args, ctx, info) {
    return ctx.db.comentarios;
  }
};

export default Query;
Mutation.js
Repita o mesmo processo para as definições de mutations: transporte o objeto associado à chave Mutation em index.js para o arquivo Mutation.js, atribuindo-o a uma constante e exportando-o logo a seguir. Note que o módulo que gera identificadores passa a ser importado em Mutation.js já que somente as mutations o utilizam.
src/resolvers/Mutation.js · Listagem 2.6.11
//arquivo Mutation.js
import {
  v4 as uuidv4
} from "uuid";
const Mutation = {
  inserirPessoa(parent, args, ctx, info) {
    const pessoa = {
      id: uuidv4(),
      nome: args.pessoa.nome,
      idade: args.pessoa.idade
    }
    ctx.db.pessoas.push(pessoa);
    return pessoa;
  },
  removerPessoa(parent, args, ctx, info) {
    const indice = ctx.db.pessoas.findIndex((p) => {
      return p.id === args.id;
    });
    if (indice < 0)
      throw new Error("Pessoa não existe!");

    //removendo a pessoa (opera in place)
    //devolve coleção com itens removidos
    const removido = ctx.db.pessoas.splice(indice, 1)[0];

    //removendo livros da pessoa
    ctx.db.livros = ctx.db.livros.filter((livro => {
      const remover = livro.autor === args.id;
      //removendo comentários de cada livro
      ctx.db.comentarios = ctx.db.comentarios.filter(c => {
        return remover && c.livro !== livro.id;
      });

      return !remover;
    }));
    //remove comentários que a pessoa fez
    ctx.db.comentarios = ctx.db.comentarios.filter(c => c.autor !== args.id);
    return removido;
  },

  inserirLivro(parent, args, ctx, info) {
    const autorExiste = ctx.db.pessoas.some(
      (pessoa) => pessoa.id === args.livro.autor
    );
    if (!autorExiste) {
      throw new Error("Autor não existe")
    }
    const livro = {
      id: uuidv4(),
      titulo: args.livro.titulo,
      edicao: args.livro.edicao,
      autor: args.livro.autor
    };
    ctx.db.livros.push(livro);
    return livro;
  },
  removerLivro(parent, args, ctx, info) {
    const indice = ctx.db.livros.findIndex((l) => l.id === args.id)
    if (indice < 0)
      throw new Error("Livro não existe")
    const removido = ctx.db.livros.splice(indice, 1)[0];
    ctx.db.comentarios = ctx.db.comentarios.filter(c => {
      return c.livro !== args.id
    })
    return removido;
  },
  inserirComentario(parent, args, ctx, info) {
    if (!ctx.db.pessoas.some((pessoa) => pessoa.id === args.comentario.autor) ||
      !ctx.db.livros.some((livro) => livro.id === args.comentario.livro)) {
      throw new Error('Autor e/ou Livro inexistente')
    }
    const comentario = {
      id: uuidv4(),
      texto: args.comentario.texto,
      nota: args.comentario.nota,
      livro: args.comentario.livro,
      autor: args.comentario.autor
    }
    ctx.db.comentarios.push(comentario);
    return comentario;

  },
  removerComentario(parent, args, ctx, info) {
    const indice = ctx.db.comentarios.findIndex(c => c.id === args.id);
    if (indice < 0)
      throw new Error("Comentário não existe!")
    return ctx.db.comentarios.splice(indice, 1)[0];
  }
}
export default Mutation;
Livro.js, Pessoa.js e Comentario.js
Repita o processo para Pessoa, Livro e Comentario como ilustram as listagens a seguir.
src/resolvers/Livro.js · Listagem 2.6.12
//arquivo Livro.js
const Livro = {
  autor(parent, args, ctx, info) {
    return ctx.db.pessoas.find((pessoa) => {
      return pessoa.id === parent.autor;
    });
  },
  comentarios(parent, args, ctx, info) {
    return ctx.db.comentarios.filter((comentario) => {
      return comentario.livro === parent.id
    })
  }
};
export default Livro;
src/resolvers/Pessoa.js · Listagem 2.6.13
//arquivo Pessoa.js
const Pessoa = {
  livros(parent, args, ctx, info) {
    return ctx.db.livros.filter((livro) => {
      return livro.autor === parent.id;
    });
  },
  comentarios(parent, args, ctx, info) {
    return ctx.db.comentarios.filter((comentario) => {
      return comentario.autor === parent.id
    })
  }
}

export default Pessoa;
src/resolvers/Comentario.js · Listagem 2.6.14
//arquivo Comentario.js
const Comentario = {
  livro(parent, args, ctx, info) {
    return ctx.db.livros.find((livro) => {
      return livro.id === parent.livro;
    });
  },
  autor(parent, args, ctx, info) {
    return ctx.db.pessoas.find((pessoa) => {
      return pessoa.id === parent.autor
    })
  }
}

export default Comentario;
Ao final, o objeto de resolvers em index.js ficará apenas com as chaves:
src/index.js · Listagem 2.6.14 (como fica, por enquanto)
//arquivo index.js
const resolvers = {
  Query: ,
  Mutation: ,
  Livro: ,
  Pessoa: ,
  Comentario: ,
};

const server = createServer({...
Importando os resolvers em index.js
No próximo passo, importamos cada objeto de cada arquivo no arquivo index.js e utilizamos cada um deles como um resolver.
src/index.js · Listagem 2.6.15
//arquivo index.js
import {
  GraphQLServer
} from "graphql-yoga";

import Query from './resolvers/Query';
import Mutation from './resolvers/Mutation';
import Pessoa from './resolvers/Pessoa';
import Livro from './resolvers/Livro';
import Comentario from './resolvers/Comentario';

import db from './db';

const resolvers = {
  Query,
  Mutation,
  Livro,
  Pessoa,
  Comentario,
};
Também será necessário importar o módulo uuid no arquivo Mutation.js, já que os ids são gerados pelos resolvers lá definidos.
src/resolvers/Mutation.js · Listagem 2.6.16 (início)
import { v4 as uuidv4 } from 'uuid'
const Mutation = {
  inserirPessoa(parent, args, ctx, info){
    const pessoa = {
...
8. Exercícios
- Refatore a sua aplicação de funcionários e setores como visto em aula. Defina um arquivo apropriado para a definição do schema e um arquivo para cada "tipo" de resolver. Utilize o objeto context para compartilhar o acesso à base com todos os resolvers. Para isso, não deixe de separar a definição da base em um arquivo próprio para isso.
9. Encerramento
Sua API agora tem inserções e remoções e está organizada em schema.graphql, db.js e um arquivo por tipo de resolver, com a base compartilhada pelo context. No próximo codelab da série, entram as mutations de atualização.
Referências
- Babel · The compiler for next generation JavaScript. 2020. Disponível em https://babeljs.io. Acesso em agosto de 2020.
- GraphQL | A query language for your API. 2020. Disponível em https://graphql.org. Acesso em agosto de 2020.
- Node.js. 2020. Disponível em https://nodejs.org. Acesso em agosto de 2020.
- WILSON, Jim R. Node.js 8 the Right Way. 1st edition. The Pragmatic Programmers, LLC, 2018.