Data Warehouse com PostgreSQL: star schema passo a passo
Construa um Data Warehouse no PostgreSQL a partir do dataset Supermarket Sales: conceitos de OLTP e OLAP, formas normais, ETL e ELT, modelagem dimensional de Kimball, camadas raw, staging e dw, star schema, cursor e trigger em PL/pgSQL, consultas analíticas e cubo OLAP.
1. Visão geral
Neste codelab você constrói um Data Warehouse completo dentro do PostgreSQL, partindo de um único arquivo CSV com vendas de um supermercado. O caminho é sempre o mesmo: CSV de origem, camada raw (cópia fiel), camada staging (dados limpos), camada dw (star schema) e, por fim, as consultas analíticas que alimentam o BI.
O que você vai aprender
- A diferença entre sistemas OLTP e OLAP e por que o OLTP é normalizado
- As três primeiras formas normais, com um exemplo passo a passo
- A diferença entre ETL e ELT
- Modelagem dimensional (Kimball): fatos, dimensões, star schema, snowflake, grão e chave surrogate
- Como organizar o DW em três schemas:
raw,stagingedw - Como limpar dados em SQL com
TRIM,UPPER,INITCAP,CASTeTO_TIMESTAMP - Como gerar uma dimensão de datas com
generate_seriese carregar a tabela fato com surrogate key lookup - Como usar um cursor (curva ABC) e um trigger (auditoria) em PL/pgSQL
- Como responder perguntas de negócio e montar subtotais com
ROLLUPeCUBE
O que você vai precisar
- PostgreSQL 14+ (https://www.postgresql.org/download/)
- pgAdmin 4+ (https://www.pgadmin.org/download/)
- O dataset Supermarket Sales, do Kaggle (veja o passo "O dataset e o ambiente")
2. O que é um Data Warehouse
Um Data Warehouse (DW) é um banco de dados desenhado para análise, não para operação. Enquanto o sistema do supermercado registra cada venda em milissegundos — um sistema OLTP (Online Transaction Processing, processamento de transações online) —, o DW responde perguntas como "qual filial teve maior lucro no último trimestre?" — um sistema OLAP (Online Analytical Processing, processamento analítico online) — varrendo milhões de linhas.
Visão geral do fluxo
Antes de mergulhar nos detalhes, veja o caminho completo que os dados percorrem, desde o CSV original até o dashboard de BI (Business Intelligence, inteligência de negócio). Cada etapa abaixo é desenvolvida em uma seção própria:
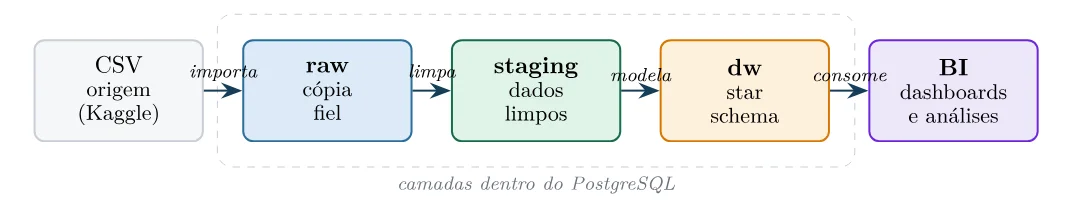
O caminho dos dados, do CSV ao BI.
OLTP vs OLAP
| OLTP (operacional) | OLAP (analítico) |
|---|---|
| Registra transações em tempo real | Responde perguntas de negócio |
Muitos INSERT / UPDATE |
Muitos SELECT pesados |
| Normalizado (3FN) | Desnormalizado (estrela) |
| Resposta em milissegundos | Resposta em segundos |
| Guarda o estado atual | Guarda histórico completo |
| Ex.: sistema PDV do supermercado | Ex.: Data Warehouse |
3. As formas normais
Dissemos acima que um banco OLTP é normalizado (3FN). Normalizar é organizar as tabelas de modo que cada fato do mundo real seja armazenado uma única vez. Isso evita anomalias: se o endereço de um cliente aparece em 500 linhas de pedidos e ele se muda, ou você atualiza as 500 ou o banco fica inconsistente.
Vamos normalizar um exemplo minúsculo, passo a passo.
Ponto de partida: tabela não normalizada
| pedido | cliente | cidade | produtos |
|---|---|---|---|
| 101 | Ana | São Paulo | Café (2), Pão (3) |
| 102 | Bruno | Campinas | Leite (1) |
| 103 | Ana | São Paulo | Pão (5), Leite (2), Café (1) |
Problema: a coluna produtos guarda vários valores em uma célula. Não dá para somar quantidades, filtrar por produto ou fazer JOIN.
1FN — Primeira Forma Normal
Regra: todo campo contém um valor atômico (indivisível) e não há grupos repetidos. Cada produto vira uma linha própria.
| pedido | item | cliente | cidade | produto | qtd |
|---|---|---|---|---|---|
| 101 | 1 | Ana | São Paulo | Café | 2 |
| 101 | 2 | Ana | São Paulo | Pão | 3 |
| 102 | 1 | Bruno | Campinas | Leite | 1 |
| 103 | 1 | Ana | São Paulo | Pão | 5 |
| 103 | 2 | Ana | São Paulo | Leite | 2 |
| 103 | 3 | Ana | São Paulo | Café | 1 |
A chave primária agora é composta: (pedido, item). Já dá para consultar, mas "Ana / São Paulo" se repete cinco vezes.
2FN — Segunda Forma Normal
Regra: estar em 1FN e nenhum atributo depender apenas de parte da chave composta. Aqui cliente e cidade dependem só de pedido, não do par (pedido, item) — é uma dependência parcial. Separamos em duas tabelas:
pedidos
| pedido | cliente | cidade |
|---|---|---|
| 101 | Ana | São Paulo |
| 102 | Bruno | Campinas |
| 103 | Ana | São Paulo |
itens_pedido
| pedido | item | produto | qtd |
|---|---|---|---|
| 101 | 1 | Café | 2 |
| 101 | 2 | Pão | 3 |
| 102 | 1 | Leite | 1 |
| 103 | 1 | Pão | 5 |
| 103 | 2 | Leite | 2 |
| 103 | 3 | Café | 1 |
3FN — Terceira Forma Normal
Regra: estar em 2FN e nenhum atributo não-chave depender de outro atributo não-chave (dependência transitiva). Suponha que a tabela pedidos também guardasse a UF e a região:
| pedido | cliente | cidade | uf | região |
|---|---|---|---|---|
| 101 | Ana | São Paulo | SP | Sudeste |
| 102 | Bruno | Campinas | SP | Sudeste |
| 103 | Ana | São Paulo | SP | Sudeste |
A UF não depende do pedido: depende da cidade. E a região depende da UF. Isso é transitivo. A 3FN manda extrair essas dependências:
pedidos
| pedido | cliente_id | cidade_id |
|---|---|---|
| 101 | 1 | 10 |
| 102 | 2 | 11 |
| 103 | 1 | 10 |
clientes
| cliente_id | nome |
|---|---|
| 1 | Ana |
| 2 | Bruno |
cidades
| cidade_id | nome | uf |
|---|---|---|
| 10 | São Paulo | SP |
| 11 | Campinas | SP |
ufs
| uf | regiao |
|---|---|
| SP | Sudeste |
| RJ | Sudeste |
4. ETL vs ELT
Ao mover dados de uma fonte para o DW, sempre passamos por três verbos: Extract (extrair), Transform (transformar) e Load (carregar). A diferença entre ETL e ELT está na ordem desses verbos — e essa ordem tem consequências grandes na arquitetura.
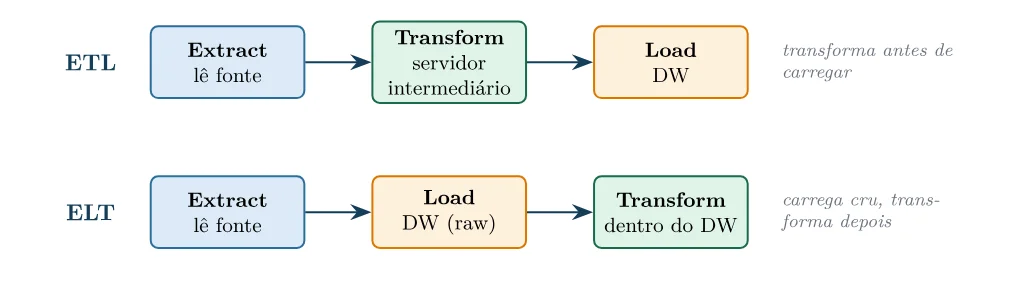
A ordem dos verbos em ETL e em ELT.
Os diagramas acima mostram a ordem dos verbos. Mas a diferença prática é sobretudo onde a máquina trabalha. As duas figuras seguintes mostram exatamente isso: em que computador cada etapa consome CPU e memória.
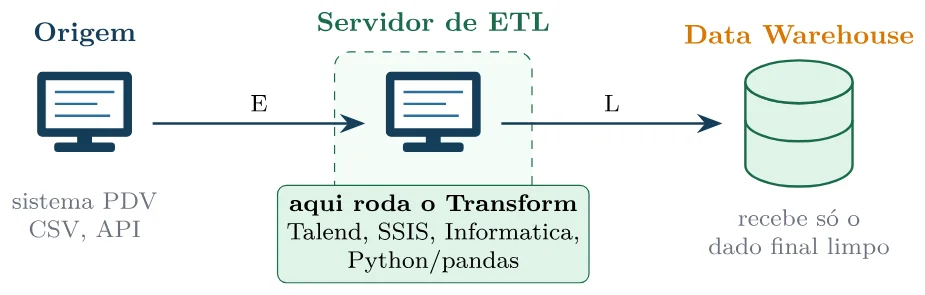
Figura 1: ETL — o processamento pesado acontece em uma máquina intermediária. O DW recebe apenas o resultado final.
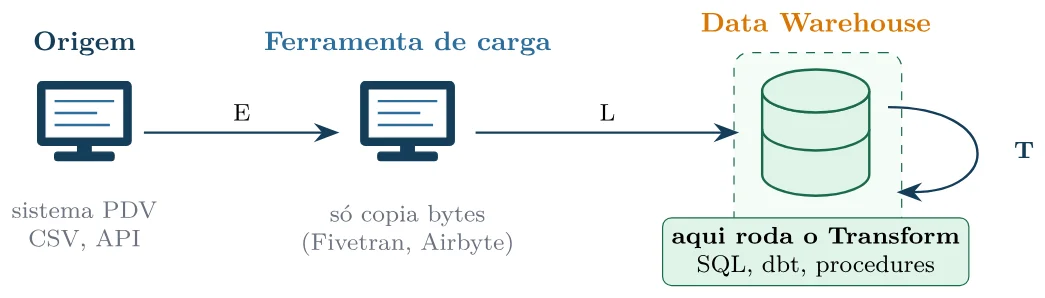
Figura 2: ELT — a máquina do meio só transporta. Todo o processamento pesado acontece dentro do próprio DW, usando o poder de cálculo dele.
ETL (Extract–Transform–Load) é a abordagem clássica, das décadas de 1990 e 2000:
- Os dados são extraídos da origem, passam por um servidor intermediário (Informatica, Talend, SSIS ou scripts Python) onde são transformados, e só depois entram no DW já limpos.
- Faz sentido quando o DW é caro (appliances Teradata, Oracle Exadata) e processar dentro dele custa mais do que num servidor de ETL.
- O DW só recebe o produto final.
ELT (Extract–Load–Transform) é a abordagem moderna, dominante desde 2015:
- Os dados são extraídos e carregados crus no DW (na camada
raw). Só depois, já dentro do DW, são transformados via SQL atéstagingedw. - Faz sentido quando o DW tem processamento barato e elástico (Snowflake, BigQuery, Redshift, PostgreSQL bem dimensionado).
- Ferramentas como o dbt (data build tool) popularizaram esse padrão.
| ETL (clássico) | ELT (moderno) | |
|---|---|---|
| Onde transforma | Servidor intermediário | Dentro do próprio DW |
| Linguagem | Scripts (Python, ferramenta gráfica) | SQL |
| DW armazena | Só dado final limpo | Raw + staging + dw |
| Reprocessamento | Reexecutar pipeline externo | Rodar SQL novamente |
| Custo típico | Licença ETL + infra dedicada | Só o custo do DW |
| Escala | Limitada ao servidor de ETL | Elástica (paralelismo do DW) |
A partir do passo "Schemas e camada RAW", um selo no início de cada etapa indica em qual dos três verbos estamos.
5. Fatos e dimensões
A modelagem dimensional, criada por Ralph Kimball, organiza os dados em dois tipos de tabela:
- Tabela Fato: guarda as medições (valor, quantidade, nota). Muitas linhas, poucas colunas, predominantemente numérica. Cada linha é um evento de negócio — uma venda, por exemplo.
- Tabela Dimensão: guarda o contexto (quem, o quê, onde, quando). Poucas linhas, muitas colunas, textual. Cada linha descreve um item (um produto, uma data, uma filial).
Ligando uma fato central a várias dimensões, obtemos o star schema (esquema em estrela). Para enxergar a estrutura com clareza, vamos desenhá-la como um diagrama entidade–relacionamento na notação de Peter Chen, a mesma usada em modelagem conceitual clássica:
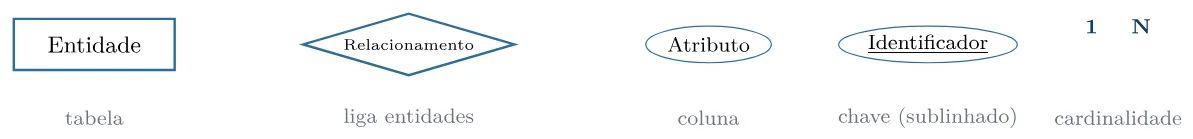
Figura 3: Os quatro símbolos da notação de Chen usados nas próximas figuras.
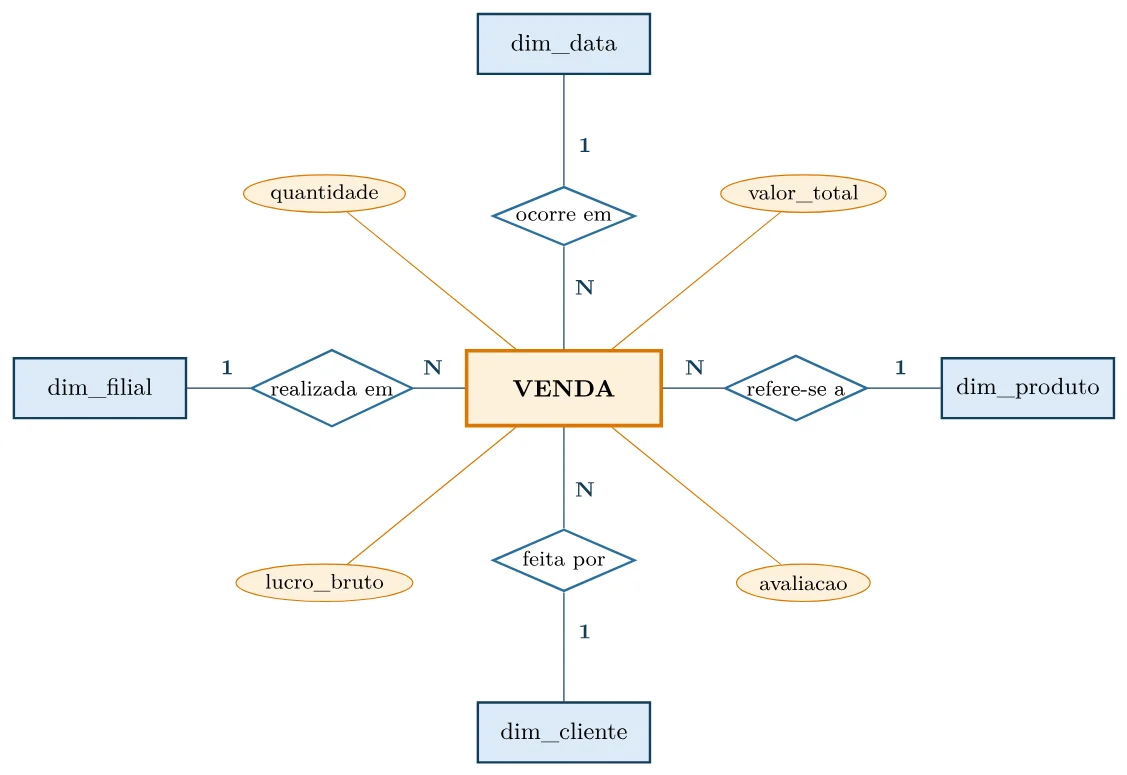
Figura 4: O star schema em notação de Chen. Fato e dimensões são entidades (retângulos), sempre ligadas por um relacionamento (losango) no meio do caminho. As métricas são atributos da entidade VENDA. As cardinalidades dizem o essencial: uma venda refere-se a um produto (1), e um produto aparece em muitas vendas (N).
Um parêntese: o fato também pode ser desenhado como relacionamento
Vale conhecer a leitura alternativa, porque ela é a mais fiel ao que Chen propôs. Uma tabela fato não tem existência própria: ela só existe para conectar dimensões, e suas métricas são justamente o que Chen chamava de atributos do relacionamento — o exemplo canônico dele é a quantidade escrita no losango entre Fornecedor e Peça. Nessa leitura, VENDA não seria um retângulo, e sim um relacionamento n-ário ligando as quatro dimensões de uma vez:
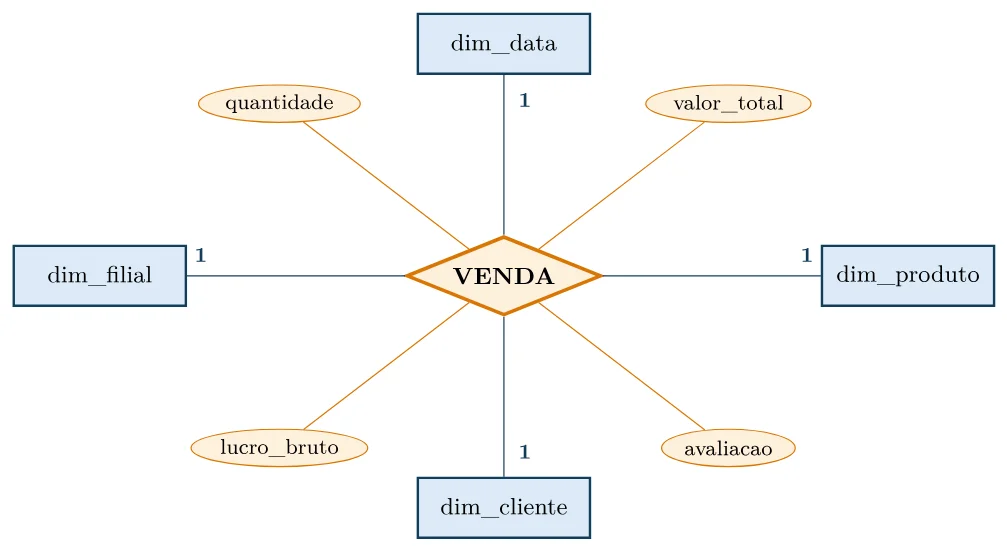
Figura 5: O mesmo star schema visto como relacionamento n-ário: um único losango de grau 4, com as métricas penduradas nele. Aqui o número junto a cada entidade tem outro sentido — indica quantas instâncias daquela dimensão participam de cada ocorrência do relacionamento (uma venda envolve exatamente uma data, um produto, um cliente e uma filial).
Os dois diagramas descrevem exatamente o mesmo modelo; a diferença é o que cada um enfatiza:
- O losango n-ário é mais fiel à natureza do fato — ele deixa explícito que a venda é uma conexão entre dimensões, não uma coisa que existe sozinha.
- A entidade (o desenho que usaremos daqui em diante) é mais fiel ao que vai existir no banco: um
CREATE TABLE fact_salescom cinco chaves estrangeiras. Transformar um relacionamento em entidade tem nome próprio em modelagem: reificação, e é o caminho obrigatório quando o relacionamento precisa virar tabela.
6. Star schema vs snowflake schema
Quando organizamos fato + dimensões, temos dois desenhos possíveis:
- Star schema (estrela): dimensões desnormalizadas. Cada dimensão é uma única tabela com todos os seus atributos, mesmo que haja redundância.
- Snowflake schema (floco de neve): dimensões normalizadas. Atributos hierárquicos (categoria → subcategoria, cidade → estado → região) são quebrados em tabelas próprias.
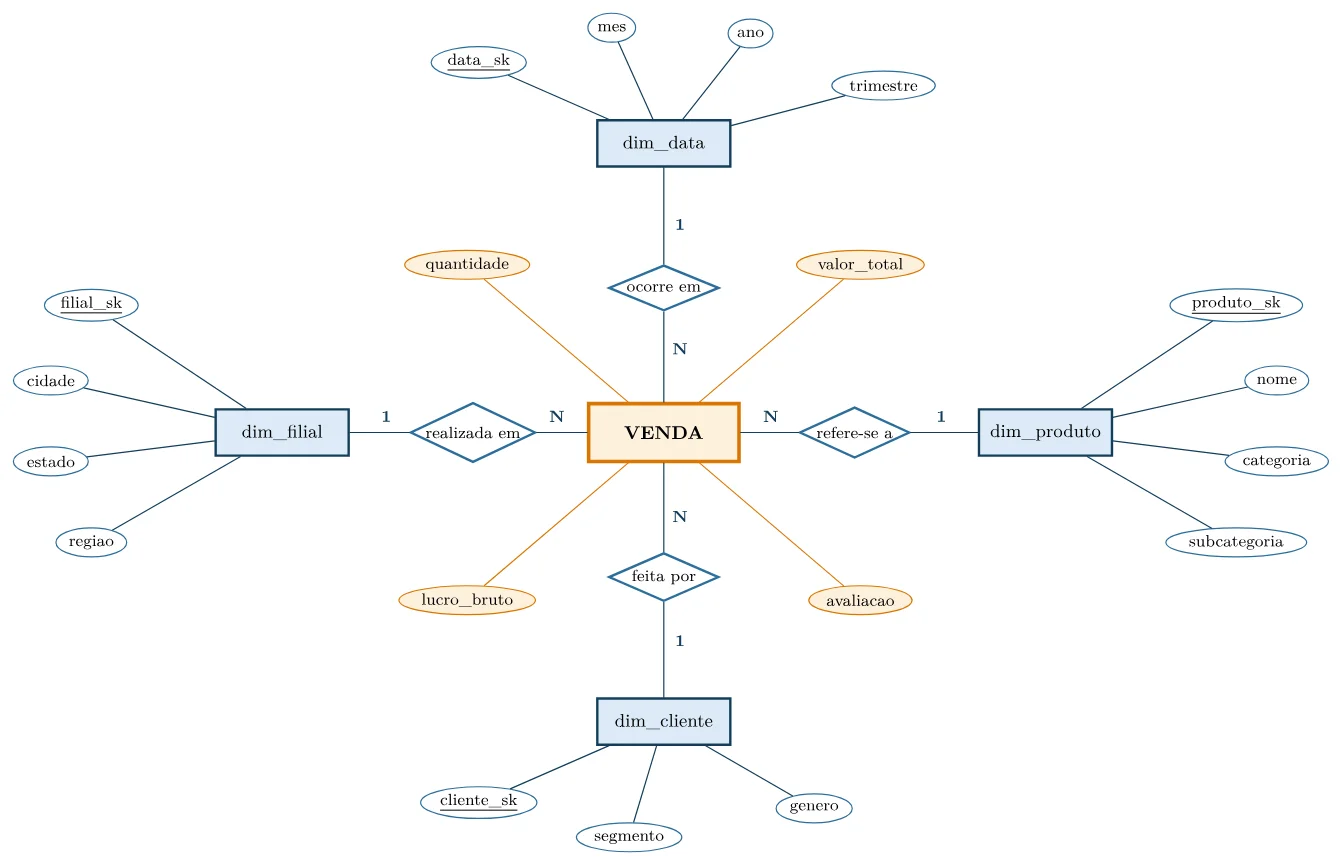
Figura 6: Star schema em notação de Chen: toda a hierarquia vira atributo da própria dimensão. categoria e subcategoria penduram-se direto em dim_produto; cidade, estado e regiao, direto em dim_filial. Nenhuma entidade extra.
Com dados dentro, o star schema fica assim — repare que dim_produto carrega a categoria repetida em várias linhas, e dim_filial repete estado e região:
fato_vendas
| data_sk | produto_sk | filial_sk | qtd | valor | lucro |
|---|---|---|---|---|---|
| 20190301 | 1 | 1 | 2 | 48,00 | 12,00 |
| 20190301 | 3 | 2 | 1 | 15,50 | 4,10 |
| 20190302 | 1 | 2 | 5 | 120,00 | 30,00 |
| 20190302 | 2 | 1 | 3 | 27,00 | 6,30 |
dim_produto (desnormalizada)
| sk | produto | categoria | subcat. |
|---|---|---|---|
| 1 | Café | Mercearia | Bebidas |
| 2 | Chá | Mercearia | Bebidas |
| 3 | Sabão | Limpeza | Roupas |
dim_filial (desnormalizada)
| sk | filial | cidade | uf | região |
|---|---|---|---|---|
| 1 | Centro | São Paulo | SP | Sudeste |
| 2 | Norte | Campinas | SP | Sudeste |
Figura 7: Star schema com dados. Um JOIN por dimensão resolve qualquer pergunta: "lucro por região" sai de fato ⋈ dim_filial, direto.
O desenho que dá nome ao snowflake schema.
O nome floco de neve vem literalmente do desenho acima: um núcleo central do qual saem braços que se ramificam em braços menores, e esses em outros ainda menores. É exatamente o que acontece com as dimensões normalizadas — a fato no centro, as dimensões em volta e, penduradas nelas, as sub-dimensões de cada nível hierárquico. No star os braços são retos e terminam na primeira parada; no snowflake eles continuam se abrindo.
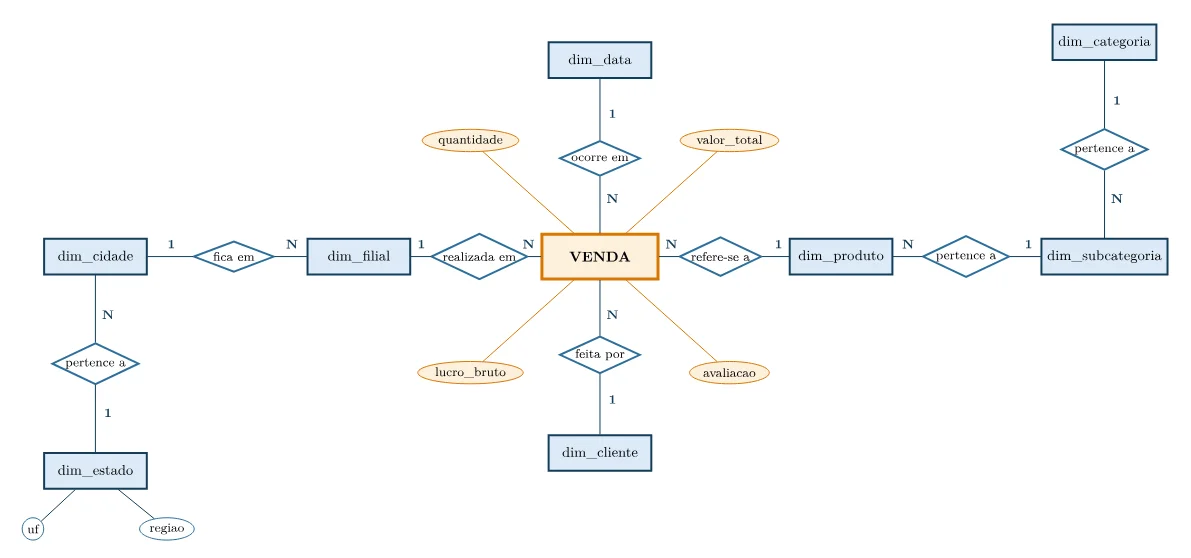
Figura 8: Snowflake schema em notação de Chen: cada nível da hierarquia vira uma entidade nova, ligada por um relacionamento próprio. dim_produto não guarda mais a categoria — guarda apenas a ligação com dim_subcategoria, que por sua vez se liga a dim_categoria. É a 3FN aplicada às dimensões.
Os mesmos dados do exemplo anterior, agora normalizados. Nenhum texto se repete — mas para chegar da venda até a região são necessários três JOINs encadeados:
dim_produto
| sk | produto | subcat_id |
|---|---|---|
| 1 | Café | 100 |
| 2 | Chá | 100 |
| 3 | Sabão | 200 |
dim_subcategoria
| id | nome | cat_id |
|---|---|---|
| 100 | Bebidas | 10 |
| 200 | Roupas | 20 |
dim_categoria
| id | nome |
|---|---|
| 10 | Mercearia |
| 20 | Limpeza |
dim_filial
| sk | filial | cidade_id |
|---|---|---|
| 1 | Centro | 10 |
| 2 | Norte | 11 |
dim_cidade
| id | nome | estado_id |
|---|---|---|
| 10 | São Paulo | 1 |
| 11 | Campinas | 1 |
dim_estado
| id | uf | região |
|---|---|---|
| 1 | SP | Sudeste |
| 2 | RJ | Sudeste |
Figura 9: Snowflake com dados: a hierarquia vira uma cadeia de tabelas. "Lucro por região" agora exige fato ⋈ filial ⋈ cidade ⋈ estado.
| Star schema | Snowflake schema | |
|---|---|---|
| Dimensões | Desnormalizadas (redundantes) | Normalizadas (sem redundância) |
JOINs necessários |
1 por dimensão | Vários (um por nível) |
| Espaço em disco | Maior (há repetição) | Menor |
| Performance de query | Melhor (menos JOINs) |
Pior |
| Facilidade para o analista | Alta (uma tabela por assunto) | Baixa (é um quebra-cabeça) |
| Integridade de hierarquia | Mantida pelo ETL | Garantida pelo modelo |
7. Grão e chave surrogate
Granularidade (o "grão")
O grão é a resposta para a pergunta: "o que representa uma linha da tabela fato?". Definir o grão é a decisão mais importante da modelagem — ele determina o nível de detalhe possível em todas as análises futuras. Uma vez agregado, o detalhe está perdido.
Alguns exemplos de grão em contextos diferentes:
- Supermercado (o nosso caso): uma linha = uma venda registrada no cupom. Se o grão fosse "um item do cupom", poderíamos analisar produto a produto dentro da mesma compra.
- E-commerce: uma linha = um item de um pedido. Permite responder "quais produtos costumam ser comprados juntos?".
- Banco: uma linha = uma transação em conta corrente (PIX, TED, saque). Um grão mais grosso seria "saldo diário por conta".
- Hospital: uma linha = um atendimento (uma consulta ou internação). Mais fino: "um procedimento realizado dentro de um atendimento".
- Telecom: uma linha = uma chamada telefônica ou sessão de dados. Mais grosso: "consumo mensal por linha telefônica".
- Streaming: uma linha = uma sessão de reprodução de um título por um usuário. Mais fino ainda: "um evento de play/pause/seek".
- Logística: uma linha = um evento de rastreio de uma encomenda (postado, em trânsito, entregue).
- Escola: uma linha = uma nota de um aluno em uma avaliação de uma disciplina. Mais grosso: "média final por aluno e disciplina".
- Indústria: uma linha = uma leitura de sensor de uma máquina em um instante. Esse é um grão bem fino — gera bilhões de linhas por ano.
Chave surrogate
Cada dimensão terá uma chave artificial, sequencial, sem significado de negócio: a surrogate key (ex.: branch_sk INTEGER). A chave original do sistema de origem (branch_code VARCHAR) é preservada como atributo, mas quem o fato referencia é a surrogate. Por quê?
- É menor (inteiro vs. string) →
JOINs mais rápidos. - Isola o DW de mudanças no código da origem (se "A" virar "SP-01", o DW não quebra).
- Permite implementar histórico (SCD Tipo 2) quando necessário.
8. Arquitetura, dataset e ambiente
Arquitetura em camadas
Nosso DW não será uma tabela só: será organizado em três schemas dentro do banco PostgreSQL, cada um com uma responsabilidade clara.
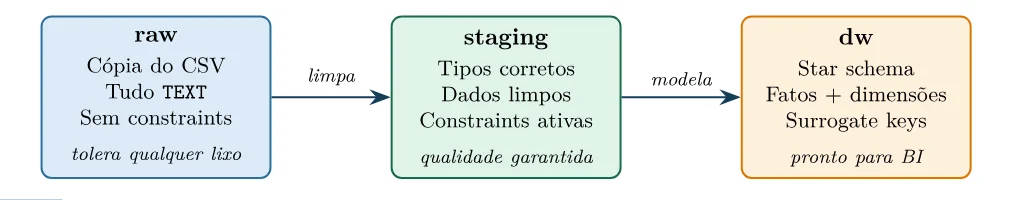
As camadas raw, staging e dw.
O dataset: Supermarket Sales
Usaremos o dataset Supermarket Sales do Kaggle — um único CSV com 1.000 linhas representando vendas fictícias de três filiais de um supermercado em Mianmar (Yangon, Mandalay e Naypyitaw), coletadas entre janeiro e março de 2019.
https://www.kaggle.com/datasets/faresashraf1001/supermarket-sales
| Coluna | Tipo | Descrição |
|---|---|---|
| Invoice ID | texto | Identificador único da venda |
| Branch | texto | Filial (A, B ou C) |
| City | texto | Cidade da filial |
| Customer type | texto | Member ou Normal |
| Gender | texto | Male ou Female |
| Product line | texto | Categoria (6 valores) |
| Unit price | número | Preço unitário |
| Quantity | inteiro | Quantidade |
| Tax 5% | número | Imposto |
| Total | número | Valor total pago |
| Date | data | Data da venda |
| Time | hora | Hora da venda |
| Payment | texto | Cash / Credit card / Ewallet |
| cogs | número | Custo das mercadorias vendidas |
| gross margin percentage | número | Margem bruta (%) |
| gross income | número | Lucro bruto |
| Rating | número | Avaliação do cliente (4 a 10) |
Ambiente mínimo
Só precisamos de duas coisas:
- PostgreSQL 14+ — https://www.postgresql.org/download/
- pgAdmin 4+ — https://www.pgadmin.org/download/
No pgAdmin, registre o servidor local e crie o banco (Databases → Create → Database..., nome supermarket_dw, Encoding UTF8).
9. Schemas e camada RAW
Criando os schemas
Fase — preparação
Ainda não estamos em E, T ou L: estamos construindo as "prateleiras" onde os dados vão morar. Cada schema corresponde a um estágio do pipeline.
Com o banco supermarket_dw criado, abra a Query Tool no pgAdmin (ícone de raio com o banco selecionado) e execute:
Código 1 · Criação dos três schemas
CREATE SCHEMA IF NOT EXISTS raw;
CREATE SCHEMA IF NOT EXISTS staging;
CREATE SCHEMA IF NOT EXISTS dw;

-- Conferencia
SELECT schema_name
FROM information_schema.schemata
WHERE schema_name IN ('raw','staging','dw');
A última consulta deve retornar três linhas. Agora o banco está estruturado para receber os dados.
Camada RAW: criação e importação
Fase E — Extract
Aqui extraímos os dados do arquivo CSV e os trazemos para dentro do banco sem alterar absolutamente nada. Nenhuma transformação acontece nesta seção: o objetivo é só garantir que o dado saiu da origem e chegou inteiro.
A tabela raw.sales será um espelho fiel do CSV: todas as colunas do tipo TEXT, sem nenhuma restrição. É propositalmente permissiva.
Código 2 · DDL de raw.sales
DROP TABLE IF EXISTS raw.sales CASCADE;
CREATE TABLE raw.sales (
    invoice_id TEXT,
    branch TEXT,
    city TEXT,
    customer_type TEXT,
    gender TEXT,
    product_line TEXT,
    unit_price TEXT,
    quantity TEXT,
    tax_5pct TEXT,
    total TEXT,
    sale_date TEXT,
    sale_time TEXT,
    payment TEXT,
    cogs TEXT,
    gross_margin_percentage TEXT,
    gross_income TEXT,
    rating TEXT
);
Importando o CSV pelo pgAdmin
Com a tabela criada, clique com o botão direito em raw.sales na árvore de objetos do pgAdmin e selecione Import/Export Data....
| Aba General | Aba Options | Aba Columns |
|---|---|---|
| Direction: Import | Header: ligar | Deixe todas marcadas |
Filename: selecione o supermarket_sales.csv |
Delimiter: , |
Mantenha a ordem |
| Format: csv | Quote: " |
Clique em OK |
| Encoding: UTF8 | Escape: " |
Após alguns segundos, uma notificação verde indica sucesso. Valide:
Código 3 · Validação pós-importação
SELECT COUNT(*) FROM raw.sales; -- deve retornar 1000
SELECT * FROM raw.sales LIMIT 3;
10. Staging: tipos e textos
Fase T — Transform
Começa a transformação. Os dados já estão no banco, mas todos como texto e sem garantia nenhuma de qualidade. Nesta seção convertemos tipos, padronizamos textos e aplicamos constraints — é aqui que o dado "vira dado".
Criando a tabela staging
Código 4 · DDL de staging.sales
DROP TABLE IF EXISTS staging.sales CASCADE;
CREATE TABLE staging.sales (
    invoice_id VARCHAR(20) PRIMARY KEY,
    branch CHAR(1) NOT NULL,
    city VARCHAR(40) NOT NULL,
    customer_type VARCHAR(10) NOT NULL,
    gender VARCHAR(10) NOT NULL,
    product_line VARCHAR(40) NOT NULL,
    unit_price NUMERIC(10,2) NOT NULL,
    quantity INTEGER NOT NULL,
    tax_5pct NUMERIC(10,4) NOT NULL,
    total NUMERIC(12,2) NOT NULL,
    sale_ts TIMESTAMP NOT NULL,
    payment VARCHAR(20) NOT NULL,
    cogs NUMERIC(12,2) NOT NULL,
    gross_income NUMERIC(10,4) NOT NULL,
    rating NUMERIC(4,1) NOT NULL
);
Construindo o ETL passo a passo
Vamos montar o INSERT em quatro passos, cada um acrescentando um bloco de colunas. As linhas acrescentadas em cada versão levam o comentário -- novo à direita.
Passo 1 — apenas identificação
Começamos mapeando o invoice_id, já aplicando TRIM:
Código 5 · ETL staging — Passo 1
INSERT INTO staging.sales (invoice_id)
SELECT TRIM(invoice_id)
FROM raw.sales;
Passo 2 — campos categóricos
Código 6 · ETL staging — Passo 2 (adiciona categóricos)
INSERT INTO staging.sales (
    invoice_id,
    branch, city, customer_type, -- novo
    gender, product_line, payment -- novo
)
SELECT
    TRIM(invoice_id),
    UPPER(TRIM(branch)), -- novo
    INITCAP(TRIM(city)), -- novo
    INITCAP(TRIM(customer_type)), -- novo
    INITCAP(TRIM(gender)), -- novo
    INITCAP(TRIM(product_line)), -- novo
    INITCAP(TRIM(payment)) -- novo
FROM raw.sales;
11. Staging: números e datas
Passo 3 — valores numéricos com CAST
Código 7 · ETL staging — Passo 3 (adiciona numéricos)
INSERT INTO staging.sales (
    invoice_id, branch, city, customer_type,
    gender, product_line, payment,
    unit_price, quantity, tax_5pct, -- novo
    total, cogs, gross_income, rating -- novo
)
SELECT
    TRIM(invoice_id),
    UPPER(TRIM(branch)),
    INITCAP(TRIM(city)),
    INITCAP(TRIM(customer_type)),
    INITCAP(TRIM(gender)),
    INITCAP(TRIM(product_line)),
    INITCAP(TRIM(payment)),
    CAST(TRIM(unit_price) AS NUMERIC(10,2)), -- novo
    CAST(TRIM(quantity) AS INTEGER), -- novo
    CAST(TRIM(tax_5pct) AS NUMERIC(10,4)), -- novo
    CAST(TRIM(total) AS NUMERIC(12,2)), -- novo
    CAST(TRIM(cogs) AS NUMERIC(12,2)), -- novo
    CAST(TRIM(gross_income) AS NUMERIC(10,4)), -- novo
    CAST(TRIM(rating) AS NUMERIC(4,1)) -- novo
FROM raw.sales;
Passo 4 — data e hora unidas
O CSV traz sale_date (1/5/2019) e sale_time (13:08) em colunas separadas. Vamos concatenar e converter para TIMESTAMP.
Código 8 · ETL staging — Passo 4 (versão final)
TRUNCATE TABLE staging.sales; -- novo

INSERT INTO staging.sales (
    invoice_id, branch, city, customer_type,
    gender, product_line, payment,
    unit_price, quantity, tax_5pct,
    total, cogs, gross_income, rating,
    sale_ts -- novo
)
SELECT
    TRIM(invoice_id),
    UPPER(TRIM(branch)),
    INITCAP(TRIM(city)),
    INITCAP(TRIM(customer_type)),
    INITCAP(TRIM(gender)),
    INITCAP(TRIM(product_line)),
    INITCAP(TRIM(payment)),
    CAST(TRIM(unit_price) AS NUMERIC(10,2)),
    CAST(TRIM(quantity) AS INTEGER),
    CAST(TRIM(tax_5pct) AS NUMERIC(10,4)),
    CAST(TRIM(total) AS NUMERIC(12,2)),
    CAST(TRIM(cogs) AS NUMERIC(12,2)),
    CAST(TRIM(gross_income) AS NUMERIC(10,4)),
    CAST(TRIM(rating) AS NUMERIC(4,1)),
    TO_TIMESTAMP( -- novo
        TRIM(sale_date) || ' ' || TRIM(sale_time), -- novo
        'MM/DD/YYYY HH24:MI' -- novo
    ) -- novo
FROM raw.sales
WHERE TRIM(invoice_id) <> ''; -- novo

-- Conferencia
SELECT COUNT(*) FROM staging.sales; -- 1000
SELECT * FROM staging.sales LIMIT 3;
12. O star schema e o generate_series
Fase T + L — Transform e Load
Esta é a etapa final do pipeline. Ainda há transformação (separar contexto de métrica, gerar surrogate keys), mas o resultado já é o Load: as tabelas que o BI vai consumir. Quando esta seção terminar, o dado estará "entregue".
Nosso star schema
Olhando para os dados, identificamos as dimensões (contextos descritivos) e a fato (evento mensurável):
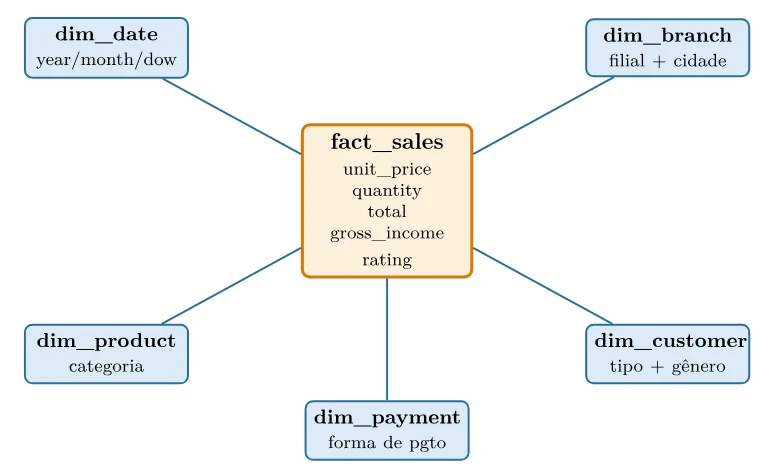
O star schema do Supermarket Sales.
Entendendo o generate_series antes de usá-lo
A dim_date é especial: ela não vem da origem. Nós a fabricamos, e a ferramenta para isso é a função generate_series, que produz uma sequência de valores — uma linha para cada elemento. Ela funciona com números:
Código 9 · generate_series com números
SELECT * FROM generate_series(1, 5);
SELECT * FROM generate_series(0, 100, 25); -- com passo de 25
| generate_series(1, 5) | generate_series(0, 100, 25) |
|---|---|
| 1 | 0 |
| 2 | 25 |
| 3 | 50 |
| 4 | 75 |
| 5 | 100 |
Figura 10: Com números, o terceiro argumento é o passo. Sem ele, o padrão é 1.
E funciona com datas, onde o passo é um INTERVAL:
Código 10 · generate_series com datas
SELECT d
FROM generate_series(DATE '2019-01-01',
                     DATE '2019-01-05',
                     INTERVAL '1 day') g(d);
| INTERVAL '1 day' | INTERVAL '1 month' (jan–mai) |
|---|---|
| 2019-01-01 00:00:00 | 2019-01-01 00:00:00 |
| 2019-01-02 00:00:00 | 2019-02-01 00:00:00 |
| 2019-01-03 00:00:00 | 2019-03-01 00:00:00 |
| 2019-01-04 00:00:00 | 2019-04-01 00:00:00 |
| 2019-01-05 00:00:00 | 2019-05-01 00:00:00 |
Figura 11: Com datas, o passo é um INTERVAL. Trocando '1 day' por '1 month' ou '1 hour', a mesma função gera calendários mensais ou séries horárias.
O trecho g(d) é apenas um alias: batiza a tabela resultante de g e sua única coluna de d, para podermos escrever d no SELECT.
13. As dimensões
dim_date
Código 11 · DDL e carga de dw.dim_date
DROP TABLE IF EXISTS dw.dim_date CASCADE;
CREATE TABLE dw.dim_date (
    date_sk INTEGER PRIMARY KEY, -- YYYYMMDD
    full_date DATE NOT NULL UNIQUE,
    day SMALLINT NOT NULL,
    month SMALLINT NOT NULL,
    month_name VARCHAR(15) NOT NULL,
    quarter SMALLINT NOT NULL,
    year SMALLINT NOT NULL,
    day_of_week VARCHAR(15) NOT NULL,
    is_weekend BOOLEAN NOT NULL
);

INSERT INTO dw.dim_date
SELECT
    CAST(TO_CHAR(d, 'YYYYMMDD') AS INTEGER),
    d::DATE,
    EXTRACT(DAY FROM d)::SMALLINT,
    EXTRACT(MONTH FROM d)::SMALLINT,
    TO_CHAR(d, 'TMMonth'),
    EXTRACT(QUARTER FROM d)::SMALLINT,
    EXTRACT(YEAR FROM d)::SMALLINT,
    TO_CHAR(d, 'TMDay'),
    EXTRACT(DOW FROM d) IN (0, 6)
FROM generate_series(DATE '2019-01-01', DATE '2019-12-31', INTERVAL '1 day') g(d);

SELECT COUNT(*) FROM dw.dim_date; -- 365
dim_branch, dim_product, dim_customer e dim_payment
São dimensões pequenas, então criamos as quatro juntas:
Código 12 · DDL das demais dimensões
-- dim_branch -----------------------------------------------
DROP TABLE IF EXISTS dw.dim_branch CASCADE;
CREATE TABLE dw.dim_branch (
    branch_sk SERIAL PRIMARY KEY,
    branch_code CHAR(1) NOT NULL UNIQUE,
    city VARCHAR(40) NOT NULL
);

-- dim_product ----------------------------------------------
DROP TABLE IF EXISTS dw.dim_product CASCADE;
CREATE TABLE dw.dim_product (
    product_sk SERIAL PRIMARY KEY,
    product_line VARCHAR(40) NOT NULL UNIQUE
);

-- dim_customer (segmento) ----------------------------------
DROP TABLE IF EXISTS dw.dim_customer CASCADE;
CREATE TABLE dw.dim_customer (
    customer_sk SERIAL PRIMARY KEY,
    customer_type VARCHAR(10) NOT NULL,
    gender VARCHAR(10) NOT NULL,
    UNIQUE (customer_type, gender)
);

-- dim_payment ----------------------------------------------
DROP TABLE IF EXISTS dw.dim_payment CASCADE;
CREATE TABLE dw.dim_payment (
    payment_sk SERIAL PRIMARY KEY,
    payment_type VARCHAR(20) NOT NULL UNIQUE
);
A carga de cada dimensão é um DISTINCT sobre a staging — pegamos os valores únicos de cada contexto:
Código 13 · Cargas das dimensões
INSERT INTO dw.dim_branch (branch_code, city)
SELECT DISTINCT branch, city FROM staging.sales;

INSERT INTO dw.dim_product (product_line)
SELECT DISTINCT product_line FROM staging.sales;

INSERT INTO dw.dim_customer (customer_type, gender)
SELECT DISTINCT customer_type, gender FROM staging.sales;

INSERT INTO dw.dim_payment (payment_type)
SELECT DISTINCT payment FROM staging.sales;
Para conferir tudo de uma vez, queremos empilhar quatro contagens em uma única saída. Quem faz isso é o UNION ALL:
Código 14 · Conferência das dimensões com UNION ALL
SELECT 'branch' AS dimensao, COUNT(*) AS linhas FROM dw.dim_branch
UNION ALL
SELECT 'product', COUNT(*) FROM dw.dim_product
UNION ALL
SELECT 'customer', COUNT(*) FROM dw.dim_customer
UNION ALL
SELECT 'payment', COUNT(*) FROM dw.dim_payment;
14. A tabela fato
Passo 1 — a estrutura
A fato tem chave natural (invoice_nk), chaves estrangeiras para as cinco dimensões e as métricas:
Código 15 · fact_sales — DDL
DROP TABLE IF EXISTS dw.fact_sales CASCADE;
CREATE TABLE dw.fact_sales (
    invoice_nk VARCHAR(20) PRIMARY KEY, -- dimensao degenerada
    date_sk INTEGER NOT NULL REFERENCES dw.dim_date(date_sk),
    branch_sk INTEGER NOT NULL REFERENCES dw.dim_branch(branch_sk),
    product_sk INTEGER NOT NULL REFERENCES dw.dim_product(product_sk),
    customer_sk INTEGER NOT NULL REFERENCES dw.dim_customer(customer_sk),
    payment_sk INTEGER NOT NULL REFERENCES dw.dim_payment(payment_sk),
    unit_price NUMERIC(10,2) NOT NULL,
    quantity INTEGER NOT NULL,
    total NUMERIC(12,2) NOT NULL,
    tax NUMERIC(10,4) NOT NULL,
    cogs NUMERIC(12,2) NOT NULL,
    gross_income NUMERIC(10,4) NOT NULL,
    rating NUMERIC(4,1) NOT NULL
);

CREATE INDEX ix_fs_date ON dw.fact_sales(date_sk);
CREATE INDEX ix_fs_branch ON dw.fact_sales(branch_sk);
CREATE INDEX ix_fs_product ON dw.fact_sales(product_sk);
CREATE INDEX ix_fs_customer ON dw.fact_sales(customer_sk);
CREATE INDEX ix_fs_payment ON dw.fact_sales(payment_sk);
Passo 2 — chave e métricas
Código 16 · fact_sales — Passo 2 (só métricas)
INSERT INTO dw.fact_sales (
    invoice_nk,
    unit_price, quantity, total, tax, cogs, gross_income, rating
)
SELECT
    s.invoice_id,
    s.unit_price, s.quantity, s.total,
    s.tax_5pct, s.cogs, s.gross_income, s.rating
FROM staging.sales s;
Passo 3 — a chave de data
Código 17 · fact_sales — Passo 3 (soma date_sk)
INSERT INTO dw.fact_sales (
    invoice_nk, date_sk, -- novo: date_sk
    unit_price, quantity, total, tax, cogs, gross_income, rating
)
SELECT
    s.invoice_id,
    CAST(TO_CHAR(s.sale_ts, 'YYYYMMDD') AS INTEGER), -- novo
    s.unit_price, s.quantity, s.total,
    s.tax_5pct, s.cogs, s.gross_income, s.rating
FROM staging.sales s;
Passo 4 — as demais chaves via JOIN
Código 18 · fact_sales — Passo 4 (completa)
TRUNCATE TABLE dw.fact_sales; -- novo

INSERT INTO dw.fact_sales (
    invoice_nk, date_sk,
    branch_sk, product_sk, customer_sk, payment_sk, -- novo
    unit_price, quantity, total, tax, cogs, gross_income, rating
)
SELECT
    s.invoice_id,
    CAST(TO_CHAR(s.sale_ts, 'YYYYMMDD') AS INTEGER),
    db.branch_sk, -- novo
    dp.product_sk, -- novo
    dc.customer_sk, -- novo
    dpa.payment_sk, -- novo
    s.unit_price, s.quantity, s.total,
    s.tax_5pct, s.cogs, s.gross_income, s.rating
FROM staging.sales s
JOIN dw.dim_branch db ON db.branch_code = s.branch -- novo
JOIN dw.dim_product dp ON dp.product_line = s.product_line -- novo
JOIN dw.dim_customer dc ON dc.customer_type = s.customer_type -- novo
    AND dc.gender = s.gender -- novo
JOIN dw.dim_payment dpa ON dpa.payment_type = s.payment; -- novo

SELECT COUNT(*) FROM dw.fact_sales; -- 1000
15. PL/pgSQL: cursor para a curva ABC
Até aqui tudo foi SQL puro — declarativo, sem laços, sem variáveis. O PostgreSQL também aceita uma linguagem procedural embutida, o PL/pgSQL, que permite escrever funções, laços, condicionais e gatilhos dentro do banco. Vamos usá-la em duas situações típicas de um DW: uma análise que precisa de memória entre linhas (cursor) e uma regra que precisa disparar sozinha (trigger).
Um cursor para a curva ABC
Uma análise ABC (ou análise de Pareto) ordena os produtos do mais lucrativo para o menos lucrativo e vai acumulando o percentual do lucro total. Os produtos que somam os primeiros 80% formam a curva A; até 95%, a curva B; o resto, a curva C.
Repare no "vai acumulando": para classificar uma linha é preciso saber o que aconteceu nas linhas anteriores. É exatamente aí que um cursor se encaixa — ele permite percorrer o resultado de uma consulta uma linha por vez, guardando estado em variáveis.
Código 19 · Tabela de destino da análise ABC
DROP TABLE IF EXISTS dw.abc_product;
CREATE TABLE dw.abc_product (
    product_line VARCHAR(40) PRIMARY KEY,
    lucro NUMERIC(12,2),
    perc_acumulado NUMERIC(6,2),
    curva CHAR(1)
);
Código 20 · Procedimento com cursor em PL/pgSQL
CREATE OR REPLACE FUNCTION dw.calcula_curva_abc()
RETURNS INTEGER AS $
DECLARE
    -- 1) declaracao do cursor: a consulta que sera percorrida
    c_prod CURSOR FOR
        SELECT p.product_line,
               SUM(f.gross_income)::NUMERIC(12,2) AS lucro
        FROM dw.fact_sales f
        JOIN dw.dim_product p ON p.product_sk = f.product_sk
        GROUP BY p.product_line
        ORDER BY lucro DESC;

    r_prod RECORD;          -- variavel que recebe cada linha
    v_total NUMERIC(12,2);  -- lucro total de todas as categorias
    v_acum NUMERIC(12,2) := 0;
    v_perc NUMERIC(6,2);
    v_curva CHAR(1);
    v_linhas INTEGER := 0;
BEGIN
    TRUNCATE TABLE dw.abc_product;

    SELECT SUM(gross_income) INTO v_total FROM dw.fact_sales;

    OPEN c_prod;                  -- 2) abre o cursor
    LOOP
        FETCH c_prod INTO r_prod; -- 3) pega a proxima linha
        EXIT WHEN NOT FOUND;      -- 4) acabou? sai do laco

        v_acum := v_acum + r_prod.lucro;
        v_perc := ROUND(100 * v_acum / v_total, 2);

        IF v_perc <= 80 THEN v_curva := 'A';
        ELSIF v_perc <= 95 THEN v_curva := 'B';
        ELSE v_curva := 'C';
        END IF;

        INSERT INTO dw.abc_product
        VALUES (r_prod.product_line, r_prod.lucro, v_perc, v_curva);

        v_linhas := v_linhas + 1;
        RAISE NOTICE 'Categoria % -> curva % (acumulado %%%)',
            r_prod.product_line, v_curva, v_perc;
    END LOOP;
    CLOSE c_prod;                 -- 5) fecha o cursor

    RETURN v_linhas;
END;
$ LANGUAGE plpgsql;

-- executa e confere
SELECT dw.calcula_curva_abc();
SELECT * FROM dw.abc_product ORDER BY perc_acumulado;
16. PL/pgSQL: trigger para auditar a fato
Um trigger (gatilho) é um procedimento que o banco dispara automaticamente quando algo acontece em uma tabela. Ninguém o chama: ele reage. É o mecanismo natural para regras que precisam valer sempre, independentemente de quem escreveu o INSERT.
Vamos criar um que faz duas coisas ao inserir na fato: valida a linha e registra a operação em uma tabela de log.
Código 21 · Tabela de log e função do trigger
DROP TABLE IF EXISTS dw.fact_sales_log;
CREATE TABLE dw.fact_sales_log (
    log_id SERIAL PRIMARY KEY,
    invoice_nk VARCHAR(20),
    operacao VARCHAR(10),
    usuario VARCHAR(60),
    momento TIMESTAMP
);

CREATE OR REPLACE FUNCTION dw.audita_fact_sales()
RETURNS TRIGGER AS $
BEGIN
    -- validacao: nao aceitamos venda sem itens
    IF NEW.quantity <= 0 THEN
        RAISE EXCEPTION 'Venda % rejeitada: quantidade invalida (%)',
            NEW.invoice_nk, NEW.quantity;
    END IF;

    -- validacao: a nota do cliente vai de 4 a 10 neste dataset
    IF NEW.rating < 4 OR NEW.rating > 10 THEN
        RAISE EXCEPTION 'Venda % rejeitada: rating fora da faixa (%)',
            NEW.invoice_nk, NEW.rating;
    END IF;

    -- auditoria
    INSERT INTO dw.fact_sales_log (invoice_nk, operacao, usuario, momento)
    VALUES (NEW.invoice_nk, TG_OP, CURRENT_USER, NOW());

    RETURN NEW; -- devolve a linha para que o INSERT prossiga
END;
$ LANGUAGE plpgsql;
Código 22 · Criando e testando o trigger
DROP TRIGGER IF EXISTS trg_audita_fact_sales ON dw.fact_sales;

CREATE TRIGGER trg_audita_fact_sales
BEFORE INSERT ON dw.fact_sales
FOR EACH ROW
EXECUTE FUNCTION dw.audita_fact_sales();

-- teste 1: linha valida -> entra e gera log
INSERT INTO dw.fact_sales VALUES
('999-99-9999', 20190315, 1, 1, 1, 1, 10.00, 2, 21.00, 1.00, 20.00, 1.00, 9.0);

-- teste 2: linha invalida -> o trigger aborta o INSERT
INSERT INTO dw.fact_sales VALUES
('888-88-8888', 20190315, 1, 1, 1, 1, 10.00, 0, 21.00, 1.00, 20.00, 1.00, 9.0);

SELECT * FROM dw.fact_sales_log;

-- limpeza do teste
DELETE FROM dw.fact_sales WHERE invoice_nk = '999-99-9999';
17. Consultas analíticas: filial e categoria
Chegamos ao propósito final do DW: responder perguntas de negócio com SQL simples. Todas as consultas abaixo seguem a mesma receita — fato JOIN dimensões, GROUP BY em atributos de dimensão, agregações sobre as métricas da fato. Essa uniformidade é o grande prêmio da modelagem dimensional.
P1 — Receita por filial e mês
Código 23 · Receita mensal por filial
SELECT
    d.year,
    d.month_name,
    b.branch_code AS filial,
    b.city,
    COUNT(*) AS vendas,
    SUM(f.total)::NUMERIC(12,2) AS receita,
    ROUND(AVG(f.total), 2) AS ticket_medio
FROM dw.fact_sales f
JOIN dw.dim_date d ON d.date_sk = f.date_sk
JOIN dw.dim_branch b ON b.branch_sk = f.branch_sk
GROUP BY d.year, d.month, d.month_name, b.branch_code, b.city
ORDER BY d.month, filial;
O que está acontecendo. Esta é a consulta mais clássica de um DW: um cruzamento tempo × local. Partimos da fato e trazemos dois contextos — a data (dim_date) e a filial (dim_branch). O GROUP BY define o nível em que o detalhe será colapsado: cada linha do resultado passa a representar "um mês de uma filial", não mais uma venda.
As três agregações respondem a perguntas diferentes sobre o mesmo grupo:
COUNT(*)— volume: quantas vendas aconteceram.SUM(f.total)— faturamento: quanto dinheiro entrou.AVG(f.total)— ticket médio: quanto vale, em média, cada compra.
Volume e faturamento contam histórias diferentes: uma filial pode faturar mais vendendo menos vezes, se cada compra for maior. É por isso que o ticket médio quase nunca falta em um relatório de varejo.
Repare em GROUP BY d.year, d.month, d.month_name: agrupamos por d.month (o número) mesmo sem exibi-lo, porque é ele que permite ordenar os meses cronologicamente. Ordenar por month_name colocaria Abril antes de Janeiro — ordem alfabética.
P2 — Categorias mais lucrativas
Código 24 · Ranking de categorias por lucro bruto
SELECT
    p.product_line AS categoria,
    COUNT(*) AS vendas,
    SUM(f.quantity) AS itens_vendidos,
    SUM(f.total)::NUMERIC(12,2) AS receita,
    SUM(f.gross_income)::NUMERIC(12,2) AS lucro_bruto,
    ROUND(AVG(f.rating), 2) AS avaliacao_media
FROM dw.fact_sales f
JOIN dw.dim_product p ON p.product_sk = f.product_sk
GROUP BY p.product_line
ORDER BY lucro_bruto DESC;
O que está acontecendo. Aqui um único JOIN basta, porque a pergunta tem uma só dimensão: produto. O resultado terá exatamente 6 linhas — uma por categoria do dataset.
O ponto interessante é a coexistência de receita e lucro_bruto. Elas não andam necessariamente juntas: uma categoria de alto giro e margem apertada pode liderar a receita e ficar no meio do ranking de lucro. Ordenamos por lucro porque, no fim, é o lucro que paga a operação — mas manter as duas colunas lado a lado é o que torna a comparação visível.
SUM(f.quantity) soma itens, enquanto COUNT(*) conta cupons. Dividir um pelo outro daria os itens por compra — outro indicador clássico. E o AVG(f.rating) coloca a satisfação do cliente ao lado do dinheiro: uma categoria muito lucrativa e mal avaliada é um risco de médio prazo, não uma vitória.
18. Consultas analíticas: cliente e dia da semana
P3 — Comportamento por gênero e tipo de cliente
Código 25 · Análise por segmento de cliente
SELECT
    c.customer_type AS tipo,
    c.gender AS genero,
    COUNT(*) AS vendas,
    ROUND(AVG(f.total), 2) AS ticket_medio,
    ROUND(AVG(f.rating), 2) AS avaliacao_media,
    ROUND(AVG(f.quantity), 2) AS itens_medio
FROM dw.fact_sales f
JOIN dw.dim_customer c ON c.customer_sk = f.customer_sk
GROUP BY c.customer_type, c.gender
ORDER BY tipo, genero;
O que está acontecendo. O GROUP BY com duas colunas da mesma dimensão cria uma grade: Member/Female, Member/Male, Normal/Female, Normal/Male — 4 linhas, todas as combinações que existem nos dados.
Note que aqui quase tudo é média, não soma. É deliberado: os quatro segmentos não têm o mesmo tamanho, e comparar somas seria comparar o tamanho dos grupos, não o comportamento deles. A média neutraliza isso. Mantivemos o COUNT(*) justamente para saber sobre quantas vendas cada média foi calculada — uma média de 5 vendas não merece a mesma confiança que uma de 300.
A pergunta de negócio por trás: o programa de fidelidade (Member) está entregando o que promete? Se o ticket médio dos membros não for maior que o dos clientes normais, o desconto que eles recebem está saindo de graça.
P4 — Dia da semana mais forte
Código 26 · Vendas por dia da semana
SELECT
    d.day_of_week AS dia_semana,
    d.is_weekend AS fim_de_semana,
    COUNT(*) AS vendas,
    SUM(f.total)::NUMERIC(12,2) AS receita,
    ROUND(AVG(f.rating), 2) AS avaliacao_media
FROM dw.fact_sales f
JOIN dw.dim_date d ON d.date_sk = f.date_sk
GROUP BY d.day_of_week, d.is_weekend
ORDER BY receita DESC;
O que está acontecendo. Esta consulta mostra por que vale a pena ter uma dim_date rica. Os atributos day_of_week e is_weekend não existem em lugar nenhum do CSV original — nós os calculamos uma única vez, ao gerar a dimensão. Agora qualquer analista responde "sábado vende mais?" sem saber o que é EXTRACT(DOW ...).
É o oposto de agregar no tempo: aqui ignoramos a linha do tempo e empilhamos todas as terças-feiras de 2019 numa única linha, procurando um padrão cíclico. Esse tipo de resposta alimenta decisões muito concretas: escala de funcionários, dia da reposição de estoque, quando lançar uma promoção.
is_weekend entra no GROUP BY sem alterar os grupos — ele é totalmente determinado pelo dia da semana. Está ali só para permitir sua exibição, já que toda coluna do SELECT que não está dentro de uma função de agregação precisa estar no GROUP BY. É um truque comum e inofensivo.
19. Cubo OLAP
Todas as consultas do passo anterior tinham a mesma forma. Trocamos a dimensão do GROUP BY — filial, produto, cliente, dia da semana — e a estrutura continuou idêntica. Isso não é coincidência: é o sintoma de que existe uma única estrutura por trás de todas elas. Essa estrutura é o cubo.
Um cubo OLAP (ou cubo de dados) é a visão do star schema como um espaço de várias dimensões, onde cada célula guarda uma métrica já agregada. Se as dimensões são tempo, produto e filial, então a célula (Março, Bebidas, Filial B) contém a receita daquela combinação — pronta, sem precisar somar nada na hora.
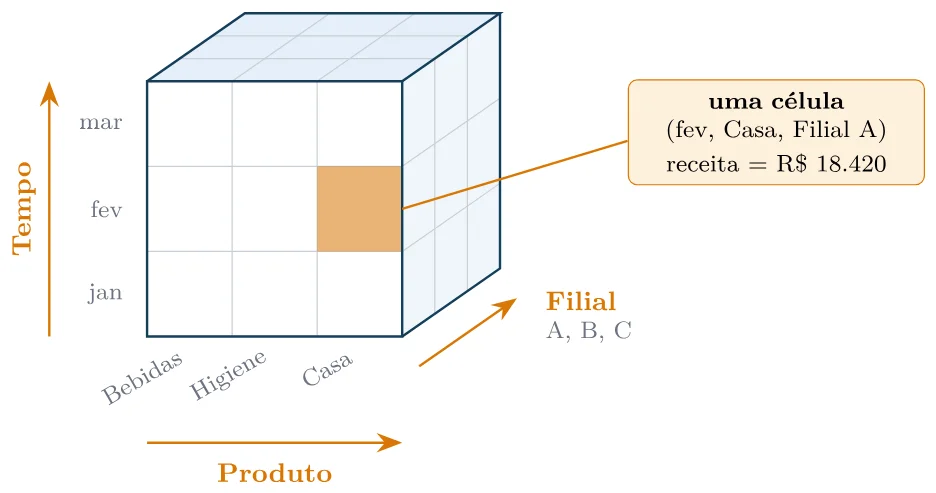
Figura 12: O cubo de dados. Cada eixo é uma dimensão; cada célula, uma métrica já agregada. Com 5 dimensões o desenho seria impossível, mas a ideia é a mesma — por isso se fala em hipercubo.
As quatro operações do cubo
O vocabulário abaixo é usado em qualquer ferramenta de BI do mercado. Você já executou todas elas em SQL, sem saber os nomes:
- Slice (fatiar) — fixa uma dimensão em um valor e olha o plano resultante. Ex.: "só março". Em SQL:
WHERE d.month = 3. - Dice (recortar) — restringe várias dimensões a subconjuntos, formando um cubo menor. Ex.: "filiais A e B, no primeiro trimestre, categorias de bebida". Em SQL: um
WHEREcom váriosIN. - Drill-down / Roll-up — desce ou sobe um nível de hierarquia. Em SQL: trocar o que está no
GROUP BY(deyearparamonth, ou demonthparaday). - Pivot (girar) — troca quais dimensões ficam nas linhas e quais ficam nas colunas. É o que a tabela dinâmica do Excel faz quando você arrasta um campo.
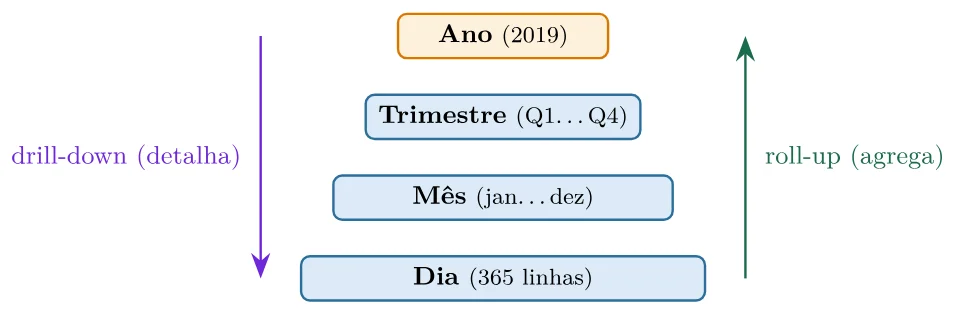
Figura 13: Hierarquia da dimensão tempo. Drill-down desce até o detalhe; roll-up sobe agregando. Toda dimensão bem construída tem pelo menos uma hierarquia dessas.
Cubo no próprio PostgreSQL: GROUPING SETS, ROLLUP e CUBE
Não é preciso um servidor OLAP dedicado para experimentar a ideia. O PostgreSQL implementa os operadores do padrão SQL que calculam vários níveis de agregação em uma única passada:
Código 27 · Subtotais automáticos com ROLLUP e CUBE
-- ROLLUP: hierarquia. Gera (filial, mes), (filial), e o total geral.
SELECT
    b.branch_code AS filial,
    d.month_name AS mes,
    SUM(f.total)::NUMERIC(12,2) AS receita
FROM dw.fact_sales f
JOIN dw.dim_branch b ON b.branch_sk = f.branch_sk
JOIN dw.dim_date d ON d.date_sk = f.date_sk
GROUP BY ROLLUP (b.branch_code, d.month_name)
ORDER BY b.branch_code, d.month_name;

-- CUBE: TODAS as combinacoes possiveis das dimensoes listadas.
-- (filial, pagamento), (filial), (pagamento) e o total geral.
SELECT
    COALESCE(b.branch_code, 'TODAS') AS filial,
    COALESCE(p.payment_type, 'TODOS') AS pagamento,
    SUM(f.total)::NUMERIC(12,2) AS receita
FROM dw.fact_sales f
JOIN dw.dim_branch b ON b.branch_sk = f.branch_sk
JOIN dw.dim_payment p ON p.payment_sk = f.payment_sk
GROUP BY CUBE (b.branch_code, p.payment_type)
ORDER BY filial, pagamento;
Ferramentas do mercado
Cubos podem ser pré-calculados e armazenados (MOLAP), calculados na hora sobre o star schema (ROLAP) ou uma mistura dos dois (HOLAP). Cada família tem suas ferramentas:
| Categoria | Ferramentas | Observação |
|---|---|---|
| Servidores OLAP clássicos | Microsoft Analysis Services (SSAS), Oracle Essbase, IBM Cognos TM1, SAP BW | Cubos materializados, linguagem MDX. Ainda dominantes em grandes corporações. |
| OLAP open source | Mondrian / Pentaho, Apache Kylin, Apache Druid, ClickHouse, Apache Doris | Kylin pré-computa cubos sobre Hadoop; Druid e ClickHouse resolvem agregações em tempo real. |
| Camada semântica moderna | Cube (cube.dev), dbt Semantic Layer, AtScale, Looker (LookML) | Definem métricas e hierarquias uma vez e geram o SQL para quem consultar. |
| Ferramentas de visualização | Power BI, Tableau, Qlik Sense, Metabase, Apache Superset, Looker Studio | Trazem o cubo para o usuário final: arrastar campos é fazer pivot e drill-down. |
| Planilha | Tabela dinâmica do Excel / Google Sheets | A interface OLAP mais usada do planeta — e a mais subestimada. |
| Dentro do próprio banco | GROUPING SETS, ROLLUP, CUBE, materialized views, extensão cube |
É o que fizemos aqui: PostgreSQL fazendo papel de motor OLAP. |
20. Conclusão
Começamos com um arquivo de texto de 1.000 linhas — o tipo de coisa que qualquer pessoa abriria no Excel e fecharia dez minutos depois sem ter descoberto nada. Terminamos com um Data Warehouse funcional, capaz de responder perguntas de negócio em uma consulta de dez linhas.
O caminho percorrido foi este:
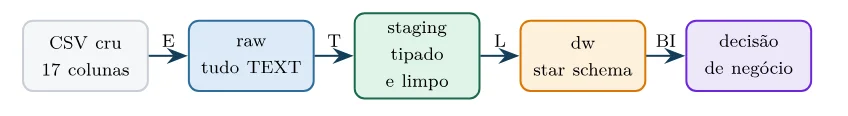
Do CSV cru à decisão de negócio.
E, no caminho, ficaram algumas ideias que valem mais do que o código:
- Camadas existem para que o erro seja barato. A
rawaceita lixo justamente para que a falha aconteça no seuSELECT, e não na importação — com o dado já dentro de casa, disponível para investigação. - Desnormalizar é uma escolha, não um descuido. Você aprendeu as três formas normais para poder abandoná-las com consciência quando o objetivo deixa de ser integridade e passa a ser velocidade de leitura.
- O grão é irreversível. É a única decisão do projeto que você não conserta depois: o detalhe que não foi guardado não volta.
- SQL bem modelado dispensa ferramenta cara. Fizemos ETL, dimensões, fato, auditoria e cubo com PostgreSQL e pgAdmin — sem uma linha de Python.
- O DW não termina em uma tabela. Ele termina em alguém decidindo em qual dia contratar mais gente para o caixa.
Para onde ir a partir daqui
- Mais dados, mais dor: refaça o exercício com Olist, Northwind ou TPC-H. Com múltiplas tabelas de origem aparecem os problemas de verdade — chaves que não batem, duplicatas, dados chegando fora de ordem.
- SCD Tipo 2: com um ID real de cliente, implemente histórico de mudanças. É o conceito que separa quem "já mexeu com DW" de quem sabe modelar.
- Cargas incrementais: pare de dar
TRUNCATEe carregue só o que mudou desde ontem. Muda tudo na arquitetura. - Orquestração: transforme os blocos SQL em modelos do dbt ou tarefas do Airflow, com dependências, testes e reexecução automática.
- Visualização: conecte Metabase, Superset ou Power BI ao schema
dwe veja que, com um star schema bem feito, o dashboard sai quase sozinho. - Otimização: particionamento por data, índices BRIN e materialized views — os recursos que fazem a diferença quando a fato passa de mil para cem milhões de linhas.
A modelagem dimensional é intemporal. As ferramentas mudam; os princípios permanecem.