Introdução a Data Warehouse
Os principais conceitos de Data Warehouse (origem do termo, princípios, Data Lake, Data Virtualization, tabelas fato e dimensão, ETL e ELT) e a construção de um primeiro DW no PostgreSQL com um processo de ETL em Python.
1. Visão geral
Neste material, estudaremos os principais conceitos relacionados a Data Warehouse (DW). Há um consenso de que a expressão "data warehouse" passou a ser utilizada no início da década de 1990. Veja um artigo de Barry Devlin e Paul Murphy, pesquisadores da IBM, no qual o termo aparece de forma estruturada:
https://ieeexplore.ieee.org/document/5387658
Por outro lado, considera-se amplamente que Bill Inmon foi o primeiro autor a oferecer uma definição formal e sistemática para o conceito. Veja:
https://en.wikipedia.org/wiki/Bill_Inmon
O que você vai aprender
- A ideia central e os princípios fundamentais de um DW
- Por que construir um DW e o que é Single Source of Truth
- As diferenças entre Data Warehouse, Data Lake e Data Virtualization
- O que são tabelas dimensão e tabelas fato
- As diferenças entre ETL e ELT
- Como criar as tabelas de um DW no PostgreSQL e carregá-las com um script de ETL em Python
O que você vai precisar
- PostgreSQL instalado
- Python 3 com as bibliotecas
pandasepsycopg2 - O dataset Supermarket Sales, do Kaggle (veja o passo "Construindo um DW")
2. A ideia de um DW
Veja a intuição geral por trás de um sistema de DW. Essa é uma visão simplificada, que não contempla as técnicas usualmente empregadas para a obtenção de uma base integrada.
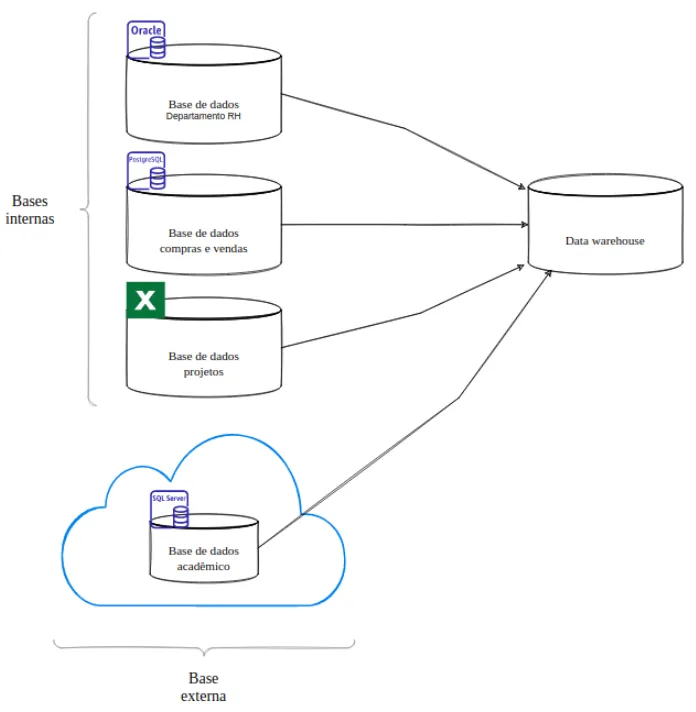
Várias fontes, internas e externas, alimentando um único Data Warehouse.
A ideia central consiste em combinar dados:
- de diferentes fontes
- em diferentes formatos
- históricos e atuais
a fim de obter-se uma base de dados para a geração de relatórios analíticos (focados em análise de dados, identificação de tendências e comparação de informações, visando o apoio à tomada de decisão) com o potencial de auxiliar na tomada de decisão.
Princípios fundamentais
Em geral, a definição de um DW envolve os seguintes princípios:
- Um DW é um ambiente integrado, composto por dados de diferentes fontes.
- Os dados em um DW devem ser organizados por categorias ou assuntos (vendas, clientes, produtos etc.).
- Um DW contém dados históricos e dados atuais.
- Um DW é "não volátil", o que significa que seus dados não são alterados ou sobrescritos. A cada período, novos conjuntos de dados são integrados ao DW para mantê-lo atualizado, mas o conteúdo já armazenado permanece preservado. Assim, durante os processos de carga, o DW continua estável e o histórico não é perdido.
- Um DW é construído com o objetivo de auxiliar na tomada de decisão.
3. Por que um DW, Data Lake e Data Virtualization
Razões para se construir um DW
Veja algumas razões pelas quais estamos interessados em construir um sistema de DW.
- Um DW viabiliza a tomada de decisão baseada em dados ao invés de na simples intuição.
- Um DW é uma única fonte centralizada que pode ser consultada quando necessário. Isso envolve o conceito de Single Source of Truth (SSOT). Veja: https://en.wikipedia.org/wiki/Single_source_of_truth
- Um DW viabiliza a comparação entre dados passados e atuais.
- Um DW possui dados integrados e a sua integração pode trazer à tona informações antes não conhecidas.
Data Warehouse vs. Data Lake
Como discutido, data warehouse é um termo bastante antigo, dos anos 80/90. Por outro lado, Data Lake é bem mais recente, e acredita-se que James Dixon tenha sido o primeiro a utilizar a expressão, em 2011. Veja: https://en.wikipedia.org/wiki/Data_lake
Um Data Lake armazena dados brutos, como arquivos PDF, arquivos de áudio e vídeo, arquivos comuns, mensagens de e-mail. Apesar disso, um Data Lake também pode envolver dados estruturados vindos de uma base de dados relacional, por exemplo.
Data Warehouse vs. Data Virtualization
O objetivo de um sistema de Data Virtualization é o mesmo daquele de um Data Warehouse: fornecer um Single Source of Truth por meio do qual dados possam ser consultados a fim de tomar-se melhores decisões. Entretanto, um sistema de Data Virtualization procura oferecer uma camada de abstração que permite que os dados sejam consultados direto das fontes originais. Quem consulta não precisa saber a forma como eles são armazenados, se são armazenados localmente ou remotamente etc.
Observe que a principal diferença entre Data Virtualization e Data Warehouse é o fato de um sistema de Data Virtualization não fazer cópias dos dados originais e sim consultá-los diretamente na fonte.
Em alguns contextos, Data Virtualization leva também o nome de Virtual Data Warehouse. Veja: https://en.wikipedia.org/wiki/Data_virtualization
4. Tabelas dimensão e fato
Quando construímos um DW, ele é caracterizado por tabelas dimensão e tabela fato.
Tabelas dimensão
As tabelas dimensão armazenam informações descritivas sobre os elementos envolvidos no negócio. Elas respondem "quem", "o quê", "onde", "quando", "como".
Características:
- Contêm dados textuais, descritivos.
- Possuem chaves primárias (ex.:
produto_key). - São usadas para filtrar, agrupar e segmentar análises.
- Geralmente são desnormalizadas no modelo em estrela.
Veja exemplos de tabelas dimensão.
Dim_Produto
| produto_key | nome | categoria | marca |
|---|---|---|---|
| 1 | Camiseta | Vestuário | Nike |
| 2 | Notebook | Eletrônico | Dell |
Dim_Cliente
| cliente_key | nome | cidade | sexo |
|---|---|---|---|
| 10 | Ana Souza | São Paulo | F |
| 11 | João Pereira | Curitiba | M |
Dim_Tempo
| data_key | data | ano | mes | dia |
|---|---|---|---|---|
| 20250110 | 10/01/2025 | 2025 | 1 | 10 |
Tabela fato
A tabela fato contém os eventos do negócio, ou seja, os fatos que acontecem (ex.: vendas, compras, pagamentos). Ela guarda medidas numéricas que podem ser somadas, ter a média calculada, ser contadas etc.
Características:
- Contém medidas (quantidade, valor, total).
- Possui chaves estrangeiras que referenciam as dimensões.
- Pode ter bilhões de linhas.
- É o "centro" do modelo em estrela.
Veja um exemplo de tabela fato.
Fato_Vendas
| data_key | produto_key | cliente_key | quantidade | total |
|---|---|---|---|---|
| 20250110 | 1 | 10 | 2 | 150.00 |
| 20250110 | 2 | 11 | 1 | 3500.00 |
5. ETL vs ELT
A construção de um DW, em geral, é feita por meio de:
- ETL — Extract Transform Load
- ELT — Extract Load Transform
Os processos ETL (Extract–Transform–Load) e ELT (Extract–Load–Transform) constituem abordagens fundamentais para integração de dados em arquiteturas de Data Warehouse. Ambos têm o mesmo objetivo — preparar e disponibilizar dados para consumo analítico —, porém diferem na ordem das etapas, na infraestrutura necessária e no tipo de processamento utilizado.
ETL
Extract (Extração). Coleta de dados de sistemas transacionais, arquivos, APIs ou outras fontes.
Transform (Transformação). Os dados passam por validações, limpeza, normalização, padronização, deduplicação, enriquecimento e aplicação de regras de negócio. Exemplos:
- padronizar formatos (datas, moedas, códigos)
- resolver chaves naturais e gerar chaves substitutas
- estruturar dados no formato dimensional (fatos e dimensões)
Load (Carga). Após transformados, os dados são carregados no DW já consolidados e prontos para consultas.
ELT
No modelo ELT, os dados são extraídos e carregados diretamente no repositório analítico, e as transformações são executadas dentro do próprio DW, utilizando o poder de processamento desse ambiente.
Extract (Extração). Dados são coletados das fontes de forma similar ao ETL.
Load (Carga). Os dados são carregados "brutos" no Data Lake ou DW, normalmente em tabelas staging ou camadas raw.
Transform (Transformação). As transformações são executadas no próprio DW usando SQL massivo e distribuído ou engines paralelas.
6. Construindo um DW: as tabelas
A base que vamos utilizar é a seguinte:
https://www.kaggle.com/datasets/faresashraf1001/supermarket-sales
Crie uma pasta chamada data e salve o arquivo ali.
A seguir, crie um database no PostgreSQL.
pgAdmin · Query Tool
CREATE DATABASE "teste_dw";
Nosso DW será representado pelas seguintes tabelas dimensão e fato. Crie-as conectado ao database teste_dw.
pgAdmin · Query Tool (database teste_dw)
CREATE TABLE dim_tempo (
    data_key INTEGER PRIMARY KEY,
    data DATE,
    ano INTEGER,
    mes INTEGER,
    dia INTEGER
);

CREATE TABLE dim_produto (
    produto_key INTEGER PRIMARY KEY,
    nome VARCHAR(100)
);

CREATE TABLE dim_cliente (
    cliente_key INTEGER PRIMARY KEY,
    tipo VARCHAR(50)
);

CREATE TABLE dim_genero (
    genero_key INTEGER PRIMARY KEY,
    genero VARCHAR(10)
);

CREATE TABLE dim_pagamento (
    pagamento_key INTEGER PRIMARY KEY,
    tipo VARCHAR(20)
);

CREATE TABLE fato_vendas (
    id SERIAL PRIMARY KEY,
    data_key INTEGER REFERENCES dim_tempo(data_key),
    produto_key INTEGER REFERENCES dim_produto(produto_key),
    cliente_key INTEGER REFERENCES dim_cliente(cliente_key),
    genero_key INTEGER REFERENCES dim_genero(genero_key),
    pagamento_key INTEGER REFERENCES dim_pagamento(pagamento_key),
    quantidade INTEGER,
    valor_unitario NUMERIC,
    total NUMERIC,
    rating NUMERIC
);
7. Construindo um DW: o ETL em Python
Faremos o processo de ETL usando Python. Crie um arquivo chamado etl.py. Veja seu conteúdo a seguir. Atenção nos comentários.
Terminal
pip install pandas psycopg2
etl.py
#para representar os dados
import pandas as pd
#para conectar com o banco
import psycopg2

#extracao
df = pd.read_csv("data/supermarket_sales.csv")
print(df.head())

#transformacao
#criando colunas derivadas
df["Date"] = pd.to_datetime(df["Date"])
df["ano"] = df["Date"].dt.year
df["mes"] = df["Date"].dt.month
df["dia"] = df["Date"].dt.day
df["data_key"] = df["Date"].dt.strftime("%Y%m%d").astype(int)

#criando chaves substitutas para dimensoes
#elas serao referenciadas pela tabela fato
df["produto_key"] = df["Product line"].astype('category').cat.codes + 1
df["cliente_key"] = df["Customer type"].astype('category').cat.codes + 1
df["genero_key"] = df["Gender"].astype('category').cat.codes + 1
df["pagamento_key"] = df["Payment"].astype('category').cat.codes + 1

#conectando com o banco
conn = psycopg2.connect(
    host="localhost", database="teste_dw", user="postgres", password="123456"
)
cur = conn.cursor()

# cadastrando dimensões
#tempo
dim_tempo = df[["data_key", "Date", "ano", "mes", "dia"]].drop_duplicates()

for _, row in dim_tempo.iterrows():
    cur.execute("""
        INSERT INTO dim_tempo (data_key, data, ano, mes, dia)
        VALUES (%s, %s, %s, %s, %s)
        ON CONFLICT (data_key) DO NOTHING;
    """, (row["data_key"], row["Date"], row["ano"], row["mes"], row["dia"]))

#produto
dim_produto = df[["produto_key", "Product line"]].drop_duplicates()

for _, row in dim_produto.iterrows():
    cur.execute("""
        INSERT INTO dim_produto (produto_key, nome)
        VALUES (%s, %s)
        ON CONFLICT (produto_key) DO NOTHING;
    """, (row["produto_key"], row["Product line"]))

#cliente
dim_cliente = df[["cliente_key", "Customer type"]].drop_duplicates()

for _, row in dim_cliente.iterrows():
    cur.execute("""
        INSERT INTO dim_cliente (cliente_key, tipo)
        VALUES (%s, %s)
        ON CONFLICT (cliente_key) DO NOTHING;
    """, (row["cliente_key"], row["Customer type"]))

#genero
dim_genero = df[["genero_key", "Gender"]].drop_duplicates()

for _, row in dim_genero.iterrows():
    cur.execute("""
        INSERT INTO dim_genero (genero_key, genero)
        VALUES (%s, %s)
        ON CONFLICT (genero_key) DO NOTHING;
    """, (row["genero_key"], row["Gender"]))

#pagamento
dim_pagamento = df[["pagamento_key", "Payment"]].drop_duplicates()

for _, row in dim_pagamento.iterrows():
    cur.execute("""
        INSERT INTO dim_pagamento (pagamento_key, tipo)
        VALUES (%s, %s)
        ON CONFLICT (pagamento_key) DO NOTHING;
    """, (row["pagamento_key"], row["Payment"]))

#tempo
dim_tempo = df[["data_key", "Date", "ano", "mes", "dia"]].drop_duplicates()

for _, row in dim_tempo.iterrows():
    cur.execute("""
        INSERT INTO dim_tempo (data_key, data, ano, mes, dia)
        VALUES (%s, %s, %s, %s, %s)
        ON CONFLICT (data_key) DO NOTHING;
    """, (
        row["data_key"],
        row["Date"],
        row["ano"],
        row["mes"],
        row["dia"]
    ))

#agora os dados para a tabela fato
fato = df[
    ["data_key", "produto_key", "cliente_key", "genero_key", "pagamento_key",
     "Quantity", "Unit price", "Total", "Rating"]
]

for _, row in fato.iterrows():
    cur.execute("""
        INSERT INTO fato_vendas
        (data_key, produto_key, cliente_key, genero_key, pagamento_key,
         quantidade, valor_unitario, total, rating)
        VALUES (%s,%s,%s,%s,%s,%s,%s,%s,%s);
    """, (
        row["data_key"], row["produto_key"], row["cliente_key"],
        row["genero_key"], row["pagamento_key"],
        row["Quantity"], row["Unit price"], row["Total"], row["Rating"]
    ))

#confirma as insercoes e encerra a conexao
conn.commit()
cur.close()
conn.close()
Execute o script a partir da pasta que contém data/:
Terminal
python etl.py
Ajuste user e password na chamada a psycopg2.connect conforme a sua instalação do PostgreSQL.
8. Encerramento
Parabéns!
Você conheceu os conceitos que fundamentam um Data Warehouse — princípios, fato e dimensão, ETL e ELT — e montou um primeiro DW no PostgreSQL, alimentado por um ETL em Python. Para aprofundar, o codelab Data Warehouse com PostgreSQL: star schema passo a passo constrói um DW com o mesmo dataset inteiramente em SQL, com camadas raw, staging e dw, cursor, trigger e cubo OLAP.