Jornada de Dados: da origem à decisão com Python
A jornada de dados na prática, com Python: a partir de uma base real de vendas de um café, cheia de defeitos, o dado percorre captura, ingestão, armazenamento, tratamento, análise, uso e descarte até virar decisão. Pandas, Parquet, DuckDB, matplotlib, arquitetura medalhão, qualidade de dados, LGPD e Conventional Commits, com exercícios.
1. Das vendas de um café à decisão
Imagine um café que registra cada venda no sistema do caixa: o item, a quantidade, o preço, o total, a forma de pagamento, se o cliente comeu no local ou levou para viagem, e a data. Ao fim de um ano são 10.000 vendas. O dono do café quer usar esses dados para decidir, por exemplo, qual item destacar no cardápio. Parece simples: basta somar e ver quem vendeu mais. O problema é que o arquivo exportado pelo caixa está cheio de defeitos, como acontece com muita frequência na vida real.
A base que vamos usar é a Cafe Sales – Dirty Data for Cleaning Training, publicada no Kaggle (licença CC BY-SA 4.0). A Figura 1 mostra algumas linhas reais do arquivo e o ponto aonde queremos chegar.
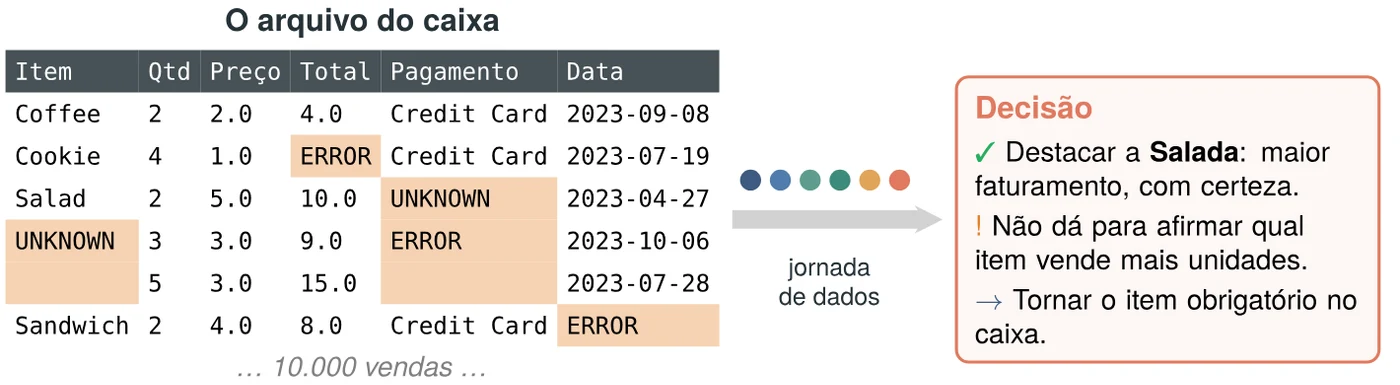
Figura 1. Do arquivo real do caixa, com defeitos destacados, até as decisões a que vamos chegar ao final.
Repare nas células destacadas: ERROR no total, UNKNOWN no pagamento, item em branco, data com ERROR. Só 3 em cada 10 vendas do arquivo estão completas e corretas. Mesmo assim, ao final deste codelab vamos chegar às três conclusões do cartão à direita, sabendo exatamente o quanto confiar em cada uma. Para isso, o dado vai percorrer um caminho com seis fases, a jornada de dados, que é o assunto do próximo passo.
Os atributos da base
A Tabela 1 lista as oito colunas do arquivo, o significado de cada uma, os valores válidos e o nome que ela vai receber depois do tratamento (em português e sem espaços).
| Atributo original | Significado | Valores válidos | Nome tratado |
|---|---|---|---|
| Transaction ID | Identificador único da venda, gerado pelo caixa. | TXN_ seguido de 7 dígitos |
id_transacao |
| Item | Produto vendido. Cada venda tem um único tipo de item. | Coffee, Tea, Sandwich, Salad, Cake, Cookie, Smoothie, Juice | item |
| Quantity | Número de unidades do item levadas na venda. | inteiro de 1 a 5 | quantidade |
| Price Per Unit | Preço de uma unidade do item, conforme o cardápio. | 1,00 a 5,00 | preco_unitario |
| Total Spent | Valor total pago: quantidade × preço unitário. | 1,00 a 25,00 | total |
| Payment Method | Forma de pagamento usada pelo cliente. | Cash, Credit Card, Digital Wallet | forma_pagamento |
| Location | Onde o pedido foi consumido: no salão ou para viagem. | In-store, Takeaway | local |
| Transaction Date | Dia em que a venda aconteceu. | data AAAA-MM-DD em 2023 | data |
Tabela 1. Atributos da base. Em qualquer coluna, exceto Transaction ID, podem aparecer campos vazios e os marcadores ERROR e UNKNOWN.
A base não informa a moeda; vamos apresentar os valores como dólares (US$), escritos no padrão brasileiro (US$ 12.345,67). O cardápio do café (Tabela 2) vai servir como regra de negócio no tratamento.
| Na base | Tratado | US$ | Na base | Tratado | US$ |
|---|---|---|---|---|---|
| Cookie | Cookie | 1,00 | Juice | Suco | 3,00 |
| Tea | Chá | 1,50 | Sandwich | Sanduíche | 4,00 |
| Coffee | Café | 2,00 | Smoothie | Smoothie | 4,00 |
| Cake | Bolo | 3,00 | Salad | Salada | 5,00 |
Tabela 2. Cardápio do café. Bolo e Suco têm o mesmo preço, assim como Sanduíche e Smoothie: esse detalhe vai fazer diferença mais adiante.
2. A jornada de dados
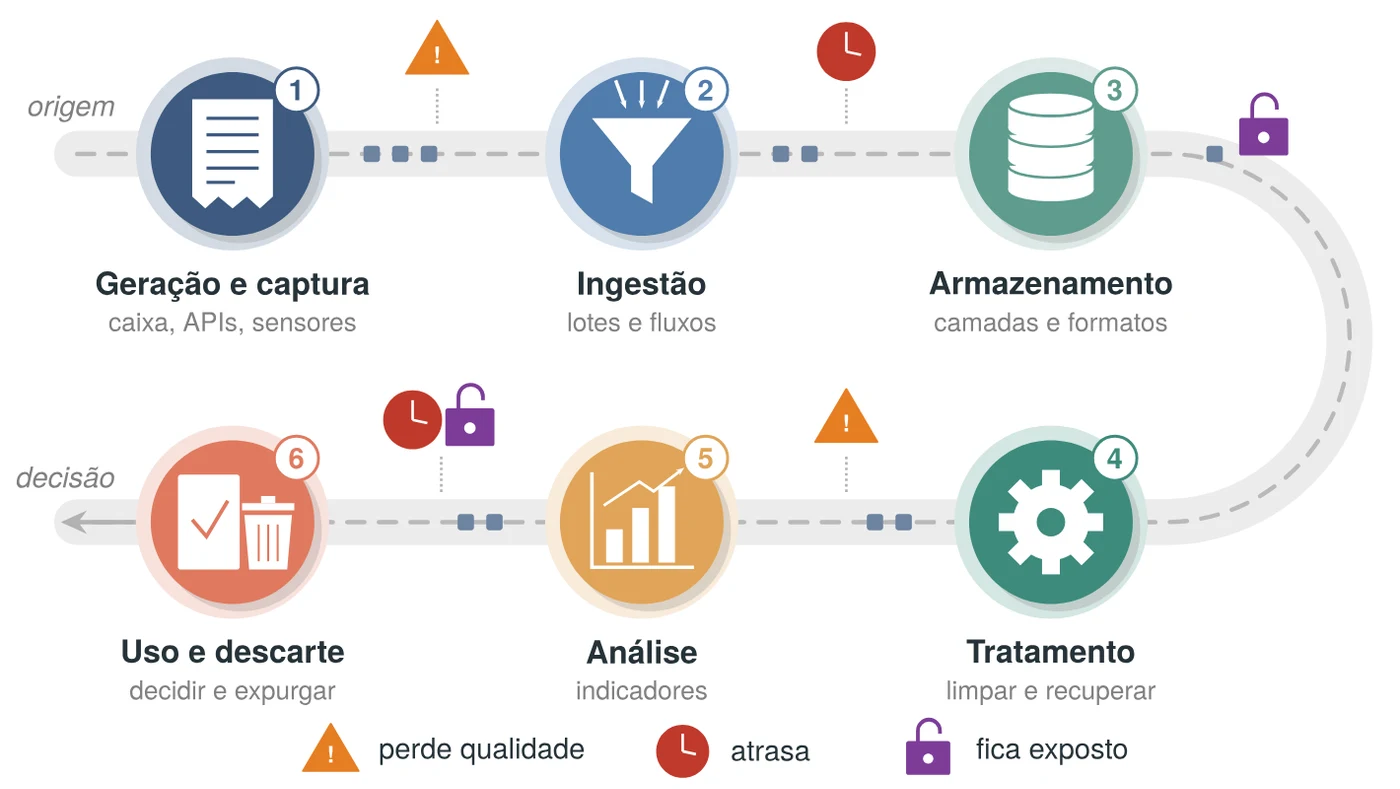
Figura 2. A jornada de dados: seis fases entre a origem e a decisão, e os três riscos que acompanham o dado ao longo do caminho.
Definição: Jornada de dados
Caminho que o dado percorre desde a origem até virar decisão: geração e captura → ingestão → armazenamento → tratamento → análise → uso e descarte. Mapear a jornada serve para enxergar onde o dado perde qualidade, atrasa ou fica exposto.
Cada fase tem um papel claro:
- Geração e captura: o dado nasce (no caixa, num aplicativo, num sensor) e é trazido para o ambiente de dados exatamente como chegou.
- Ingestão: o dado capturado é carregado de forma organizada na plataforma onde será trabalhado.
- Armazenamento: decide onde e como o dado mora: em que formato, em quais camadas e em quantas cópias.
- Tratamento: transforma o dado bruto em dado confiável, sem inventar nada.
- Análise: resume o dado tratado em indicadores que respondem a perguntas do negócio.
- Uso e descarte: o indicador chega a quem decide; e o que não é mais necessário é eliminado de forma planejada.
A qualidade de uma decisão nunca é maior do que a do pior trecho da jornada. Os três riscos da Figura 2 aparecem em todas as fases, cada uma do seu jeito (Tabela 3).
| Fase | Perde qualidade | Atrasa | Fica exposto |
|---|---|---|---|
| Captura | campos vazios e erros vindos da origem | coleta pouco frequente | arquivos em trânsito |
| Ingestão | linhas duplicadas ou perdidas | reprocessamentos | cópia bruta acessível a muitos |
| Armazenamento | tipos errados, sem regras | formatos lentos | cópias sem controle |
| Tratamento | correções que inventam dados | regras manuais | dado copiado para testes |
| Análise | somas sobre dado sujo | recálculos demorados | detalhe em relatórios |
| Uso e descarte | decisão sem grau de confiança | dado velho como se fosse atual | dado guardado além do necessário |
Tabela 3. Exemplos de risco em cada fase da jornada.
3. Preparando o ambiente
Vamos precisar de três ferramentas gratuitas: Python 3.11 ou superior (python.org; no Windows, marque a opção Add python.exe to PATH), Git (git-scm.com) e Visual Studio Code, com a extensão Python. Todos os comandos são digitados no terminal do VS Code (menu Terminal → New Terminal).
Se for a primeira vez que você usa o Git nesta máquina, informe seu nome e e-mail, que ficam gravados em cada commit:
Terminal
git config --global user.name "Seu Nome"
git config --global user.email "seu.email@exemplo.com"
git config --global init.defaultBranch main
Pasta do projeto e ambiente virtual
Crie a pasta do projeto, transforme-a num repositório Git e abra-a no VS Code. Em seguida, crie um ambiente virtual, uma instalação do Python só para este projeto, e ative-o.
Terminal (macOS e Linux)
mkdir jornada-dados
cd jornada-dados
git init
python3 -m venv .venv
source .venv/bin/activate
Terminal (Windows, PowerShell)
mkdir jornada-dados
cd jornada-dados
git init
py -m venv .venv
.venv\Scripts\Activate.ps1
Com o ambiente ativo, aparece (.venv) no início da linha do terminal, e o comando python passa a funcionar igual em qualquer sistema. Se o PowerShell bloquear o script de ativação, execute uma vez Set-ExecutionPolicy -Scope CurrentUser RemoteSigned.
Dependências e o que não vai para o Git
Crie o arquivo requirements.txt com as bibliotecas do projeto: pandas (tabelas), pyarrow (formato Parquet), duckdb (consultas SQL) e matplotlib (gráficos).
requirements.txt
pandas>=3.0
pyarrow>=21.0
duckdb>=1.4
matplotlib>=3.10
Terminal
pip install -r requirements.txt
Agora crie o arquivo .gitignore. Ele diz ao Git o que ignorar, e é o primeiro controle de exposição da jornada: dados e resultados nunca vão para o repositório, porque um repositório é feito para ser compartilhado.
.gitignore
# Ambiente virtual e cache do Python
.venv/
__pycache__/

# Dados e saídas NUNCA vão para o repositório
dados/
saidas/
Configurações centrais
Todos os caminhos do projeto ficam num único arquivo, config.py. Cada pasta de dados/ corresponde a uma etapa da jornada. O arquivo também guarda as políticas que vamos usar no fim (prazo de frescor e de retenção) e duas funções que escrevem números no padrão brasileiro.
config.py
"""Configurações centrais da jornada de dados do café."""
from pathlib import Path

# Path(__file__).parent é a pasta onde este arquivo está
RAIZ = Path(__file__).parent
DADOS = RAIZ / "dados"          # o operador / junta partes de um caminho
ENTRADA = DADOS / "entrada"     # onde você salva o CSV baixado do Kaggle
RAW = DADOS / "raw"             # zona de pouso: o arquivo como chegou
BRONZE = DADOS / "bronze"       # dado bruto, em formato Parquet
SILVER = DADOS / "silver"       # dado tratado
GOLD = DADOS / "gold"           # indicadores prontos para decisão
SAIDAS = RAIZ / "saidas"        # gráficos, painel e exportações

ARQUIVO = "dirty_cafe_sales.csv"  # nome do arquivo baixado do Kaggle

# Políticas da jornada (usadas nas fases de uso e descarte)
SLA_FRESCOR_DIAS = 1   # idade máxima aceitável do dado mais recente
RETENCAO_MESES = 6     # meses de vendas detalhadas que mantemos


def preparar_pastas():
    """Cria as pastas de trabalho, se ainda não existirem."""
    for pasta in [ENTRADA, RAW, BRONZE, SILVER, GOLD, SAIDAS]:
        # parents=True cria pastas intermediárias; exist_ok evita erro
        pasta.mkdir(parents=True, exist_ok=True)


def br(numero, casas=0):
    """Formata um número no padrão brasileiro: 12.345,67."""
    # O Python escreve 12,345.67 (padrão americano); trocamos os sinais
    texto = f"{numero:,.{casas}f}"
    return texto.replace(",", "_").replace(".", ",").replace("_", ".")


def moeda(valor):
    """Formata um valor em dólares: US$ 12.345,67."""
    return "US$ " + br(valor, 2)


if __name__ == "__main__":
    preparar_pastas()
    print("Pastas criadas em", DADOS)
O bloco if __name__ == "__main__": só roda quando o arquivo é executado diretamente. Execute:
Terminal
python config.py
Saída no terminal
Pastas criadas em /home/aluno/jornada-dados/dados
O caminho será o da sua máquina. Agora coloque o arquivo dirty_cafe_sales.csv, baixado do Kaggle, dentro da pasta dados/entrada/. Confira que o Git ignora a pasta dados/:
Terminal
git status --short
Saída no terminal
?? .gitignore
?? config.py
?? requirements.txt
Commits com Conventional Commits
Um commit é uma fotografia do projeto num dado momento. O comando git add . escolhe o que entra na fotografia e git commit a registra no histórico, com uma mensagem. Vamos escrever as mensagens no padrão Conventional Commits (Figura 3).
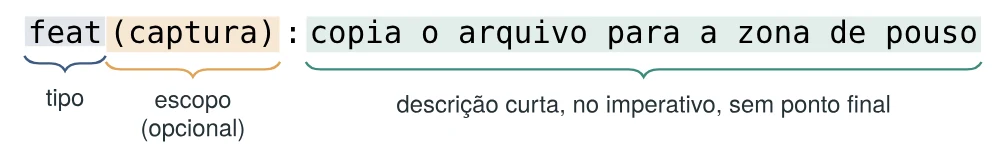
Figura 3. Anatomia de uma mensagem no padrão Conventional Commits.
Os tipos mais usados são feat (funcionalidade nova), fix (correção de defeito), docs (documentação), refactor (reorganização sem mudar o comportamento) e chore (manutenção: estrutura, configuração, dependências). O primeiro commit só cria a estrutura, então o tipo é chore:
Commit no Git
git add .
git commit -m "chore: cria estrutura inicial do projeto"
4. Fase 1 — Geração e captura
No café, o dado nasce no caixa. Em outras empresas, nasce em aplicativos, sensores, formulários ou sistemas de parceiros. A captura é o momento em que o dado entra no ambiente de dados, e a regra de ouro é guardar exatamente o que chegou. Nada é corrigido aqui: se o caixa mandou ERROR, é ERROR que fica guardado. Isso preserva a prova do problema e permite refazer todo o tratamento se uma regra mudar.
Nosso captura.py copia o arquivo de dados/entrada/ para a zona de pouso (dados/raw/), com a data da captura no nome, e o marca como somente leitura para que ninguém o altere por engano.
captura.py
"""Fase 1 - Captura: copia o arquivo baixado para a zona de pouso."""
import shutil
from datetime import date

import pandas as pd

import config


def capturar():
    config.preparar_pastas()
    origem = config.ENTRADA / config.ARQUIVO
    if not origem.exists():
        # SystemExit encerra o programa mostrando a mensagem
        raise SystemExit(f"Baixe o arquivo do Kaggle e salve em: {origem}")

    # O nome do arquivo guarda a data da captura: vendas_2026-09-21.csv
    destino = config.RAW / f"vendas_{date.today()}.csv"
    if destino.exists():
        print("O arquivo de hoje já foi capturado:", destino.name)
    else:
        shutil.copy(origem, destino)   # cópia fiel, byte a byte
        destino.chmod(0o444)           # 0o444 = somente leitura
        print("Arquivo capturado:", destino.name)

    linhas = len(pd.read_csv(destino))
    tamanho = destino.stat().st_size / 1024   # bytes -> KiB
    print(f"  {config.br(linhas)} linhas, {config.br(tamanho, 1)} KiB")
    return {"resumo": [f"{config.br(linhas)} linhas", "somente leitura"]}


if __name__ == "__main__":
    capturar()
Execute duas vezes seguidas:
Terminal
python captura.py
python captura.py
Saída das duas execuções
Arquivo capturado: vendas_2026-09-21.csv
  10.000 linhas, 527,6 KiB
O arquivo de hoje já foi capturado: vendas_2026-09-21.csv
  10.000 linhas, 527,6 KiB
Na segunda execução, o programa percebeu que o arquivo do dia já existia e não fez uma segunda cópia. Tente abrir o CSV da pasta raw/ e salvar uma alteração: o sistema operacional vai recusar.
Commit no Git
git add .
git commit -m "feat(captura): copia o arquivo para a zona de pouso"
5. Fase 2 — Ingestão
A ingestão carrega o dado capturado na plataforma onde ele será trabalhado. Ela pode ser em lote (de tempos em tempos, como o fechamento diário do caixa) ou em fluxo (streaming, cada venda assim que acontece). Quanto mais espaçada a ingestão, maior o atraso até o dado estar disponível.
A regra continua sendo copiar, não corrigir. Por isso vamos ler tudo como texto: se deixarmos o pandas "adivinhar" os tipos, ele transforma campos vazios e números por conta própria, e a informação original se perde. Cada linha também ganha dois metadados de linhagem, começando com sublinhado: o arquivo de origem e o momento da ingestão. Com eles, qualquer número de um relatório pode ser rastreado até o arquivo que o originou.
ingestao.py
"""Fase 2 - Ingestão: leva o arquivo bruto para a camada bronze."""
from datetime import datetime

import pandas as pd

import config


def arquivo_mais_recente():
    """O último arquivo capturado (os nomes seguem a ordem das datas)."""
    arquivos = sorted(config.RAW.glob("vendas_*.csv"))
    return arquivos[-1]


def ingerir():
    arquivo = arquivo_mais_recente()
    # dtype=str: tudo é lido como texto, sem "adivinhar" tipos.
    # keep_default_na=False: um campo vazio continua vazio ("").
    bronze = pd.read_csv(arquivo, dtype=str, keep_default_na=False)

    # Linhagem: de qual arquivo veio cada linha e quando ela entrou
    bronze["_arquivo"] = arquivo.name
    bronze["_ingerido_em"] = datetime.now().strftime("%Y-%m-%d %H:%M")

    # Gravar por cima do arquivo anterior torna a carga idempotente
    bronze.to_parquet(config.BRONZE / "vendas.parquet", index=False)
    print(f"Camada bronze: {config.br(len(bronze))} linhas gravadas")
    return {"resumo": [f"{config.br(len(bronze))} linhas", "sem correções"]}


if __name__ == "__main__":
    ingerir()
    # Espiando a primeira linha gravada na bronze, campo a campo
    print(pd.read_parquet(config.BRONZE / "vendas.parquet").iloc[0])
Terminal
python ingestao.py
Saída no terminal
Camada bronze: 10.000 linhas gravadas
Transaction ID             TXN_1961373
Item                            Coffee
Quantity                             2
Price Per Unit                     2.0
Total Spent                        4.0
Payment Method             Credit Card
Location                      Takeaway
Transaction Date            2023-09-08
_arquivo            vendas_2026-09-21.csv
_ingerido_em          2026-09-21 22:17
Name: 0, dtype: str
Definição: Idempotência
Uma operação é idempotente quando executá-la uma ou várias vezes dá o mesmo resultado. Como a bronze é gravada por cima a cada execução, rodar a ingestão duas vezes não duplica as vendas. Se, em vez disso, acrescentássemos as linhas ao final do arquivo, cada nova execução dobraria o faturamento, sem nenhum erro aparente.
Commit no Git
git add .
git commit -m "feat(ingestao): carrega o arquivo bruto na camada bronze"
6. Fase 3 — Armazenamento
Armazenar é decidir onde o dado mora, em que formato e em quantas cópias. Uma organização muito usada é a arquitetura medalhão, que separa o dado em camadas por grau de refinamento (Figura 4). No nosso projeto, cada camada é uma pasta dentro de dados/.
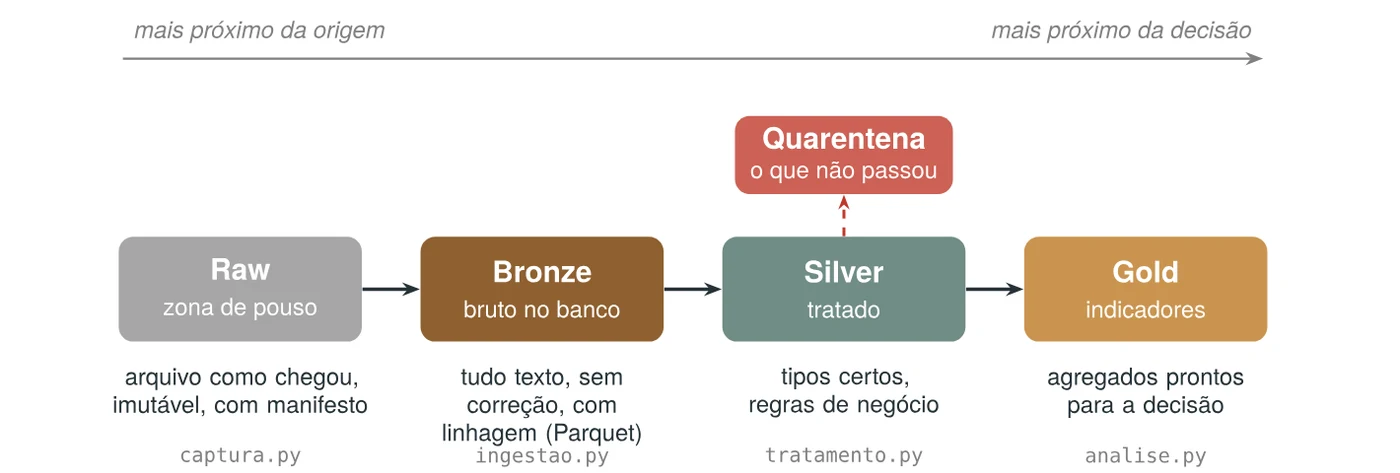
Figura 4. Arquitetura medalhão: cada camada guarda o dado num grau de refinamento, e cada arquivo do projeto alimenta uma delas.
Como a bronze nunca é corrigida, o tratamento pode ser refeito do zero a qualquer momento. E como a gold só tem totais, ela pode ser compartilhada com muito menos risco do que o detalhe de cada venda.
Quanto ao formato, o CSV guarda uma venda inteira depois da outra; o Parquet guarda os valores de cada coluna juntos (Figura 5). Para somar uma coluna, basta ler o bloco dela; e valores parecidos lado a lado comprimem muito melhor. O Parquet também guarda o tipo de cada coluna, coisa que o CSV não faz.
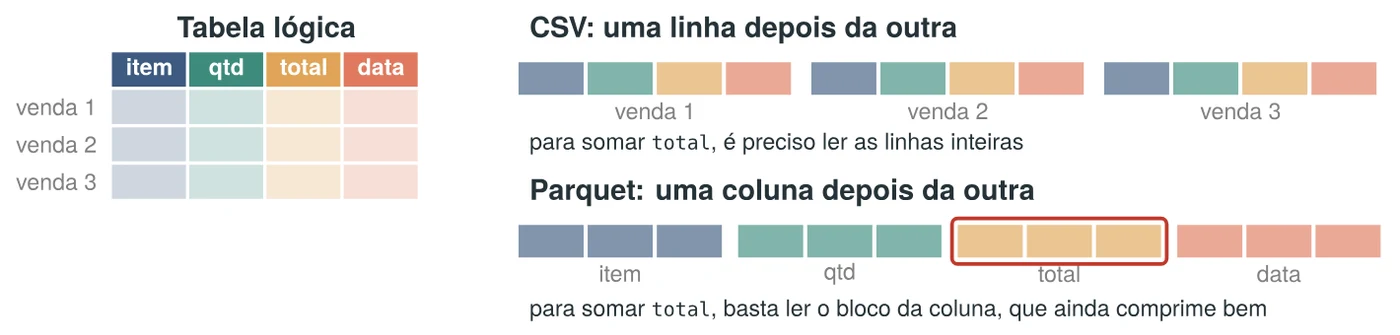
Figura 5. O mesmo conteúdo gravado por linhas (CSV) e por colunas (Parquet).
O armazenamento.py compara os dois formatos e faz um inventário de cópias: toda cópia de um dado é mais um lugar de onde ele pode vazar, e quem administra dados precisa saber onde estão todas.
armazenamento.py
"""Fase 3 - Armazenamento: formatos, camadas e inventário de cópias."""
import pandas as pd

import config


def comparar_formatos():
    """Compara o tamanho do mesmo conteúdo em CSV e em Parquet."""
    csv = sorted(config.RAW.glob("vendas_*.csv"))[-1]
    parquet = config.BRONZE / "vendas.parquet"
    kib_csv = csv.stat().st_size / 1024
    kib_parquet = parquet.stat().st_size / 1024
    print(f"CSV (raw)        : {config.br(kib_csv, 1):>6} KiB")
    print(f"Parquet (bronze) : {config.br(kib_parquet, 1):>6} KiB "
          f"({config.br(100 * kib_parquet / kib_csv)}% do CSV)")


def inventario():
    """Lista todas as cópias dos dados guardadas dentro de dados/."""
    copias = []
    # */* = qualquer arquivo dentro de qualquer subpasta de dados/
    for arquivo in sorted(config.DADOS.glob("*/*")):
        if arquivo.suffix == ".csv":
            linhas = len(pd.read_csv(arquivo))
        elif arquivo.suffix == ".parquet":
            linhas = len(pd.read_parquet(arquivo))
        else:
            continue   # ignora o que não for CSV nem Parquet
        copias.append({"pasta": arquivo.parent.name, "arquivo": arquivo.name,
                       "linhas": linhas})
    return pd.DataFrame(copias)


def mostrar_inventario(copias):
    for _, copia in copias.iterrows():   # percorre linha a linha
        print(f"  {copia['pasta']:<8} {copia['arquivo']:<30} "
              f"{config.br(copia['linhas']):>7} linhas")


def armazenar():
    comparar_formatos()
    copias = inventario()
    print("Inventário de cópias:")
    mostrar_inventario(copias)
    # Na gold só há totais; nas demais pastas há vendas individuais
    detalhe = copias[copias["pasta"] != "gold"]
    alerta = "fica exposto" if len(detalhe) > 1 else None
    return {"resumo": [f"{len(detalhe)} cópias do detalhe", "CSV e Parquet"],
            "alerta": alerta}


if __name__ == "__main__":
    armazenar()
Terminal
python armazenamento.py
Saída no terminal
CSV (raw)        :  527,6 KiB
Parquet (bronze) :  132,8 KiB (25% do CSV)
Inventário de cópias:
  bronze   vendas.parquet                  10.000 linhas
  entrada  dirty_cafe_sales.csv            10.000 linhas
  raw      vendas_2026-09-21.csv           10.000 linhas
O Parquet ocupa só um quarto do CSV, mesmo guardando as colunas de linhagem a mais. E o inventário mostra que cada venda já existe em três cópias. Repare que uma delas é o próprio arquivo baixado, esquecido em entrada/: depois da captura ele não é mais necessário e poderia ser apagado. A etapa devolve o alerta "fica exposto" sempre que houver mais de uma cópia do detalhe; ele vai aparecer no mapa final da jornada.
Commit no Git
git add .
git commit -m "feat(armazenamento): compara formatos e inventaria cópias"
7. Fase 4 — Tratamento: diagnóstico
O tratamento transforma o dado bruto em dado confiável. É a fase com mais trabalho e também a mais fácil de errar com boa intenção: preencher uma lacuna com um valor inventado deixa a tabela bonita e a decisão errada. Por isso, o tratamento começa medindo.
Qualidade de dados tem várias dimensões (Tabela 4). Vamos medir a completude: o percentual de valores que existem e não são marcadores de erro. E também o percentual de linhas perfeitas, em que todas as colunas estão corretas.
| Dimensão | Pergunta | Exemplo no café |
|---|---|---|
| Completude | o valor existe? | item vazio |
| Validade | respeita o formato e os valores permitidos? | ERROR na quantidade |
| Consistência | os campos concordam entre si? | total ≠ quantidade × preço |
| Unicidade | cada fato aparece uma só vez? | a mesma venda duas vezes |
| Atualidade | o dado é recente o bastante? | vendas de três anos atrás |
Tabela 4. Dimensões da qualidade de dados.
Crie o arquivo tratamento.py. A primeira versão só lê a bronze e mede a qualidade de cada coluna.
tratamento.py
"""Fase 4 - Tratamento: transforma a camada bronze na camada silver."""
import pandas as pd

import config

# Nome da coluna na origem -> nome no nosso modelo
NOMES = {"Transaction ID": "id_transacao", "Item": "item",
         "Quantity": "quantidade", "Price Per Unit": "preco_unitario",
         "Total Spent": "total", "Payment Method": "forma_pagamento",
         "Location": "local", "Transaction Date": "data"}
CAMPOS = list(NOMES.values())

# Formas de dizer "não sei": as da origem e as que nós mesmos usamos
PROBLEMAS = ["", "ERROR", "UNKNOWN"]
AUSENTES = PROBLEMAS + ["Não informado", "Não identificado"]


def diagnosticar(df):
    """% de valores utilizáveis por coluna e % de linhas perfeitas."""
    # True onde o valor está faltando ou é um marcador de problema
    ruim = df[CAMPOS].isna() | df[CAMPOS].isin(AUSENTES)
    completude = (1 - ruim.mean()) * 100          # mean() de True/False = %
    perfeitas = (~ruim.any(axis=1)).mean() * 100  # ~ inverte True/False
    return completude, perfeitas


def mostrar_diagnostico(completude, perfeitas):
    for coluna, valor in completude.items():
        print(f"  {coluna:<16} {config.br(valor, 1):>6}%")
    print(f"  Linhas perfeitas: {config.br(perfeitas, 1)}%")


def tratar():
    bronze = pd.read_parquet(config.BRONZE / "vendas.parquet")
    antes, perfeitas_antes = diagnosticar(bronze.rename(columns=NOMES))
    print("Diagnóstico da camada bronze (valores utilizáveis):")
    mostrar_diagnostico(antes, perfeitas_antes)


if __name__ == "__main__":
    tratar()
A função diagnosticar monta uma tabela de True e False: True onde o valor é ruim. A média de uma coluna de True/False é justamente o percentual de True, porque o Python conta True como 1.
Terminal
python tratamento.py
Saída no terminal
Diagnóstico da camada bronze (valores utilizáveis):
  id_transacao      100,0%
  item               90,3%
  quantidade         95,2%
  preco_unitario     94,7%
  total              95,0%
  forma_pagamento    68,2%
  local              60,4%
  data               95,4%
  Linhas perfeitas: 30,9%
Esse é o retrato de onde o dado perdeu qualidade antes de chegar até nós: forma de pagamento e local têm um terço ou mais de problemas, e só 30,9% das vendas chegaram perfeitas.
Commit no Git
git add .
git commit -m "feat(tratamento): diagnostica a qualidade da camada bronze"
8. Fase 4 — Tratamento: padronização e recuperação
Padronizar é transformar as várias formas de dizer "não sei" (vazio, ERROR, UNKNOWN) num único nulo, converter os textos nos tipos certos e traduzir as categorias para um vocabulário controlado: valores fora da lista viram nulo.
Depois, muitas lacunas podem ser preenchidas sem inventar nada, porque o negócio tem regras que amarram as colunas (Figura 6): o total é sempre quantidade vezes preço, o preço de cada item está no cardápio e alguns preços pertencem a um único item.
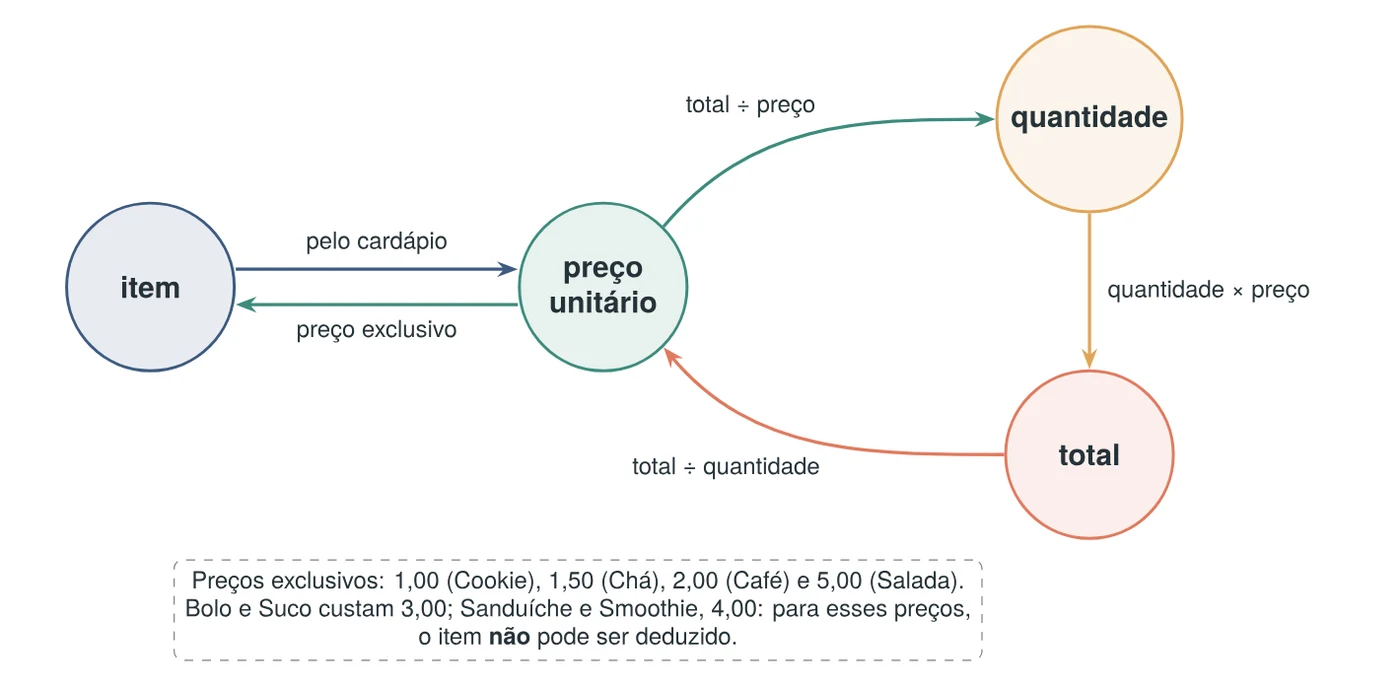
Figura 6. Regras de negócio que ligam as colunas da venda. Cada seta é uma forma de recuperar um valor a partir de outros.
Acrescente ao tratamento.py o vocabulário controlado e as regras de negócio, logo depois de AUSENTES, e as funções padronizar e recuperar, entre mostrar_diagnostico e tratar. Cada regra é uma única linha com fillna, que só preenche onde está vazio. Como as regras dependem umas das outras (uma venda pode recuperar primeiro o preço e, com ele, o item), elas são aplicadas três vezes seguidas.
tratamento.py (trechos novos)
# Vocabulário controlado: só estes valores são aceitos (já traduzidos)
ITENS = {"Coffee": "Café", "Tea": "Chá", "Sandwich": "Sanduíche",
         "Salad": "Salada", "Cake": "Bolo", "Cookie": "Cookie",
         "Smoothie": "Smoothie", "Juice": "Suco"}
PAGAMENTOS = {"Cash": "Dinheiro", "Credit Card": "Cartão de crédito",
              "Digital Wallet": "Carteira digital"}
LOCAIS = {"In-store": "No local", "Takeaway": "Para viagem"}

# Regras de negócio: o cardápio e os preços que só um item tem
CARDAPIO = {"Café": 2.0, "Chá": 1.5, "Sanduíche": 4.0, "Salada": 5.0,
            "Bolo": 3.0, "Cookie": 1.0, "Smoothie": 4.0, "Suco": 3.0}
PRECO_EXCLUSIVO = {1.0: "Cookie", 1.5: "Chá", 2.0: "Café", 5.0: "Salada"}


def padronizar(bronze):
    """Nulos no lugar dos marcadores, tipos certos e nomes traduzidos."""
    df = bronze.rename(columns=NOMES)
    df[CAMPOS] = df[CAMPOS].replace(PROBLEMAS, pd.NA)   # pd.NA = nulo
    for coluna in ["quantidade", "preco_unitario", "total"]:
        # errors="coerce": o que não for número vira nulo, sem erro
        df[coluna] = pd.to_numeric(df[coluna], errors="coerce")
    df["data"] = pd.to_datetime(df["data"], format="%Y-%m-%d",
                                errors="coerce")
    # map(dicionário) traduz; o que não está no dicionário vira nulo
    df["item"] = df["item"].map(ITENS)
    df["forma_pagamento"] = df["forma_pagamento"].map(PAGAMENTOS)
    df["local"] = df["local"].map(LOCAIS)
    return df


def recuperar(df):
    """Preenche lacunas usando só as regras de negócio."""
    lacunas = df[CAMPOS].isna()   # foto das lacunas antes da recuperação
    # As regras dependem umas das outras, por isso rodam três vezes.
    # fillna(x) só preenche onde está nulo, usando o valor de x na linha
    for rodada in range(3):
        df["preco_unitario"] = df["preco_unitario"].fillna(
            df["item"].map(CARDAPIO))                     # pelo cardápio
        df["preco_unitario"] = df["preco_unitario"].fillna(
            df["total"] / df["quantidade"])               # total ÷ qtd
        df["quantidade"] = df["quantidade"].fillna(
            df["total"] / df["preco_unitario"])           # total ÷ preço
        df["total"] = df["total"].fillna(
            df["quantidade"] * df["preco_unitario"])      # qtd × preço
        df["item"] = df["item"].fillna(
            df["preco_unitario"].map(PRECO_EXCLUSIVO))    # preço único
    # Linhagem por linha: True se algum campo da venda foi reconstruído
    df["_recuperado"] = (lacunas & df[CAMPOS].notna()).any(axis=1)
    return lacunas.sum() - df[CAMPOS].isna().sum()   # recuperados/coluna
E complete a função tratar, que passa a padronizar e recuperar depois do diagnóstico:
tratamento.py (função tratar)
def tratar():
    bronze = pd.read_parquet(config.BRONZE / "vendas.parquet")
    antes, perfeitas_antes = diagnosticar(bronze.rename(columns=NOMES))
    print("Diagnóstico da camada bronze (valores utilizáveis):")
    mostrar_diagnostico(antes, perfeitas_antes)

    df = padronizar(bronze)
    lacunas = df[CAMPOS].isna().sum().sum()   # nulos no total
    print(f"Lacunas após padronizar: {config.br(lacunas)}")
    recuperados = recuperar(df)
    print("Valores recuperados pelas regras de negócio:")
    for coluna, n in recuperados[recuperados > 0].items():
        print(f"  {coluna:<16} {config.br(n):>6}")
Terminal
python tratamento.py
Saída no terminal (trecho final)
[...]
Lacunas após padronizar: 10.082
Valores recuperados pelas regras de negócio:
  item                489
  quantidade          456
  preco_unitario      527
  total               479
A partir daqui, as saídas mostram só a parte nova, depois de [...]. Foram recuperados 1.951 valores usando apenas as regras do negócio.
Commit no Git
git add .
git commit -m "feat(tratamento): padroniza e recupera valores com regras"
9. Fase 4 — Tratamento: quarentena e camada silver
Vendas sem total não entram no faturamento, e vendas sem data não podem ser atribuídas a nenhum mês. Em vez de apagá-las em silêncio, vamos separá-las numa quarentena, com o motivo anotado, para investigação junto a quem cuida do caixa. As lacunas que sobram nas categorias recebem uma ausência explícita (Não identificado, Não informado), que fica visível nos gráficos.
Antes de gravar a silver, três comandos assert verificam um contrato mínimo: regras que todo dado tratado precisa cumprir. Se alguma falhar, o programa para com uma mensagem, e o erro aparece no pipeline, não no relatório do gestor.
Acrescente o matplotlib ao início do arquivo:
tratamento.py (início)
"""Fase 4 - Tratamento: transforma a camada bronze na camada silver."""
import matplotlib
matplotlib.use("Agg")   # desenha direto em arquivo, sem abrir janela
import matplotlib.pyplot as plt
import pandas as pd
E acrescente três funções depois de recuperar:
tratamento.py (funções novas)
def separar_quarentena(df):
    """Vendas sem total ou sem data não podem seguir na jornada."""
    retida = df["total"].isna() | df["data"].isna()
    quarentena = df[retida].copy()   # copy(): uma tabela independente
    quarentena["motivo"] = "sem data"
    quarentena.loc[quarentena["total"].isna(), "motivo"] = "sem valor total"
    return df[~retida].copy(), quarentena


def completar(silver):
    """Ausência explícita é melhor que ausência silenciosa."""
    silver["item"] = silver["item"].fillna("Não identificado")
    silver["forma_pagamento"] = silver["forma_pagamento"].fillna(
        "Não informado")
    silver["local"] = silver["local"].fillna("Não informado")
    # "Int64" (com I maiúsculo) é o número inteiro do pandas
    silver["quantidade"] = silver["quantidade"].round().astype("Int64")
    return silver


def grafico(antes, depois):
    """Barras lado a lado: completude de cada coluna antes e depois."""
    fig, ax = plt.subplots(figsize=(9, 4))
    posicoes = range(len(CAMPOS))
    ax.bar([p - 0.2 for p in posicoes], antes, width=0.4,
           color="#E07A5F", label="bronze (antes)")
    ax.bar([p + 0.2 for p in posicoes], depois, width=0.4,
           color="#3D8B7D", label="silver (depois)")
    ax.set_xticks(list(posicoes), CAMPOS, rotation=20)
    ax.set_ylabel("valores utilizáveis (%)")
    ax.set_title("Completude por coluna, antes e depois do tratamento")
    ax.legend(loc="lower left")
    fig.tight_layout()   # ajusta margens para nada ficar cortado
    fig.savefig(config.SAIDAS / "qualidade_por_coluna.png", dpi=150)
    plt.close(fig)
Por fim, complete a função tratar com a quarentena, o contrato e a gravação da silver:
tratamento.py (final da função tratar)
    silver, quarentena = separar_quarentena(df)
    silver = completar(silver)
    # Contrato mínimo da silver: se alguma regra falhar, o programa para
    assert silver["id_transacao"].is_unique, "transação repetida"
    assert silver["total"].notna().all(), "venda sem total"
    assert silver["data"].notna().all(), "venda sem data"
    silver.to_parquet(config.SILVER / "vendas.parquet", index=False)
    quarentena.to_parquet(config.SILVER / "quarentena.parquet", index=False)

    depois, perfeitas_depois = diagnosticar(silver)
    grafico(antes, depois)
    print(f"Quarentena: {config.br(len(quarentena))} linhas")
    print(quarentena["motivo"].value_counts().to_string())
    print(f"Silver: {config.br(len(silver))} linhas | perfeitas: "
          f"{config.br(perfeitas_antes, 1)}% -> "
          f"{config.br(perfeitas_depois, 1)}%")
    return {"resumo": [f"{config.br(len(silver))} na silver",
                       f"{config.br(len(quarentena))} em quarentena"],
            "alerta": "perde qualidade" if len(quarentena) else None}
Terminal
python tratamento.py
Saída no terminal (trecho final)
[...]
Quarentena: 483 linhas
motivo
sem data           460
sem valor total     23
Silver: 9.517 linhas | perfeitas: 30,9% -> 39,6%
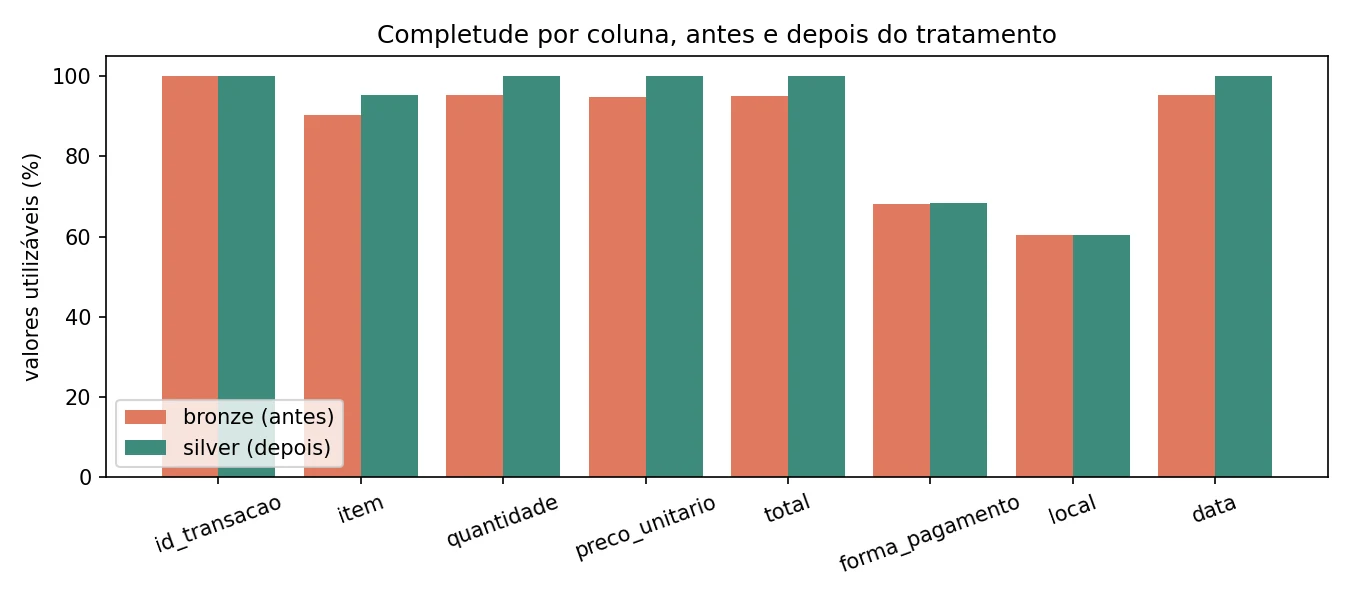
Figura 7. Completude por coluna antes e depois do tratamento (saidas/qualidade_por_coluna.png).
As colunas ligadas por regras de negócio chegaram a 100%, mas forma de pagamento e local praticamente não mudaram, e as linhas perfeitas só subiram de 30,9% para 39,6%. Esse número honesto diz que o problema está na origem: a solução é corrigir o caixa, não inventar dados no pipeline.
Commit no Git
git add .
git commit -m "feat(tratamento): grava a camada silver e a quarentena"
10. Fase 5 — Análise
A análise transforma milhares de linhas em poucas respostas. Os indicadores ficam na camada gold, em tabelas pequenas, prontas para quem decide. Para calculá-los vamos usar SQL: o DuckDB consegue consultar o arquivo Parquet da silver diretamente, sem precisar carregar nada num banco antes. Crie o arquivo analise.py:
analise.py
"""Fase 5 - Análise: transforma a camada silver em indicadores (gold)."""
import duckdb
import pandas as pd

import config
from tratamento import ITENS

# Caminho do Parquet da silver, com "/" (o DuckDB aceita em qualquer SO)
SILVER = (config.SILVER / "vendas.parquet").as_posix()


def indicadores():
    """Consultas SQL direto sobre o arquivo Parquet da silver."""
    mensal = duckdb.sql(f"""
        SELECT strftime(data, '%Y-%m') AS mes,
               count(*) AS vendas,
               sum(total) AS faturamento,
               count_if(_recuperado) AS recuperadas,
               max(data) AS ultima_venda
        FROM '{SILVER}'
        GROUP BY mes ORDER BY mes""").df()   # .df() devolve um DataFrame
    categorias = duckdb.sql(f"""
        SELECT forma_pagamento, local, count(*) AS vendas
        FROM '{SILVER}' GROUP BY forma_pagamento, local""").df()
    mensal.to_parquet(config.GOLD / "vendas_mensais.parquet", index=False)
    categorias.to_parquet(config.GOLD / "categorias.parquet", index=False)
    return mensal


def mesma_pergunta():
    """Qual item vende mais unidades? No dado bruto e no tratado."""
    bronze = pd.read_parquet(config.BRONZE / "vendas.parquet")
    bronze["unidades"] = pd.to_numeric(bronze["Quantity"], errors="coerce")
    bronze["item"] = bronze["Item"].map(ITENS)   # ERROR e vazio viram nulo
    bruto = bronze.groupby("item")["unidades"]   # grupos nulos são ignorados
    silver = pd.read_parquet(config.SILVER / "vendas.parquet")
    tratado = silver[silver["item"] != "Não identificado"]
    tratado = tratado.groupby("item")["quantidade"]
    print("Qual item vende mais unidades? (três primeiros)")
    # nlargest(3): os três maiores valores
    for nome, grupo in [("bruto", bruto), ("tratado", tratado)]:
        top = grupo.sum().nlargest(3)
        texto = ", ".join(f"{i} ({config.br(v)})" for i, v in top.items())
        print(f"  no dado {nome:<8}: {texto}")


def analisar():
    mensal = indicadores()
    print(mensal[["mes", "vendas", "faturamento"]].to_string(index=False))
    mesma_pergunta()


if __name__ == "__main__":
    analisar()
A função mesma_pergunta faz uma pergunta de negócio a duas camadas diferentes: qual item vende mais unidades? Na bronze, a resposta ingênua soma o que dá para somar e ignora o resto. Na silver, somamos o dado tratado.
Terminal
python analise.py
Saída no terminal
    mes  vendas  faturamento
2023-01     815       7254.0
2023-02     726       6644.0
2023-03     826       7216.0
2023-04     771       7179.0
2023-05     773       6957.5
2023-06     817       7353.0
2023-07     789       6877.5
2023-08     802       7112.5
2023-09     786       6871.0
2023-10     837       7314.0
2023-11     784       6967.0
2023-12     791       7177.0
Qual item vende mais unidades? (três primeiros)
  no dado bruto   : Suco (3.373), Café (3.368), Bolo (3.329)
  no dado tratado : Café (3.766), Salada (3.644), Chá (3.441)
Commit no Git
git add .
git commit -m "feat(analise): calcula indicadores mensais na camada gold"
11. Fase 5 — Ranking com faixa de incerteza
Mas o dado tratado também tem limites. Uma venda Não identificado de 3,00 por unidade foi Bolo ou Suco; só não sabemos qual. Em vez de ignorar essa dúvida, vamos medi-la. Para cada item, o mínimo garantido conta só as vendas identificadas, e o máximo possível soma também as não identificadas com o mesmo preço. Um item só é líder garantido se o seu mínimo supera o máximo de todos os outros.
Acrescente o matplotlib ao início do analise.py e troque o import de tratamento para trazer também o CARDAPIO:
analise.py (início)
"""Fase 5 - Análise: transforma a camada silver em indicadores (gold)."""
import duckdb
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

import config
from tratamento import CARDAPIO, ITENS
Acrescente três funções depois de mesma_pergunta:
analise.py (funções novas)
def ranking_com_incerteza():
    """Mínimo garantido e máximo possível de cada item."""
    silver = pd.read_parquet(config.SILVER / "vendas.parquet")
    duvida = silver[silver["item"] == "Não identificado"]
    linhas = []
    for item, preco in CARDAPIO.items():
        certo = silver[silver["item"] == item]
        # Vendas sem item, mas com o mesmo preço, PODEM ser deste item
        talvez = duvida[duvida["preco_unitario"] == preco]
        linhas.append({
            "item": item,
            "unidades_min": certo["quantidade"].sum(),
            "unidades_max": certo["quantidade"].sum()
                            + talvez["quantidade"].sum(),
            "faturamento_min": certo["total"].sum(),
            "faturamento_max": certo["total"].sum() + talvez["total"].sum(),
        })
    ranking = pd.DataFrame(linhas)
    ranking.to_parquet(config.GOLD / "ranking_itens.parquet", index=False)
    return ranking


def lider(ranking, medida):
    """O líder é garantido se o mínimo dele supera o máximo dos outros."""
    ordenado = ranking.sort_values(f"{medida}_min", ascending=False)
    primeiro = ordenado.iloc[0]
    outros = ordenado.iloc[1:]
    ameacas = outros[outros[f"{medida}_max"] > primeiro[f"{medida}_min"]]
    return primeiro["item"], list(ameacas["item"])


def grafico_ranking(ranking):
    """Cada item é um segmento: do mínimo garantido ao máximo possível."""
    fig, eixos = plt.subplots(1, 2, figsize=(10, 4.2))   # 1 linha, 2 eixos
    for ax, medida, cor in zip(eixos, ["unidades", "faturamento"],
                               ["#3D5A80", "#3D8B7D"]):
        dados = ranking.sort_values(f"{medida}_min")
        minimo, maximo = dados[f"{medida}_min"], dados[f"{medida}_max"]
        # hlines: um traço horizontal por item, do mínimo ao máximo
        ax.hlines(dados["item"], minimo, maximo, color=cor, linewidth=5,
                  alpha=0.35)
        ax.scatter(maximo, dados["item"], color="white", edgecolor=cor,
                   label="máximo possível")
        ax.scatter(minimo, dados["item"], color=cor, label="garantido")
        ax.axvline(minimo.max(), color="#C0392B", linestyle="--",
                   linewidth=1)   # linha vertical: o garantido do líder
        ax.set_title(medida.capitalize())
        ax.grid(axis="x", alpha=0.3)
    eixos[1].legend(loc="lower right")
    fig.suptitle("Ranking de itens com faixa de incerteza")
    fig.tight_layout()
    fig.savefig(config.SAIDAS / "ranking_incerteza.png", dpi=150)
    plt.close(fig)
E complete a função analisar:
analise.py (função analisar)
def analisar():
    mensal = indicadores()
    print(mensal[["mes", "vendas", "faturamento"]].to_string(index=False))
    mesma_pergunta()
    ranking = ranking_com_incerteza()
    grafico_ranking(ranking)
    for medida in ["unidades", "faturamento"]:
        item, ameacas = lider(ranking, medida)
        situacao = "garantido" if not ameacas else \
            "NÃO garantido; podem passar: " + ", ".join(ameacas)
        print(f"Líder em {medida}: {item} ({situacao})")
    return {"resumo": [f"{len(mensal)} meses na gold",
                       "ranking com incerteza"]}
Terminal
python analise.py
Saída no terminal (trecho final)
[...]
Líder em unidades: Café (NÃO garantido; podem passar: Suco, Bolo, Sanduíche, Smoothie)
Líder em faturamento: Salada (garantido)
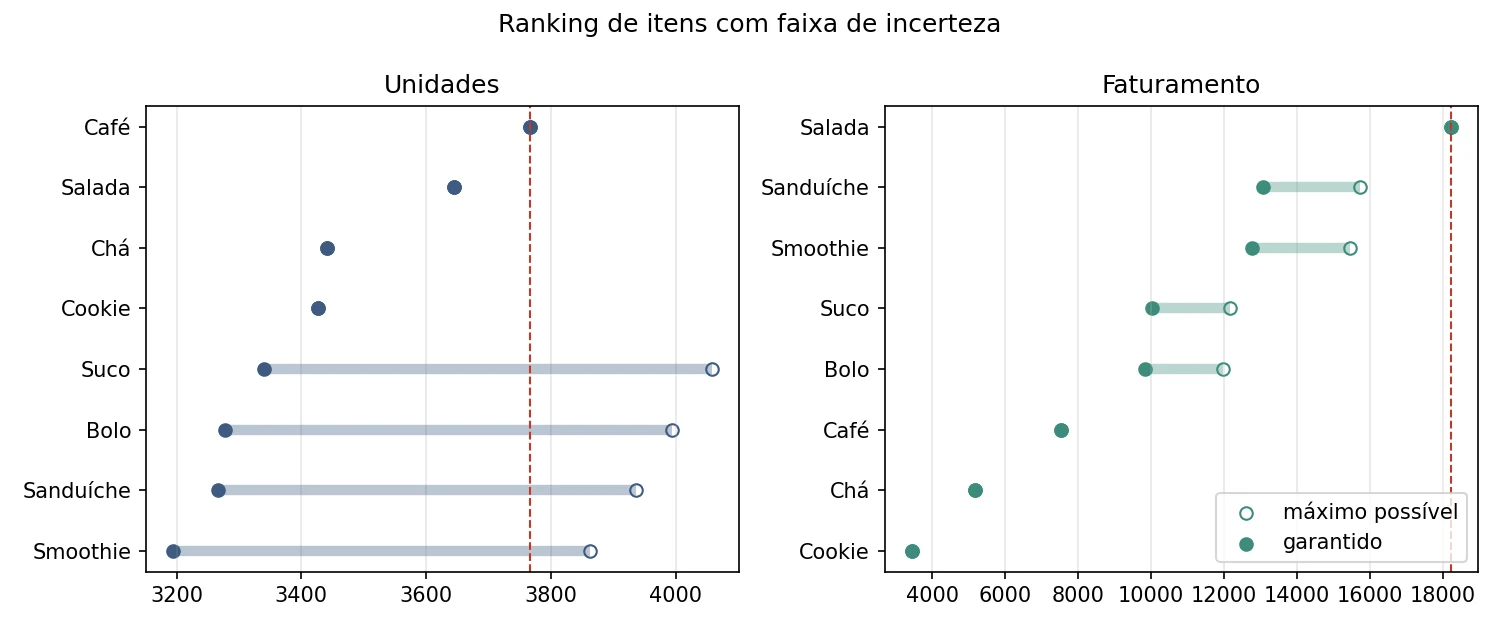
Figura 8. Ranking de itens com faixa de incerteza (saidas/ranking_incerteza.png).
Este é o resultado mais interessante da jornada (Figura 8). Em faturamento, a Salada é líder garantida: seus US$ 18.220,00 superam até o melhor cenário do Sanduíche (US$ 15.744,00). Em unidades, o Café aparece na frente, mas Suco, Bolo, Sanduíche e Smoothie poderiam passá-lo se as vendas não identificadas fossem deles. A pergunta "qual item mais vende?" não tem resposta segura com estes dados, e isso é a análise medindo, com precisão, o custo da qualidade perdida na origem.
Commit no Git
git add .
git commit -m "feat(analise): cria ranking de itens com faixa de incerteza"
12. Fase 6 — Uso
No uso, o dado vira decisão: chega a quem decide, na forma certa e com o grau de confiança explícito. Antes de mostrar qualquer número, uma pergunta: o dado é recente o bastante? O prazo aceitável é o SLA de frescor definido no config.py. Outra regra do uso é a minimização, prevista na LGPD (Lei n.º 13.709/2018) como princípio da necessidade: só os totais da gold saem do ambiente, nunca as vendas individuais. Crie o arquivo uso.py:
uso.py
"""Fase 6a - Uso: entrega indicadores confiáveis a quem decide."""
import pandas as pd

import config
from analise import lider


def verificar_frescor(mensal):
    """Compara a idade da venda mais recente com o SLA combinado."""
    ultima = mensal["ultima_venda"].max()
    idade = (pd.Timestamp.today() - ultima).days   # diferença em dias
    if idade > config.SLA_FRESCOR_DIAS:
        print(f"ALERTA: a venda mais recente é de {ultima:%d/%m/%Y}, "
              f"{config.br(idade)} dias atrás "
              f"(SLA: {config.SLA_FRESCOR_DIAS} dia)")
    return idade


def kpis(mensal):
    """Indicadores-chave (KPIs) do período inteiro."""
    vendas = mensal["vendas"].sum()
    faturamento = mensal["faturamento"].sum()
    return {"Faturamento": config.moeda(faturamento),
            "Vendas": config.br(vendas),
            "Ticket médio": config.moeda(faturamento / vendas),
            "Com dado reconstruído": config.br(
                100 * mensal["recuperadas"].sum() / vendas, 1) + "%"}


def recomendar(ranking):
    """Transforma indicadores em decisões, dizendo quanto confiar."""
    item, ameacas = lider(ranking, "faturamento")
    if not ameacas:
        print(f"DECISÃO: destacar {item} no cardápio: maior faturamento "
              f"mesmo no pior cenário.")
    item, ameacas = lider(ranking, "unidades")
    if ameacas:
        print(f"CUIDADO: não dá para afirmar que {item} é o mais vendido "
              f"em unidades ({', '.join(ameacas)} podem passar).")
        print("AÇÃO NA ORIGEM: tornar o campo item obrigatório no caixa.")


def usar():
    mensal = pd.read_parquet(config.GOLD / "vendas_mensais.parquet")
    ranking = pd.read_parquet(config.GOLD / "ranking_itens.parquet")
    idade = verificar_frescor(mensal)
    indicadores = kpis(mensal)
    for nome, valor in indicadores.items():
        print(f"  {nome:<22} {valor}")
    # Minimização: só agregados saem do ambiente; sep=";" e decimal=","
    # fazem o arquivo abrir direto no Excel em português
    mensal.to_csv(config.SAIDAS / "vendas_mensais.csv", sep=";",
                  decimal=",", index=False)
    recomendar(ranking)
    alerta = "atrasa" if idade > config.SLA_FRESCOR_DIAS else None
    return {"resumo": [f"dado com {config.br(idade)} dias",
                       "painel e decisão"], "alerta": alerta}


if __name__ == "__main__":
    usar()
Terminal
python uso.py
Saída no terminal
ALERTA: a venda mais recente é de 31/12/2023, 995 dias atrás (SLA: 1 dia)
  Faturamento            US$ 84.922,50
  Vendas                 9.517
  Ticket médio           US$ 8,92
  Com dado reconstruído  18,4%
DECISÃO: destacar Salada no cardápio: maior faturamento mesmo no pior cenário.
CUIDADO: não dá para afirmar que Café é o mais vendido em unidades (Suco, Bolo, Sanduíche, Smoothie podem passar).
AÇÃO NA ORIGEM: tornar o campo item obrigatório no caixa.
O alerta aparece porque as vendas são de 2023 (o número de dias depende de quando você executar). É o risco de atraso medido e mostrado, em vez de escondido. E as três últimas linhas são o ponto de chegada da jornada: uma decisão segura, um aviso sobre o que os dados não sustentam e uma ação que resolve o problema na raiz.
Commit no Git
git add .
git commit -m "feat(uso): verifica o frescor e recomenda decisões"
13. Fase 6 — O painel executivo
Quem decide raramente lê tabelas. Vamos montar um painel de uma página, com os indicadores-chave no título e quatro gráficos lidos da gold. Acrescente o matplotlib ao início do uso.py:
uso.py (início)
"""Fase 6a - Uso: entrega indicadores confiáveis a quem decide."""
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd
Acrescente a função painel depois de recomendar:
uso.py (função nova)
def painel(mensal, ranking, categorias, indicadores):
    """Painel executivo de uma página, com quatro gráficos."""
    fig, eixos = plt.subplots(2, 2, figsize=(11, 7))   # grade 2 x 2
    titulo = " | ".join(f"{k}: {v}" for k, v in indicadores.items())
    # parse_math=False: o "quot; de "USquot; não é lido como fórmula matemática
    fig.suptitle("Painel executivo do café\n" + titulo, fontsize=11,
                 parse_math=False)

    ax = eixos[0, 0]   # linha 0, coluna 0
    ax.plot(mensal["mes"].str[5:], mensal["faturamento"], marker="o")
    ax.set_ylim(0, mensal["faturamento"].max() * 1.2)
    ax.set_title("Faturamento por mês (US$)")

    ax = eixos[0, 1]
    ranking = ranking.sort_values("faturamento_min")
    ax.barh(ranking["item"], ranking["faturamento_min"], color="#3D8B7D",
            label="garantido")
    # left=... faz a segunda barra começar onde a primeira termina
    ax.barh(ranking["item"],
            ranking["faturamento_max"] - ranking["faturamento_min"],
            left=ranking["faturamento_min"], color="#3D8B7D", alpha=0.3,
            label="possível")
    ax.set_title("Faturamento por item (US$)")
    ax.legend(loc="lower right")

    for ax, coluna, titulo in [
            (eixos[1, 0], "forma_pagamento", "Vendas por forma de pagamento"),
            (eixos[1, 1], "local", "Vendas por local de consumo")]:
        contagem = categorias.groupby(coluna)["vendas"].sum().sort_values()
        # Cinza para "Não informado": a lacuna fica visível no painel
        cores = ["#BBBBBB" if c == "Não informado" else "#E07A5F"
                 for c in contagem.index]
        ax.barh(contagem.index, contagem.values, color=cores)
        ax.set_title(titulo)

    fig.tight_layout()
    fig.savefig(config.SAIDAS / "painel_executivo.png", dpi=150)
    plt.close(fig)
E, na função usar, leia as categorias e chame o painel logo depois de imprimir os indicadores:
uso.py (trecho da função usar)
    indicadores = kpis(mensal)
    for nome, valor in indicadores.items():
        print(f"  {nome:<22} {valor}")
    categorias = pd.read_parquet(config.GOLD / "categorias.parquet")
    painel(mensal, ranking, categorias, indicadores)
    print("Painel salvo em saidas/painel_executivo.png")
Terminal
python uso.py
Saída no terminal (trecho)
[...]
Painel salvo em saidas/painel_executivo.png
DECISÃO: destacar Salada no cardápio: maior faturamento mesmo no pior cenário.
CUIDADO: não dá para afirmar que Café é o mais vendido em unidades (Suco, Bolo, Sanduíche, Smoothie podem passar).
AÇÃO NA ORIGEM: tornar o campo item obrigatório no caixa.
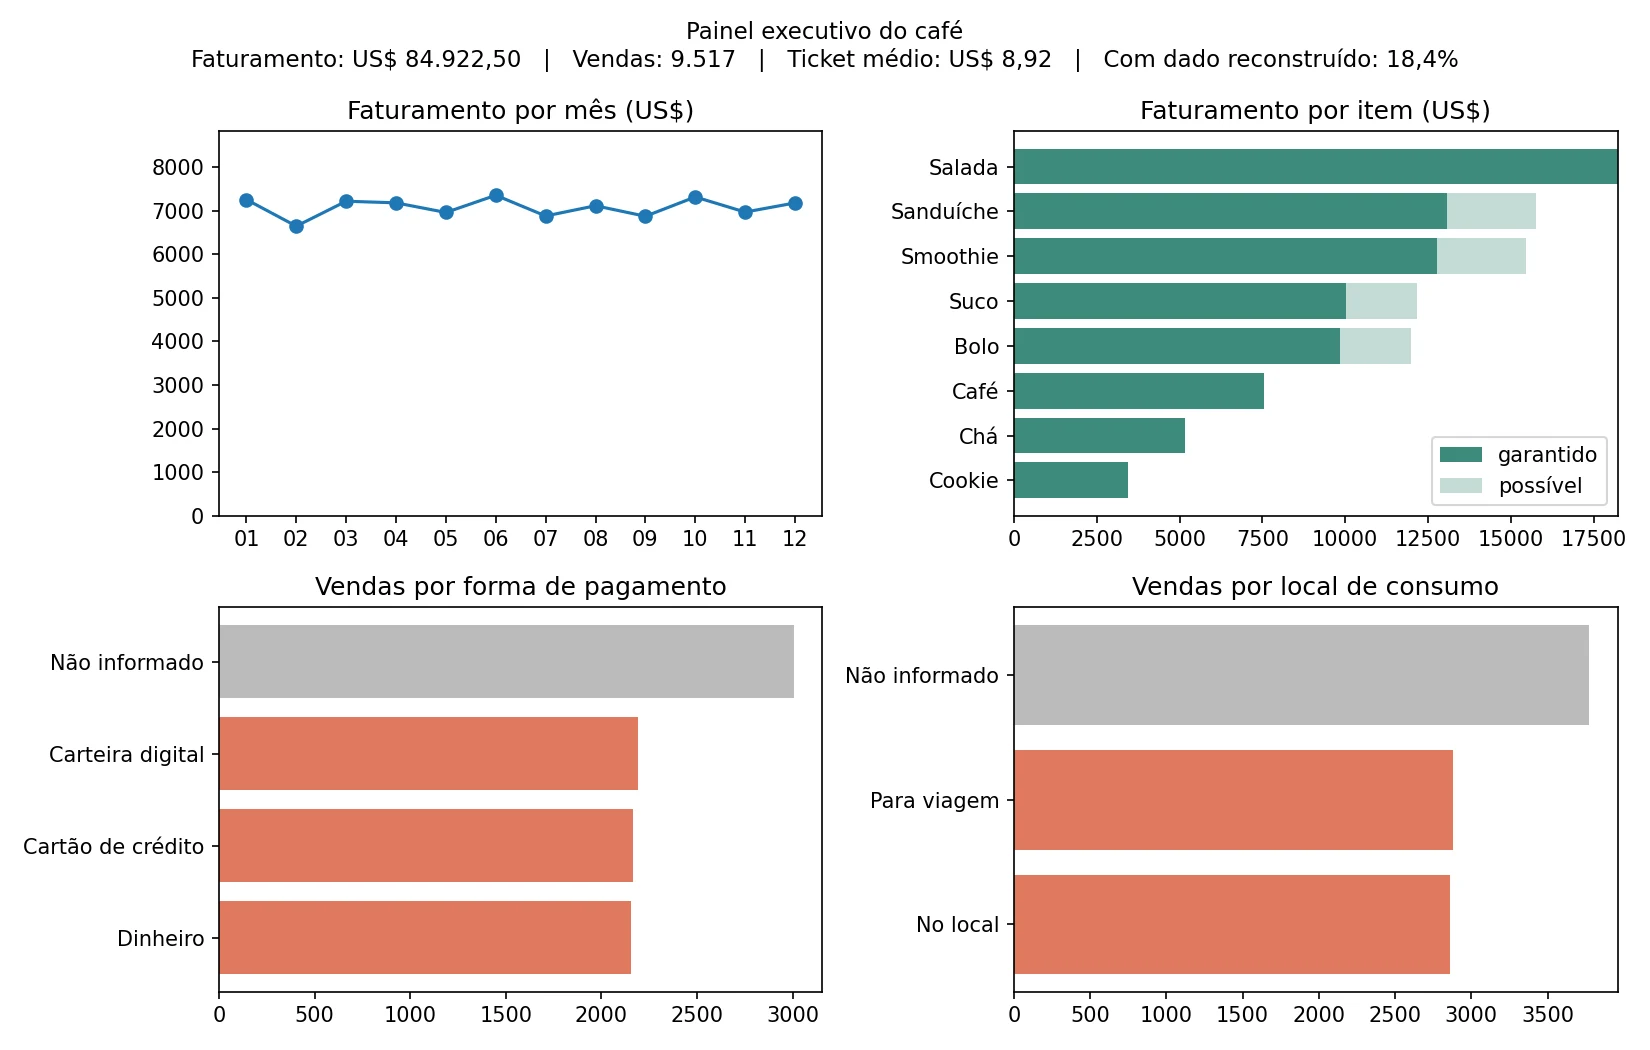
Figura 9. Painel executivo (saidas/painel_executivo.png).
No painel, a maior barra de pagamento e de local é a de Não informado, em cinza: quem decide enxerga onde a informação está faltando. No gráfico de itens, a parte clara de cada barra é a faixa de incerteza.
Commit no Git
git add .
git commit -m "feat(uso): gera o painel executivo"
14. Fase 6 — Descarte e política de retenção
Dado guardado sem necessidade é custo e é risco. A LGPD determina que o tratamento de dados pessoais termina quando a finalidade é alcançada (art. 15) e que os dados devem então ser eliminados, salvo exceções como obrigação legal ou uso com dados anonimizados (art. 16).
Definição: Política de retenção
Regra que define por quanto tempo cada dado é mantido e o que acontece depois: eliminação, anonimização ou arquivamento. Uma boa política cobre todas as cópias do dado, e não só a tabela principal.
Nossa política mantém seis meses de vendas detalhadas, contados a partir da venda mais recente. Os totais da gold, que não identificam vendas individuais, são mantidos (Figura 10).
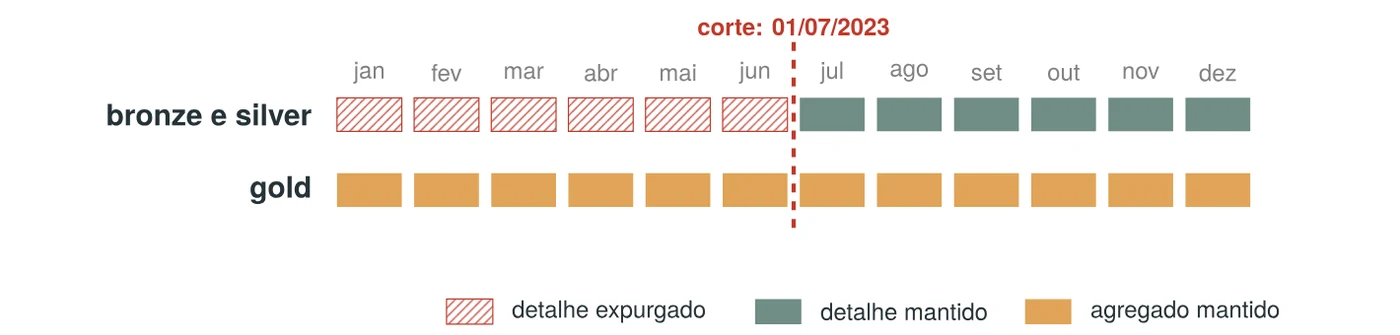
Figura 10. Política de retenção: o detalhe antes do corte é expurgado; os totais permanecem.
O descarte.py trabalha em dois modos. Por padrão ele só simula, mostrando o que seria apagado; com a opção --executar, apaga de verdade. Esse modo de simulação (dry run) é indispensável em qualquer operação que destrói dados.
descarte.py
"""Fase 6b - Descarte: aplica a política de retenção em todas as cópias."""
import sys

import pandas as pd

import config
from armazenamento import inventario, mostrar_inventario

# Arquivos com vendas individuais e a coluna que guarda a data da venda
DETALHE = {config.BRONZE / "vendas.parquet": "Transaction Date",
           config.SILVER / "vendas.parquet": "data",
           config.SILVER / "quarentena.parquet": "data"}


def data_de_corte():
    """Primeiro dia do mês mais antigo que ainda deve ser mantido."""
    silver = pd.read_parquet(config.SILVER / "vendas.parquet")
    # to_period("M") transforma a data no mês dela (ex.: 2023-12)
    ultimo_mes = silver["data"].max().to_period("M")
    primeiro_mes = ultimo_mes - (config.RETENCAO_MESES - 1)
    return primeiro_mes.to_timestamp()   # volta a ser data: dia 1 do mês


def descartar(executar=False):
    corte = data_de_corte()
    print("Modo:", "EXECUÇÃO" if executar else "SIMULAÇÃO (nada é apagado)")
    print(f"Política: manter vendas a partir de {corte:%d/%m/%Y}")
    total = 0
    for arquivo, coluna in DETALHE.items():
        df = pd.read_parquet(arquivo)
        datas = pd.to_datetime(df[coluna], format="%Y-%m-%d",
                               errors="coerce")
        vencidas = datas < corte   # sem data (nulo) nunca é "vencida"
        print(f"  {arquivo.parent.name}/{arquivo.name:<20} "
              f"{config.br(vencidas.sum()):>6} linhas vencidas")
        total += vencidas.sum()
        if executar:
            # Regrava o arquivo só com as linhas dentro do prazo
            df[~vencidas].to_parquet(arquivo, index=False)
    if executar:
        print("Inventário depois do descarte:")
        mostrar_inventario(inventario())
    else:
        print("Para apagar de verdade: python descarte.py --executar")
    return {"resumo": [f"{config.br(total)} linhas", "expurgadas"]}


if __name__ == "__main__":
    # sys.argv é a lista de palavras digitadas depois de "python"
    descartar(executar="--executar" in sys.argv)
Terminal
python descarte.py
python descarte.py --executar
Saída da simulação
Modo: SIMULAÇÃO (nada é apagado)
Política: manter vendas a partir de 01/07/2023
  bronze/vendas.parquet         4.741 linhas vencidas
  silver/vendas.parquet         4.728 linhas vencidas
  silver/quarentena.parquet        13 linhas vencidas
Para apagar de verdade: python descarte.py --executar
Saída da execução
Modo: EXECUÇÃO
Política: manter vendas a partir de 01/07/2023
  bronze/vendas.parquet         4.741 linhas vencidas
  silver/vendas.parquet         4.728 linhas vencidas
  silver/quarentena.parquet        13 linhas vencidas
Inventário depois do descarte:
  bronze   vendas.parquet                   5.259 linhas
  entrada  dirty_cafe_sales.csv            10.000 linhas
  gold     categorias.parquet                  12 linhas
  gold     ranking_itens.parquet                8 linhas
  gold     vendas_mensais.parquet              12 linhas
  raw      vendas_2026-09-21.csv           10.000 linhas
  silver   quarentena.parquet                 470 linhas
  silver   vendas.parquet                   4.789 linhas
A silver caiu de 9.517 para 4.789 vendas e a bronze de 10.000 para 5.259, enquanto a gold continua com os 12 meses. Mas o inventário revela duas cópias com o ano inteiro: o arquivo baixado em entrada/ e o da zona de pouso em raw/. Uma política completa também precisa alcançá-las, assim como backups e arquivos exportados.
Commit no Git
git add .
git commit -m "feat(descarte): aplica a política de retenção"
15. A jornada completa
Falta o maestro: um arquivo que execute todas as fases na ordem, com um único comando, e desenhe o mapa da jornada. Cada fase já devolve um dicionário com um resumo e, quando for o caso, um alerta. O pipeline.py cronometra cada fase e desenha uma caixa por etapa.
pipeline.py
"""Executa a jornada inteira e desenha o mapa da jornada."""
import time

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

import config
from analise import analisar
from armazenamento import armazenar
from captura import capturar
from descarte import descartar
from ingestao import ingerir
from tratamento import tratar
from uso import usar


def descartar_de_verdade():
    return descartar(executar=True)


# A jornada, na ordem: (título, função, cor da caixa no mapa)
JORNADA = [("Captura", capturar, "#3D5A80"),
           ("Ingestão", ingerir, "#4F7CAC"),
           ("Armazenamento", armazenar, "#5E9C8F"),
           ("Tratamento", tratar, "#3D8B7D"),
           ("Análise", analisar, "#E0A458"),
           ("Uso", usar, "#E07A5F"),
           ("Descarte", descartar_de_verdade, "#8D6A9F")]


def executar_jornada():
    resultados = []
    for titulo, funcao, cor in JORNADA:
        print(f"\n========== {titulo} ==========")
        inicio = time.perf_counter()   # cronômetro de alta precisão
        resultado = funcao()
        resultado["segundos"] = time.perf_counter() - inicio
        resultados.append(resultado)
    return resultados


def mapa_da_jornada(resultados):
    """Uma linha por etapa: caixa com o tempo, resumo e alerta."""
    fig, ax = plt.subplots(figsize=(9.5, 5))
    ax.set_xlim(0, 12)
    ax.set_ylim(-0.6, len(JORNADA) - 0.4)
    ax.axis("off")   # desenho livre, sem eixos
    for i, ((titulo, _, cor), res) in enumerate(zip(JORNADA, resultados)):
        y = len(JORNADA) - 1 - i   # a primeira etapa fica no alto
        ax.text(0.2, y, f"{titulo}  {config.br(res['segundos'], 2)} s",
                va="center", color="white", fontsize=10, fontweight="bold",
                bbox=dict(boxstyle="round,pad=0.5", facecolor=cor,
                          edgecolor="none"))   # bbox: a caixa do texto
        ax.text(3.6, y, " | ".join(res["resumo"]), va="center",
                fontsize=10)
        if res.get("alerta"):   # get: devolve None se não houver alerta
            ax.text(11.9, y, "⚠ " + res["alerta"], ha="right", va="center",
                    color="white", fontsize=10, fontweight="bold",
                    bbox=dict(boxstyle="round", facecolor="#C0392B",
                              edgecolor="none"))
        if i < len(JORNADA) - 1:   # seta para a próxima etapa
            ax.annotate("", xy=(0.6, y - 0.72), xytext=(0.6, y - 0.28),
                        arrowprops=dict(arrowstyle="->"))
    ax.set_title("Mapa da jornada de dados", fontsize=13, fontweight="bold")
    fig.savefig(config.SAIDAS / "mapa_da_jornada.png", dpi=150,
                bbox_inches="tight")
    plt.close(fig)


if __name__ == "__main__":
    resultados = executar_jornada()
    mapa_da_jornada(resultados)
    print("\nMapa salvo em saidas/mapa_da_jornada.png")
Terminal
python pipeline.py
Saída no terminal (início e fim)
========== Captura ==========
O arquivo de hoje já foi capturado: vendas_2026-09-21.csv
  10.000 linhas, 527,6 KiB

========== Ingestão ==========
Camada bronze: 10.000 linhas gravadas
[...]

========== Descarte ==========
Modo: EXECUÇÃO
Política: manter vendas a partir de 01/07/2023
  bronze/vendas.parquet         4.741 linhas vencidas
  silver/vendas.parquet         4.728 linhas vencidas
  silver/quarentena.parquet        13 linhas vencidas
[...]

Mapa salvo em saidas/mapa_da_jornada.png
Como o pipeline começa do arquivo bruto, a ingestão recarrega a bronze completa e o descarte volta a aplicar a política no final: rodar o pipeline uma ou dez vezes leva sempre ao mesmo resultado.
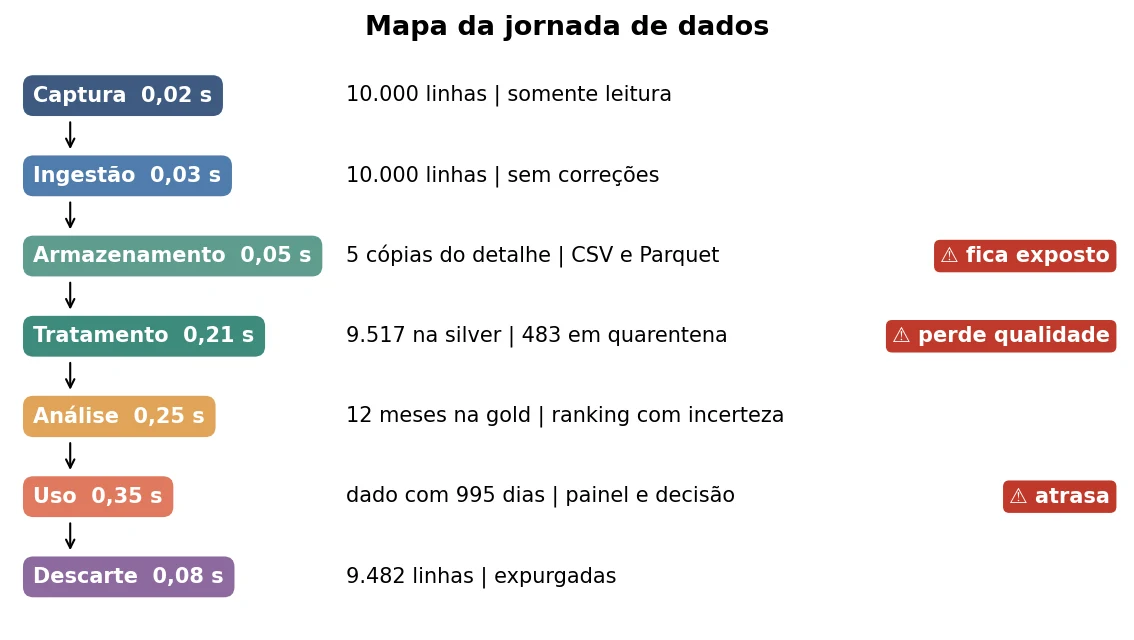
Figura 11. Mapa da jornada (saidas/mapa_da_jornada.png).
O mapa (Figura 11) responde à pergunta do início: o dado fica exposto no armazenamento, com várias cópias do detalhe; perde qualidade no tratamento, com 483 vendas em quarentena; e atrasa no uso, com centenas de dias de idade. Cada alerta aponta para um ponto da jornada e para quem pode agir sobre ele.
Commit no Git
git add .
git commit -m "feat(pipeline): executa a jornada completa e desenha o mapa"
O histórico do projeto conta a construção inteira, do primeiro ao último commit (os códigos à esquerda serão outros na sua máquina):
Terminal
git log --oneline
Saída no terminal
db35848 feat(pipeline): executa a jornada completa e desenha o mapa
2c5f053 feat(descarte): aplica a política de retenção
907242b feat(uso): gera o painel executivo
152f89f feat(uso): verifica o frescor e recomenda decisões
c68bc52 feat(analise): cria ranking de itens com faixa de incerteza
68bb696 feat(analise): calcula indicadores mensais na camada gold
338d33e feat(tratamento): grava a camada silver e a quarentena
88e6a53 feat(tratamento): padroniza e recupera valores com regras
af02e8f feat(tratamento): diagnostica a qualidade da camada bronze
7f6cb5f feat(armazenamento): compara formatos e inventaria cópias
8fc9dc7 feat(ingestao): carrega o arquivo bruto na camada bronze
36ac9c7 feat(captura): copia o arquivo para a zona de pouso
100c997 chore: cria estrutura inicial do projeto
16. Exercícios
Resolva no VS Code, alterando o projeto que você construiu. Consulte a resposta só depois de tentar.
1. Explique, com um exemplo fora do café, como o dado pode perder qualidade, atrasar e ficar exposto em cada uma das seis fases.
2. Por que a captura não corrige o ERROR do arquivo? O que se perderia se corrigisse?
Ver resposta
1. Um exemplo: sensores de temperatura numa fábrica. Captura: um sensor descalibrado manda leituras erradas (qualidade); a coleta a cada hora esconde picos (atraso); o arquivo trafega sem criptografia (exposição). Ingestão: uma falha de rede duplica um lote (qualidade); o reprocessamento leva horas (atraso); a cópia bruta fica num compartilhamento aberto (exposição). Armazenamento: a temperatura é gravada como texto (qualidade); CSV gigante lento de ler (atraso); backups sem controle (exposição). Tratamento: uma leitura ausente é preenchida com a média (qualidade); regras aplicadas à mão numa planilha (atraso); dado copiado para um ambiente de testes (exposição). Análise: a média inclui leituras inválidas (qualidade); recálculo completo a cada consulta (atraso); relatório com o detalhe de cada sensor (exposição). Uso e descarte: decisão sem saber a confiança (qualidade); painel com dado de ontem tratado como atual (atraso); histórico guardado por anos sem necessidade (exposição).
2. Porque a captura precisa guardar a prova do que a origem enviou. Se o ERROR fosse corrigido ali, ninguém saberia que o caixa tem um defeito, a correção não poderia ser revista se a regra mudasse, e o tratamento não poderia ser refeito do zero a partir do dado original.
3. Altere a ingestão para acrescentar as linhas ao final da bronze, em vez de gravar por cima. Rode duas vezes, observe o total de linhas e explique o que é idempotência.
4. Faça o captura.py apagar o arquivo de dados/entrada/ depois de copiá-lo para a zona de pouso. Qual risco isso reduz?
Ver resposta
3. Uma forma de acrescentar:
destino = config.BRONZE / "vendas.parquet"
if destino.exists():
    bronze = pd.concat([pd.read_parquet(destino), bronze])
bronze.to_parquet(destino, index=False)
Na segunda execução a bronze passa a ter 20.000 linhas, e o faturamento dobra sem nenhum erro aparente. A operação deixou de ser idempotente: executá-la várias vezes não dá mais o mesmo resultado que executá-la uma vez.
4. Depois de shutil.copy(origem, destino), acrescente origem.unlink(). Isso reduz o risco de exposição: uma cópia a menos do detalhe das vendas, e justamente a que estava esquecida fora das camadas controladas. Confira no inventário do armazenamento.py, que passa a listar duas cópias em vez de três.
5. Inclua no diagnóstico uma medida de unicidade: o percentual de id_transacao que não se repete.
6. Inclua no contrato da silver um assert que verifique se total é igual a quantidade vezes preco_unitario.
Ver resposta
5. Em diagnosticar, calcule e devolva também:
unicidade = (~df["id_transacao"].duplicated()).mean() * 100
Em mostrar_diagnostico, imprima Unicidade de id_transacao: 100,0%. Na base do café, os identificadores são todos únicos.
6. Antes de gravar a silver:
esperado = silver["quantidade"] * silver["preco_unitario"]
assert (silver["total"] == esperado).all(), "total diferente de qtd × preço"
Se o assert falhar, investigue: há vendas em que os três valores vieram preenchidos da origem, mas inconsistentes entre si. Elas são candidatas à quarentena, com um motivo novo.
7. Na análise, calcule o faturamento por mês e por local de consumo com uma consulta SQL no DuckDB e grave o resultado na gold.
8. Mude o SLA de frescor para 2.000 dias. O que acontece com o alerta e com o mapa da jornada? Em que situação real um SLA longo faria sentido?
Ver resposta
7.
por_local = duckdb.sql(f"""
    SELECT strftime(data, '%Y-%m') AS mes, local,
           sum(total) AS faturamento
    FROM '{SILVER}'
    GROUP BY mes, local ORDER BY mes, local""").df()
por_local.to_parquet(config.GOLD / "faturamento_por_local.parquet",
                     index=False)
8. Com SLA_FRESCOR_DIAS = 2000, o alerta some da saída do uso.py e a caixa "atrasa" desaparece do mapa da jornada. Um SLA longo faz sentido para dados que mudam devagar ou são consultados por ano, como um censo, o histórico de vendas de anos anteriores usado para comparação ou um cadastro que se atualiza uma vez por semestre.
9. Altere a política de retenção para 3 meses. Rode primeiro a simulação e depois a execução, e compare os inventários.
10. Um gestor viu o painel e concluiu: "o Café é o nosso item mais vendido, vamos dobrar o estoque de grãos". Escreva uma resposta a ele, em até dez linhas, usando o ranking com incerteza.
Ver resposta
9. Com RETENCAO_MESES = 3, o corte passa a ser 01/10/2023. A simulação mostra cerca de 7.100 linhas vencidas na bronze e 7.100 na silver; depois da execução, a silver fica com aproximadamente 2.400 vendas (outubro, novembro e dezembro) e a gold continua com 12 meses. As cópias em entrada/ e raw/ seguem com o ano inteiro.
10. Um exemplo de resposta: "O Café aparece em primeiro em unidades, com 3.766 garantidas, mas 489 vendas não têm o item identificado. Se as de preço 2,00 forem dele, ele continua líder; se as de 3,00 e 4,00 forem de Suco, Bolo, Sanduíche ou Smoothie, qualquer um dos quatro pode ultrapassá-lo. Com os dados de hoje, não dá para afirmar que o Café é o mais vendido. O que dá para afirmar é que a Salada é a líder garantida em faturamento. Antes de dobrar o estoque de grãos, sugiro tornar o campo item obrigatório no caixa e reavaliar em um mês, com dados completos."
Referências
- BRASIL. Lei n.º 13.709, de 14 de agosto de 2018. Lei Geral de Proteção de Dados Pessoais (LGPD). Disponível em: planalto.gov.br.
- CONVENTIONAL COMMITS. Conventional Commits 1.0.0. Disponível em: conventionalcommits.org.
- DAMA INTERNATIONAL. DAMA-DMBOK: data management body of knowledge. 2. ed. Basking Ridge: Technics Publications, 2017.
- HEUSER, Carlos Alberto. Projeto de banco de dados. 6. ed. Porto Alegre: Bookman, 2011.
- MOHAMED, Ahmed. Cafe Sales – Dirty Data for Cleaning Training. Kaggle, 2025. Disponível em: kaggle.com.
- MOSES, Barr; GAVISH, Lior; VORWERCK, Molly. Data quality fundamentals. Sebastopol: O'Reilly Media, 2022.
- RÊGO, Bergson Lopes. Simplificando a governança de dados. São Paulo: Brasport, 2020.
- REIS, Joe; HOUSLEY, Matt. Fundamentals of data engineering. Sebastopol: O'Reilly Media, 2022.