Tabela hash: conceitos, implementação e uso em Java
Entenda como uma tabela hash transforma uma chave em um endereço de acesso direto, trate colisões por encadeamento separado, implemente a estrutura em Java passo a passo e use HashMap e LinkedHashMap da biblioteca padrão.
1. Visão geral
A tabela hash é uma estrutura que transforma uma chave qualquer em um endereço de acesso direto. Neste codelab você vai entender a ideia, implementá-la em Java do zero e depois usar as implementações prontas da biblioteca padrão.
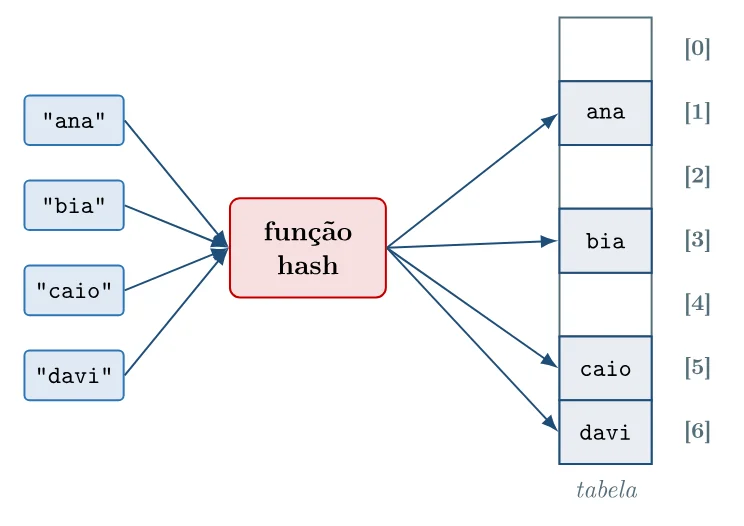
Uma estrutura que transforma uma chave qualquer em um endereço de acesso direto.
O que você vai aprender
- O que é uma tabela hash e o papel da função hash
- Por que colisões são inevitáveis e como tratá-las com encadeamento separado
- Cinco aplicações típicas de tabelas hash
- O pseudocódigo das operações de inserção, busca e remoção, com simulações
- Uma implementação completa em Java, construída passo a passo
- As diferenças entre
HashMapeLinkedHashMape quando usar cada uma
O que você vai precisar
- Um JDK instalado (
javacejava) - Conhecimento de vetores, listas encadeadas e notação assintótica
2. O que é uma tabela hash?
Até aqui você conheceu estruturas que organizam os dados de duas formas: em sequência (vetores, listas, pilhas e filas) e hierárquica (árvores). Em todas elas, encontrar um elemento exige percorrer parte da estrutura, comparando valores.
A tabela hash parte de uma ideia bem diferente: em vez de percorrer e comparar, ela calcula diretamente onde o dado está. A chave que identifica o dado é transformada, por uma função, em um índice de um vetor. E é nesse índice que o dado vive.
Ideia central
Tabela hash: estrutura que armazena pares
(chave, valor)dentro de um vetor de tamanho fixo, usando uma função hash para traduzir cada chave no índice em que o par deve ficar.
O esquema básico
Imagine que queremos guardar pares (nome, telefone). Em uma lista, gastaríamos tempo proporcional a $n$ para encontrar um nome. Em uma árvore binária de busca equilibrada, gastaríamos $\log n$. Em uma tabela hash, com uma boa função hash, gastamos tempo constante em média.
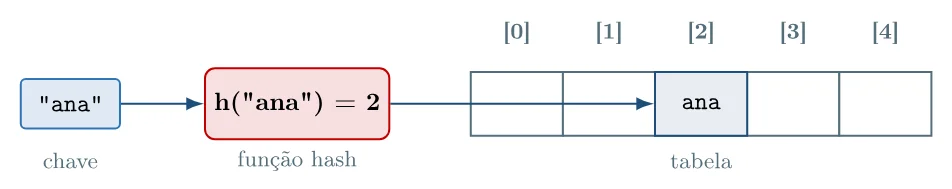
A função hash leva a chave diretamente à sua posição na tabela.
A função hash
A função hash é o coração da estrutura. Ela recebe uma chave (de qualquer tipo: string, inteiro, objeto) e devolve um número inteiro entre $0$ e $M - 1$, onde $M$ é o tamanho da tabela.
Uma função hash deve ter três qualidades:
- Determinística: a mesma chave sempre produz o mesmo índice.
- Rápida: calcular o índice deve ser muito mais barato do que procurar o dado em uma lista ou árvore.
- Bem distribuída: chaves diferentes devem espalhar-se uniformemente pela tabela, ocupando todos os índices possíveis.
Um exemplo simples para chaves inteiras é a função módulo:
$h(k) = k \bmod M$
Com $M = 7$ e a chave $k = 23$, temos $h(23) = 23 \bmod 7 = 2$, ou seja, o índice 2.
O problema das colisões
Por mais cuidadosa que seja a função hash, em algum momento duas chaves diferentes vão produzir o mesmo índice. Isso é o que chamamos de colisão.
A técnica mais comum e didática é o encadeamento separado: cada posição da tabela guarda uma pequena lista de pares. Quando duas chaves colidem, ambas vivem na mesma lista.
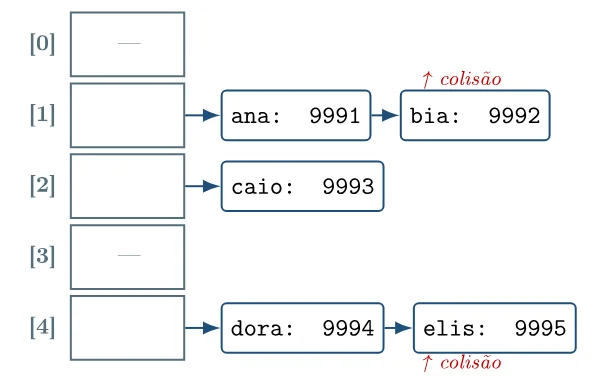
Encadeamento separado: cada posição guarda uma lista de pares.
Cada posição vira o início de uma pequena lista encadeada. Se a função hash for boa, essas listas ficam curtas (a maioria com 0 ou 1 par), preservando o desempenho da estrutura.
3. Aplicações e procedimentos
Cinco aplicações de tabelas hash
Tabelas hash são uma das estruturas de dados mais usadas no mundo real. A combinação de inserção, busca e remoção em tempo praticamente constante torna a estrutura natural para inúmeros problemas. Veja cinco aplicações típicas:
- Dicionários e mapas em linguagens de programação. Estruturas como
HashMap(Java),dict(Python) ouMap(JavaScript) são tabelas hash. Toda vez que você associa uma chave a um valor, há uma tabela hash trabalhando por baixo. - Caches. Sistemas que precisam guardar resultados temporários (por exemplo, navegadores guardando páginas visitadas, ou servidores guardando consultas a um banco de dados) usam tabelas hash para verificar instantaneamente se o conteúdo já foi calculado.
- Indexação em bancos de dados. Muitos bancos oferecem índices baseados em hash para encontrar uma linha pela chave primária em tempo constante, em vez de percorrer a tabela inteira.
- Detecção de duplicatas. Quando precisamos verificar se um elemento já apareceu (por exemplo, conferir se um e-mail já está cadastrado, ou se um IP fez muitas requisições), basta consultar uma tabela hash.
- Contagem de frequência. Contar quantas vezes cada palavra aparece em um texto, quantas vezes cada produto foi vendido, quantos usuários acessaram cada página: a tabela hash leva o item como chave e mantém um contador como valor.
Procedimentos para implementar uma tabela hash
Antes de mergulhar no código, vamos listar quais peças precisamos construir. Toda tabela hash com encadeamento separado é formada pelos seguintes procedimentos:
- Função hash. Recebe a chave e devolve um índice válido (entre $0$ e $M - 1$).
- Inserir (chave, valor). Calcula o índice da chave, percorre a lista daquela posição, e ou substitui o valor (se a chave já existir) ou adiciona um novo par no final.
- Buscar (chave). Calcula o índice da chave, percorre a lista daquela posição procurando o par com a chave dada e devolve o valor (ou
null, se não encontrar). - Remover (chave). Calcula o índice da chave, percorre a lista daquela posição e retira o par cuja chave coincide.
A estrutura interna precisa de:
- Um vetor de tamanho $M$ (a tabela em si).
- Cada posição do vetor é uma lista encadeada de pares
(chave, valor). - Um contador
tamanhocom o número de pares armazenados (útil para estatísticas como o fator de carga).
4. Pseudocódigo: função hash e inserção
Em todos os exemplos desta seção, usamos uma tabela de tamanho $M = 7$ e a função hash $h(k) = k \bmod 7$ para chaves inteiras.
Função hash
A função hash é a mais simples: recebe a chave e devolve um índice da tabela.
Pseudocódigo: hash
1  função hash(chave, M):
2    retornar chave mod M
Para chaves do tipo string, uma técnica clássica é somar os códigos numéricos de cada caractere e aplicar o módulo no final. Isso garante que cada string produza um índice estável.
Inserir (chave, valor)
A inserção precisa cuidar de dois casos: a chave já existe (substituímos o valor) ou ainda não existe (adicionamos um novo par).
Pseudocódigo: inserir
1  procedimento inserir(chave, valor):
2    i ← hash(chave, M)
3    para cada par em tabela[i]:
4      se par.chave = chave então
5        par.valor ← valor          // chave já existia: atualiza
6        retornar
7    adicionar (chave, valor) ao fim de tabela[i]
8    tamanho ← tamanho + 1
Simulação. Vamos inserir, em sequência, os pares (10, "A"), (17, "B") e (3, "C") em uma tabela vazia de tamanho 7. Os índices calculados são:
$h(10) = 10 \bmod 7 = 3, \quad h(17) = 17 \bmod 7 = 3, \quad h(3) = 3 \bmod 7 = 3.$
Os três caem na mesma posição [3] — ou seja, vamos provocar colisões propositalmente.
Passo 1. Inserir (10, "A"). Calcula $h(10) = 3$. A posição [3] está vazia, então adicionamos o par lá.
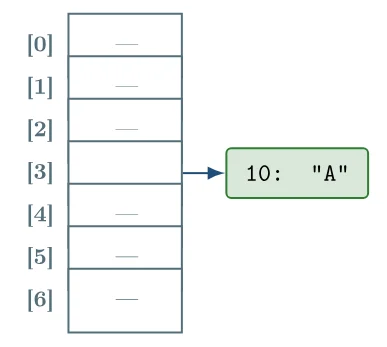
Passo 1: o par (10, "A") ocupa a posição [3].
Passo 2. Inserir (17, "B"). Calcula $h(17) = 3$. A posição [3] já tem o par (10, "A"). Percorremos a lista: a chave 17 é diferente de 10. Não encontramos, então adicionamos no final.
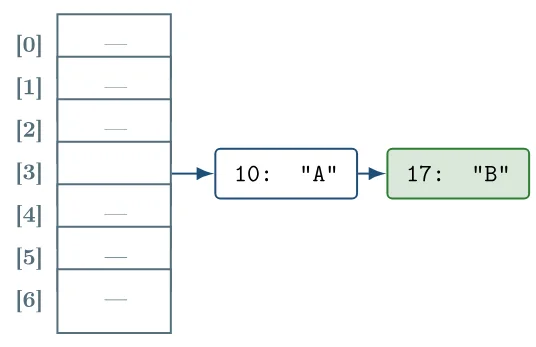
Passo 2: colisão; (17, "B") entra no fim da lista.
Passo 3. Inserir (3, "C"). Calcula $h(3) = 3$. Percorremos a lista da posição [3]: 10 não é 3, 17 não é 3. Adicionamos no final.
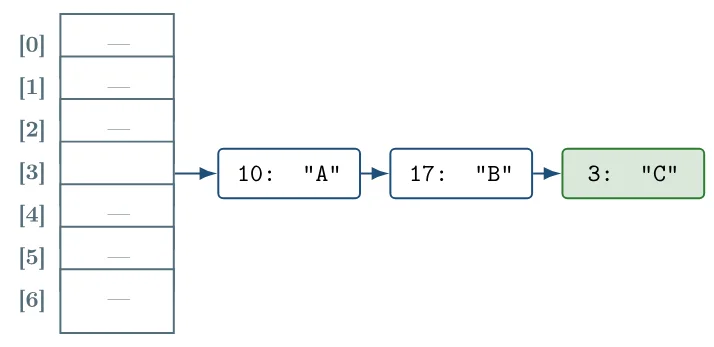
Passo 3: nova colisão; (3, "C") entra no fim da lista.
Passo 4. Agora inserimos (10, "X"). $h(10) = 3$. Percorremos a lista da posição [3]: o primeiro par tem chave 10, exatamente a que estamos inserindo. Logo, substituímos o valor "A" por "X" (não adicionamos um novo par).
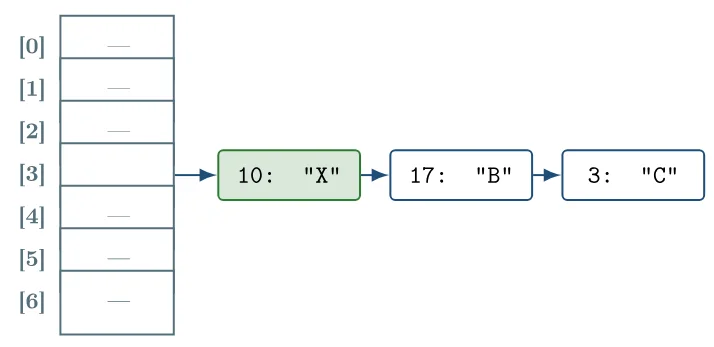
Passo 4: a chave 10 já existia, então só o valor muda.
O par destacado em verde teve seu valor atualizado de "A" para "X". A lista da posição [3] continua com três pares, e o tamanho da tabela permanece 3.
5. Pseudocódigo: busca e remoção
Buscar (chave)
A busca segue exatamente o mesmo caminho da inserção: calcula o índice, vai até a lista certa e procura linearmente pela chave.
Pseudocódigo: buscar
1  função buscar(chave):
2    i ← hash(chave, M)
3    para cada par em tabela[i]:
4      se par.chave = chave então
5        retornar par.valor
6    retornar nulo
Simulação. Considere a tabela construída na inserção (após o passo 4): a posição [3] contém a lista [(10,"X"), (17,"B"), (3,"C")] e todas as outras posições estão vazias. Vamos buscar a chave 17.
Passo 1. Calcula $h(17) = 17 \bmod 7 = 3$. Vamos olhar a lista da posição [3].
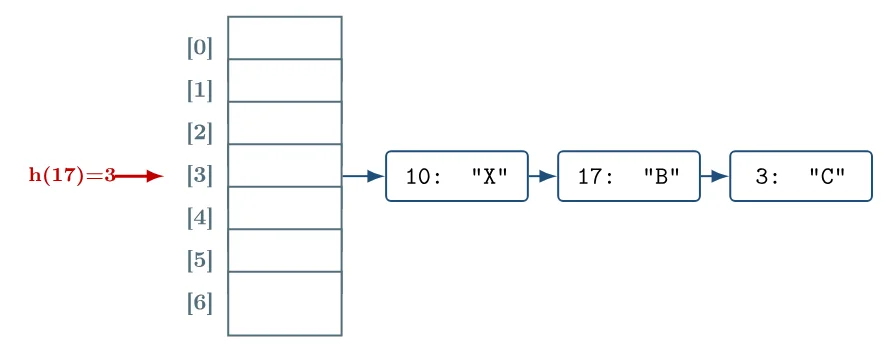
Passo 1: a função hash leva à posição [3].
Passo 2. Percorremos a lista da esquerda para a direita. O primeiro par é (10, "X"); chave 10 não é a procurada (17). Seguimos.
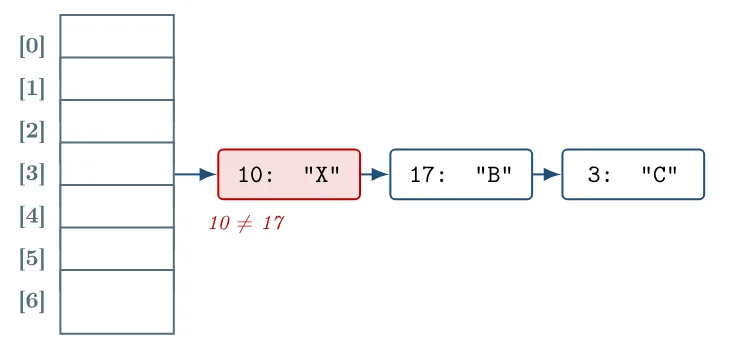
Passo 2: $10 \neq 17$, seguimos.
Passo 3. Próximo par: (17, "B"). Achamos! Devolvemos o valor "B".
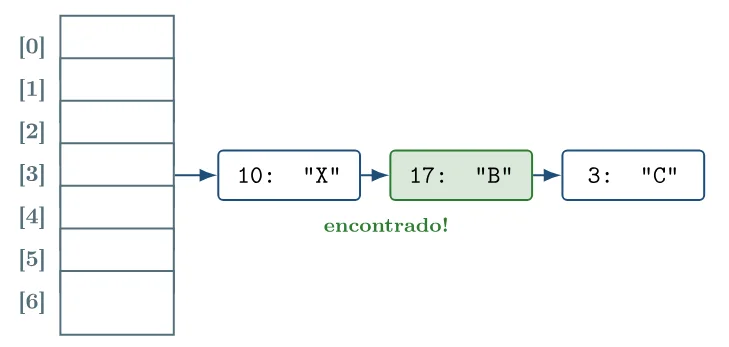
Passo 3: chave encontrada.
Note que, mesmo com colisão, a busca foi rápida: percorremos apenas 2 pares na lista da posição [3], em vez de varrer toda a tabela.
Remover (chave)
A remoção segue o mesmo padrão das duas operações anteriores: calcula o índice, percorre a lista e retira o par cuja chave bate.
Pseudocódigo: remover
1  procedimento remover(chave):
2    i ← hash(chave, M)
3    para cada par em tabela[i]:
4      se par.chave = chave então
5        retirar par de tabela[i]
6        tamanho ← tamanho - 1
7        retornar
8    // se chegou aqui, a chave não existia
Simulação. Continuamos com a tabela depois da inserção: a posição [3] guarda a lista [(10,"X"), (17,"B"), (3,"C")]. Vamos remover a chave 17.
Passo 1. Calcula $h(17) = 3$. Vamos à lista da posição [3].
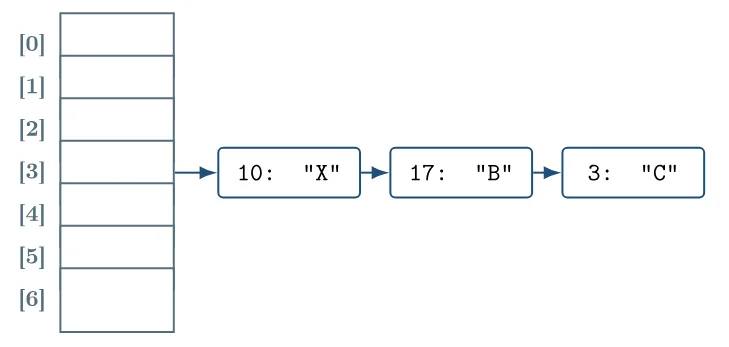
Passo 1: vamos à lista da posição [3].
Passo 2. Procuramos o par com chave 17. Ele é o segundo da lista. Marcamos para remoção.
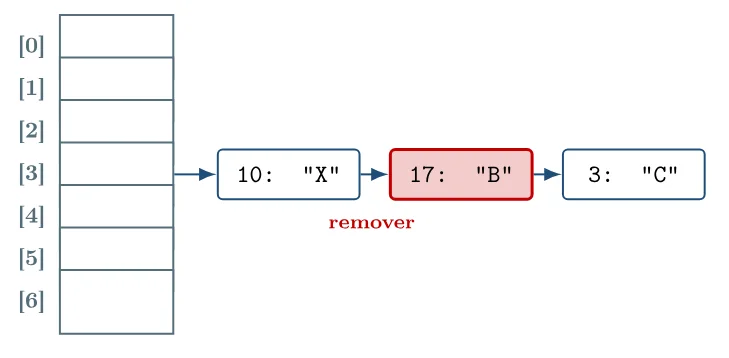
Passo 2: o par com chave 17 é marcado para remoção.
Passo 3. Retiramos o par e religamos a lista, ligando (10,"X") diretamente a (3,"C").
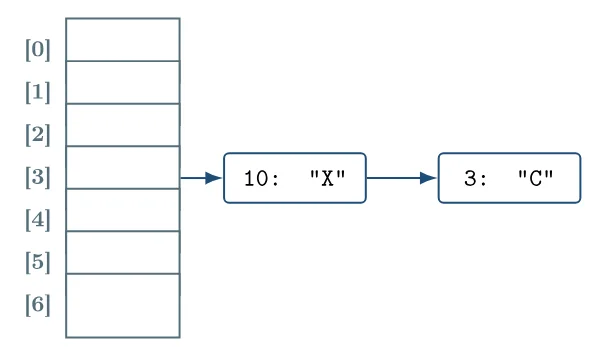
Passo 3: a lista é religada sem o par removido.
O contador tamanho é decrementado em 1. Se a chave 17 não existisse na lista, simplesmente nada seria feito.
6. Java: classe Par, esqueleto e função hash
A cada novo trecho de código, mostramos a classe com o que foi acrescentado. A estrutura final terá duas classes:
Par— representa um par(chave, valor);TabelaHash— contém o vetor de listas e as operações.
Passo 1: a classe Par
Cada elemento armazenado na tabela é um par com uma chave (do tipo Integer) e um valor (do tipo String). Por simplicidade didática, fixamos esses tipos; mais adiante veremos como o Java resolve isso de forma genérica.
Par.java
public class Par {
    int chave;
    String valor;

    public Par(int chave, String valor) {
        this.chave = chave;
        this.valor = valor;
    }
}
Explicação: a classe Par é simples e direta. Ela apenas agrupa uma chave e um valor que viajam juntos.
Passo 2: esqueleto da classe TabelaHash
A classe que representa a tabela inteira precisa, no mínimo, de:
- um vetor de listas (
tabela) onde cada posição guarda os pares que caem ali; - uma constante
Mcom o tamanho da tabela; - um contador
tamanhocom o número total de pares.
TabelaHash.java
import java.util.LinkedList;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() {
        this.tabela = new LinkedList[M];
        for (int i = 0; i < M; i++) {
            this.tabela[i] = new LinkedList<>();
        }
        this.tamanho = 0;
    }
}
Explicação: usamos LinkedList<Par> para representar a lista encadeada em cada posição. No construtor, criamos o vetor com M posições e inicializamos cada uma com uma lista vazia. A anotação @SuppressWarnings("unchecked") silencia o aviso do compilador sobre genéricos em arrays (uma limitação histórica do Java).
Passo 3: a função hash
Como nosso M é 7 e a chave é um inteiro, basta calcular o módulo. Acrescentamos Math.abs para garantir que o resultado nunca seja negativo (em Java, o operador % pode devolver valor negativo se o primeiro operando for negativo).
TabelaHash.java
import java.util.LinkedList;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() {
        this.tabela = new LinkedList[M];
        for (int i = 0; i < M; i++) {
            this.tabela[i] = new LinkedList<>();
        }
        this.tamanho = 0;
    }
    private int hash(int chave) {
        return Math.abs(chave) % M;
    }
}
Explicação: a função recebe a chave inteira e devolve um índice entre $0$ e $M - 1$. É a tradução literal do nosso pseudocódigo.
7. Java: inserção, busca e remoção
Nos trechos a seguir, os métodos já apresentados aparecem resumidos como { /* ... */ } para destacar o que é novo.
Passo 4: inserção
Agora o método inserir: calcula o índice, percorre a lista daquela posição e ou atualiza um par existente ou adiciona um novo.
TabelaHash.java
import java.util.LinkedList;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() { /* ... */ }

    private int hash(int chave) { /* ... */ }
    public void inserir(int chave, String valor) {
        int i = hash(chave);
        for (Par par : tabela[i]) {
            if (par.chave == chave) {
                par.valor = valor;
                return;
            }
        }
        tabela[i].add(new Par(chave, valor));
        tamanho++;
    }
}
Explicação detalhada:
int i = hash(chave): calcula em qual posição da tabela esse par deve viver.for (Par par : tabela[i]): percorre a lista da posiçãoi. Se já existe um par com a mesma chave, basta substituir o valor e sair:par.valor = valor; return;.- Se o laço termina sem encontrar a chave, criamos um novo par e adicionamos no final da lista:
tabela[i].add(new Par(chave, valor)). - Por último, incrementamos o contador
tamanho.
Passo 5: busca
A busca é praticamente uma cópia da inserção, só que sem modificar nada e devolvendo o valor (ou null).
TabelaHash.java
import java.util.LinkedList;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() { /* ... */ }

    private int hash(int chave) { /* ... */ }

    public void inserir(int chave, String valor) { /* ... */ }
    public String buscar(int chave) {
        int i = hash(chave);
        for (Par par : tabela[i]) {
            if (par.chave == chave) {
                return par.valor;
            }
        }
        return null;
    }
}
Explicação: percorremos somente a lista da posição calculada. Se a chave for encontrada, devolvemos o valor; caso contrário, devolvemos null para indicar ausência.
Passo 6: remoção
Para remover, percorremos a lista da posição calculada e retiramos o par cuja chave bate. Como estamos percorrendo e modificando a coleção, usamos um Iterator explícito (ou comparamos antes para usar LinkedList.remove).
TabelaHash.java
import java.util.LinkedList;
import java.util.Iterator;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() { /* ... */ }

    private int hash(int chave) { /* ... */ }

    public void inserir(int chave, String valor) { /* ... */ }

    public String buscar(int chave) { /* ... */ }
    public void remover(int chave) {
        int i = hash(chave);
        Iterator<Par> it = tabela[i].iterator();
        while (it.hasNext()) {
            Par par = it.next();
            if (par.chave == chave) {
                it.remove();
                tamanho--;
                return;
            }
        }
    }
}
Explicação: o Iterator permite remover com segurança o elemento atual da lista enquanto a percorremos (it.remove()). Se a chave não estiver presente, o método simplesmente termina sem alterar nada — comportamento equivalente ao retornar silencioso do pseudocódigo.
8. Java: exibir a tabela e testar tudo junto
Passo 7: um método para exibir a tabela
Para conseguir conferir visualmente o que está acontecendo, adicionamos um método imprimir que mostra todas as posições com suas listas.
TabelaHash.java
public class TabelaHash {
    /* ... atributos, construtor, hash, inserir, buscar, remover ... */
    public void imprimir() {
        for (int i = 0; i < M; i++) {
            System.out.print("[" + i + "] ");
            if (tabela[i].isEmpty()) {
                System.out.println("---");
            } else {
                for (Par par : tabela[i]) {
                    System.out.print("(" + par.chave + ", " + par.valor + ") ");
                }
                System.out.println();
            }
        }
        System.out.println("Tamanho: " + tamanho);
    }
}
Explicação: percorremos cada posição da tabela. Se a lista estiver vazia, mostramos ---. Caso contrário, mostramos cada par no formato (chave, valor).
A classe completa
Juntando todos os passos, a classe TabelaHash fica assim:
TabelaHash.java · versão completa
import java.util.LinkedList;
import java.util.Iterator;

public class TabelaHash {
    private static final int M = 7;
    private LinkedList<Par>[] tabela;
    private int tamanho;

    @SuppressWarnings("unchecked")
    public TabelaHash() {
        this.tabela = new LinkedList[M];
        for (int i = 0; i < M; i++) {
            this.tabela[i] = new LinkedList<>();
        }
        this.tamanho = 0;
    }

    private int hash(int chave) {
        return Math.abs(chave) % M;
    }

    public void inserir(int chave, String valor) {
        int i = hash(chave);
        for (Par par : tabela[i]) {
            if (par.chave == chave) {
                par.valor = valor;
                return;
            }
        }
        tabela[i].add(new Par(chave, valor));
        tamanho++;
    }

    public String buscar(int chave) {
        int i = hash(chave);
        for (Par par : tabela[i]) {
            if (par.chave == chave) {
                return par.valor;
            }
        }
        return null;
    }

    public void remover(int chave) {
        int i = hash(chave);
        Iterator<Par> it = tabela[i].iterator();
        while (it.hasNext()) {
            Par par = it.next();
            if (par.chave == chave) {
                it.remove();
                tamanho--;
                return;
            }
        }
    }

    public void imprimir() {
        for (int i = 0; i < M; i++) {
            System.out.print("[" + i + "] ");
            if (tabela[i].isEmpty()) {
                System.out.println("---");
            } else {
                for (Par par : tabela[i]) {
                    System.out.print("(" + par.chave + ", " + par.valor + ") ");
                }
                System.out.println();
            }
        }
        System.out.println("Tamanho: " + tamanho);
    }
}
Testando tudo junto
Vamos a um programa que reproduz a simulação que fizemos no papel. Crie uma classe Main:
Main.java
public class Main {
    public static void main(String[] args) {
        TabelaHash tabela = new TabelaHash();

        tabela.inserir(10, "A");
        tabela.inserir(17, "B");
        tabela.inserir(3, "C");

        System.out.println("=== Após 3 inserções ===");
        tabela.imprimir();

        tabela.inserir(10, "X"); // atualiza chave existente
        System.out.println("\n=== Após atualizar chave 10 ===");
        tabela.imprimir();

        System.out.println("\nBuscar chave 17: " + tabela.buscar(17));
        System.out.println("Buscar chave 99: " + tabela.buscar(99));

        tabela.remover(17);
        System.out.println("\n=== Após remover chave 17 ===");
        tabela.imprimir();
    }
}
Saída esperada:
=== Após 3 inserções ===
[0] ---
[1] ---
[2] ---
[3] (10, A) (17, B) (3, C)
[4] ---
[5] ---
[6] ---
Tamanho: 3

=== Após atualizar chave 10 ===
[0] ---
[1] ---
[2] ---
[3] (10, X) (17, B) (3, C)
[4] ---
[5] ---
[6] ---
Tamanho: 3

Buscar chave 17: B
Buscar chave 99: null

=== Após remover chave 17 ===
[0] ---
[1] ---
[2] ---
[3] (10, X) (3, C)
[4] ---
[5] ---
[6] ---
Tamanho: 2
Resumo das complexidades
| Operação | Caso médio | Pior caso |
|---|---|---|
| Inserir | $O(1)$ | $O(n)$ |
| Buscar | $O(1)$ | $O(n)$ |
| Remover | $O(1)$ | $O(n)$ |
O pior caso acontece quando todas as chaves colidem na mesma posição — a tabela degenera em uma única lista encadeada. Uma boa função hash, junto com um tamanho $M$ bem escolhido (geralmente um número primo, com a tabela ocupada em torno de 70%), torna esse cenário muito raro na prática.
9. HashMap e LinkedHashMap
Implementar uma tabela hash do zero é um exercício pedagógico essencial. Mas, em projetos reais, raramente reescrevemos essa estrutura: a biblioteca padrão do Java já oferece duas implementações prontas, prontas para uso e altamente otimizadas. As duas principais são HashMap e LinkedHashMap.
HashMap
HashMap<K, V> é a implementação clássica. Internamente, é uma tabela hash com tratamento de colisões (em versões modernas do Java, cada posição é uma lista encadeada que vira árvore vermelha-e-preta quando fica longa demais). As operações put, get e remove têm desempenho médio $O(1)$.
Exemplo de uso de HashMap
import java.util.HashMap;

HashMap<String, Integer> idades = new HashMap<>();
idades.put("ana", 25);
idades.put("bia", 30);
idades.put("caio", 22);

System.out.println(idades.get("bia"));          // 30
System.out.println(idades.containsKey("ana"));  // true
idades.remove("caio");
Característica importante: HashMap não garante ordem alguma ao percorrer as entradas. Se você fizer um for sobre o conjunto de chaves, a ordem pode parecer aleatória e pode até mudar entre execuções.
LinkedHashMap
LinkedHashMap<K, V> é uma extensão de HashMap que, além da tabela hash, mantém uma lista duplamente encadeada ligando as entradas na ordem em que foram inseridas. Isso permite percorrer as entradas previsivelmente, na mesma ordem em que entraram.
Exemplo de uso de LinkedHashMap
import java.util.LinkedHashMap;

LinkedHashMap<String, Integer> idades = new LinkedHashMap<>();
idades.put("ana", 25);
idades.put("bia", 30);
idades.put("caio", 22);

// Imprime SEMPRE nesta ordem: ana, bia, caio
for (String nome : idades.keySet()) {
    System.out.println(nome + ": " + idades.get(nome));
}
O custo dessa lista interna é pequeno (um par de ponteiros por entrada), mas garante a ordem de iteração.
Comparação lado a lado
| Característica | HashMap | LinkedHashMap |
|---|---|---|
| Estrutura interna | Tabela hash | Tabela hash + lista duplamente encadeada |
| Ordem de iteração | Indefinida | Ordem de inserção |
Custo de put/get/remove |
$O(1)$ médio | $O(1)$ médio |
| Memória por entrada | Menor | Maior (2 ponteiros extras) |
Permite chave null? |
Sim (uma só) | Sim (uma só) |
Permite valor null? |
Sim | Sim |
Ideia central
Regra prática: use
HashMapquando a ordem das entradas não importa (e quase nunca importa); useLinkedHashMapapenas quando precisar de previsibilidade ao iterar, ou para implementar caches que respeitem a ordem de inserção/acesso.
10. Exercício resolvido: carrinho de compras
Vamos aplicar os dois mapas em um problema concreto onde ambos são necessários.
Projeto prático: sistema de carrinho de compras
Uma loja virtual precisa de um pequeno sistema que combine duas funcionalidades:
- Catálogo de produtos: milhares de produtos identificados por um código (texto curto). Dado o código, é preciso recuperar o produto rapidamente — sem importar a ordem em que os produtos foram cadastrados.
- Carrinho do cliente: guarda os produtos que o cliente adicionou ao carrinho, junto com a quantidade desejada. Aqui a ordem importa: ao mostrar o carrinho na tela, queremos exibir os itens na ordem em que o cliente os adicionou.
Por que dois mapas diferentes? O catálogo precisa apenas de busca rápida, então
HashMapé ideal. O carrinho precisa preservar a ordem de inserção, e por isso usamosLinkedHashMap.
Solução comentada
1. A classe Produto
Produto.java
public class Produto {
    String codigo;
    String nome;
    double preco;

    public Produto(String codigo, String nome, double preco) {
        this.codigo = codigo;
        this.nome = nome;
        this.preco = preco;
    }

    @Override
    public String toString() {
        return "[" + codigo + "] " + nome + " - R$ " + preco;
    }
}
2. A classe Loja
Loja.java
import java.util.HashMap;
import java.util.LinkedHashMap;
import java.util.Map;

public class Loja {
    // Catálogo: busca rápida por código. Ordem não importa.
    private HashMap<String, Produto> catalogo;

    // Carrinho: codigo -> quantidade. Ordem de inserção importa.
    private LinkedHashMap<String, Integer> carrinho;

    public Loja() {
        this.catalogo = new HashMap<>();
        this.carrinho = new LinkedHashMap<>();
    }

    public void cadastrarProduto(Produto p) {
        catalogo.put(p.codigo, p);
    }

    public void adicionarAoCarrinho(String codigo, int quantidade) {
        if (!catalogo.containsKey(codigo)) {
            System.out.println("Produto " + codigo + " não existe no catálogo.");
            return;
        }
        // Se o produto já está no carrinho, soma a quantidade
        int atual = carrinho.getOrDefault(codigo, 0);
        carrinho.put(codigo, atual + quantidade);
    }

    public void removerDoCarrinho(String codigo) {
        carrinho.remove(codigo);
    }

    public void mostrarCarrinho() {
        System.out.println("=== Seu carrinho ===");
        if (carrinho.isEmpty()) {
            System.out.println("(vazio)");
            return;
        }
        double total = 0.0;
        for (Map.Entry<String, Integer> item : carrinho.entrySet()) {
            String codigo = item.getKey();
            int qtd = item.getValue();
            Produto p = catalogo.get(codigo);
            double subtotal = p.preco * qtd;
            total += subtotal;
            System.out.println(qtd + "x " + p.nome
                + " (R$ " + p.preco + " cada) = R$ " + subtotal);
        }
        System.out.println("TOTAL: R$ " + total);
    }
}
3. A classe Main
Main.java
public class Main {
    public static void main(String[] args) {
        Loja loja = new Loja();

        // Cadastra produtos (a ordem aqui não importa)
        loja.cadastrarProduto(new Produto("P003", "Caderno", 15.90));
        loja.cadastrarProduto(new Produto("P001", "Caneta", 3.50));
        loja.cadastrarProduto(new Produto("P002", "Borracha", 1.20));
        loja.cadastrarProduto(new Produto("P004", "Mochila", 120.00));

        // Cliente adiciona ao carrinho (a ordem AQUI importa)
        loja.adicionarAoCarrinho("P001", 3);   // 3 canetas
        loja.adicionarAoCarrinho("P004", 1);   // 1 mochila
        loja.adicionarAoCarrinho("P002", 2);   // 2 borrachas
        loja.adicionarAoCarrinho("P001", 1);   // mais 1 caneta (agora 4)

        loja.mostrarCarrinho();
    }
}
Saída esperada:
=== Seu carrinho ===
4x Caneta (R$ 3.5 cada) = R$ 14.0
1x Mochila (R$ 120.0 cada) = R$ 120.0
2x Borracha (R$ 1.2 cada) = R$ 2.4
TOTAL: R$ 136.4
O que cada mapa fez?
- O
HashMap(catalogo) deu acesso instantâneo ao produto pelo código, sem se importar com a ordem de cadastro. Trocaríamos por uma lista? Ficaria lento. Por uma ABB? Funcionaria, masHashMapé em média mais rápido. - O
LinkedHashMap(carrinho) preservou a ordem em que o cliente adicionou os produtos: caneta, mochila, borracha. Trocaríamos porHashMap? A ordem se perderia, podendo aparecer mochila, caneta, borracha em uma execução, e caneta, borracha, mochila em outra — ruim para a experiência do usuário. - Note ainda o detalhe da terceira chamada de
adicionarAoCarrinho("P001", 1): ela atualiza a quantidade da chaveP001para 4, sem mover o produto para o final. EmLinkedHashMap, atualizar o valor de uma chave existente não muda sua posição na ordem de iteração.
11. Exercícios propostos
Agora é sua vez. Os dois exercícios a seguir treinam a operação direta com tabelas hash do Java, e o projeto exige um pouco mais de planejamento.
Exercício 1: contador de palavras
Enunciado: Escreva um programa que receba uma frase do usuário e mostre quantas vezes cada palavra aparece. Por exemplo, dada a frase:
"a casa e a janela e a porta"
o programa deve imprimir (a ordem das linhas não importa):
a: 3
casa: 1
e: 2
janela: 1
porta: 1
Dicas:
- Use
frase.split(" ")para separar as palavras. - Use um
HashMap<String, Integer>para guardar (palavra, contagem). - Para cada palavra, recupere a contagem atual com
getOrDefault(palavra, 0)e some 1.
Exercício 2: histórico de comandos
Enunciado: Implemente um pequeno shell que registra todos os comandos digitados pelo usuário. O programa deve:
- Ler comandos do usuário em um laço, até que ele digite
sair. - Cada comando que não for
sairé adicionado ao histórico e contado: o mesmo comando pode ser digitado várias vezes. - Quando o usuário digita
historico, o programa deve listar os comandos na ordem em que foram digitados pela primeira vez, mostrando ao lado quantas vezes cada um foi usado.
Exemplo de sessão:
> ls
> cd projetos
> ls
> ls
> historico
ls: 3
cd projetos: 1
> sair
Por que LinkedHashMap? Porque você precisa manter a ordem de inserção (o comando ls foi o primeiro a ser digitado) e ter acesso rápido para incrementar o contador a cada repetição.
Projeto: sistema de check-in de um evento
Projeto prático: check-in de participantes
Você precisa construir um sistema de check-in para um evento. Cada participante tem um CPF (texto, identificador único) e um nome. O sistema deve oferecer:
cadastrarParticipante(cpf, nome): registra um novo participante.fazerCheckin(cpf): marca a chegada do participante. Se o CPF não estiver cadastrado, mostrar mensagem de erro. Se o participante já tiver feito check-in, avisar.listarPresentesEmOrdem(): imprime os participantes que já fizeram check-in, na ordem em que chegaram (do primeiro ao último).buscarParticipante(cpf): devolve o nome do participante (ounull).quantosPresentes(): devolve quantos já fizeram check-in.
Sua tarefa:
- Criar a classe
Participantecom os atributoscpfenomee umtoStringapropriado. - Criar a classe
Eventocom dois mapas:- um
HashMap<String, Participante>para o cadastro completo (busca rápida por CPF); - um
LinkedHashMap<String, Participante>apenas para os presentes (para preservar a ordem de chegada).
- um
- Implementar os cinco métodos acima.
- Criar uma classe
Mainque cadastre pelo menos 5 participantes, faça check-in de 3 deles em uma ordem específica e demonstre todas as operações.
Para ir além:
- Adicionar um método
cancelarCheckin(cpf)que retira o participante da lista de presentes. - Adicionar um método
listarAusentes()que mostra quem está cadastrado mas ainda não chegou. Dica: percorra o catálogo e verifique a presença noLinkedHashMap. - Em vez de armazenar apenas o nome, registrar também o horário do check-in.
12. Encerramento
Ideia central
A tabela hash troca memória por velocidade: reserva um vetor grande o suficiente para que cada chave caia em uma posição quase exclusiva e usa uma função aritmética simples para encontrá-la. Por trás de operadores aparentemente mágicos como
m["chave"]em qualquer linguagem moderna, existe uma tabela hash — a mesma estrutura que você acabou de implementar.
Parabéns! Você entendeu a função hash e o tratamento de colisões por encadeamento separado, implementou uma tabela hash completa em Java e aprendeu quando usar HashMap e LinkedHashMap.