Merge Sort: análise de complexidade
Estude o Merge Sort no estilo CLRS: o paradigma dividir para conquistar, o procedimento Merge com sentinelas, sua prova de corretude, a recorrência T(n) = 2T(n/2) + Θ(n) resolvida pela árvore de recorrência e a implementação em Java.
1. Visão geral
Neste codelab você estuda o Merge Sort seguindo a abordagem do CLRS (Cormen et al., Introduction to Algorithms): do paradigma dividir para conquistar à implementação em Java, passando pela análise linha a linha, pela prova de corretude e pela solução da recorrência.
O que você vai aprender
- A diferença entre a abordagem incremental (Insertion Sort) e a abordagem dividir para conquistar (Merge Sort)
- As três fases do paradigma: dividir, conquistar e combinar
- O procedimento Merge com sentinelas $\infty$, sua análise linha a linha e sua prova de corretude por invariante de laço
- A recorrência $T(n) = 2T(n/2) + \Theta(n)$ e sua solução pela árvore de recorrência
- Por que o Merge Sort é $\Theta(n \lg n)$ em todos os casos
- Uma implementação completa do Merge Sort em Java
O que você vai precisar
- Um JDK instalado (
javacejava) - Conhecimento das notações $O$, $\Omega$ e $\Theta$ e do Insertion Sort
2. Design de algoritmos
Ao projetar um algoritmo, a primeira decisão é a estratégia: como o problema será decomposto e resolvido. O CLRS apresenta duas abordagens fundamentais usando a ordenação como exemplo.
Abordagem incremental: Insertion Sort
O Insertion Sort resolve o problema incrementalmente: a cada passo, um novo elemento é inserido na posição correta dentro de um subarranjo já ordenado. O subarranjo ordenado cresce um elemento por vez, do índice 1 até $n$.
Esta abordagem tem custo $\Theta(n^2)$ no pior caso — cada novo elemento pode precisar percorrer todos os anteriores — mas é ótima para entradas pequenas (tipicamente $n < 50$) devido a constantes multiplicativas pequenas e ausência de overhead de recursão.
Abordagem dividir para conquistar: Merge Sort
O Merge Sort adota uma estratégia radicalmente diferente: em vez de crescer incrementalmente, ele divide o problema ao meio, resolve cada metade recursivamente e combina os resultados. Esse paradigma — chamado dividir para conquistar — leva a um custo $\Theta(n \lg n)$ garantido em todos os casos, uma melhoria assintótica significativa em relação ao Insertion Sort para entradas grandes.
3. Dividir para conquistar
O paradigma dividir para conquistar é baseado em recursão: o procedimento chama a si mesmo com uma instância menor do mesmo problema, até atingir um caso base que pode ser resolvido diretamente.
Para ilustrar a ideia antes de entrar no Merge Sort, considere o problema de somar os inteiros de 1 a $n$. Uma solução recursiva natural é:
Algoritmo 1: SOMA-RECURSIVA(n)
1  se n = 1 então
2      retorne 1                          // caso base
3  fim
4  retorne n + SOMA-RECURSIVA(n - 1)      // passo recursivo
Ao chamar SOMA-RECURSIVA(10), o procedimento expande:
$10 + \text{Soma-Recursiva}(9) = 10 + 9 + \text{Soma-Recursiva}(8) = \cdots = 10 + 9 + 8 + \cdots + 1 = 55$
A recursão para quando $n = 1$ (caso base), e os resultados são combinados na volta da pilha de chamadas.
A recorrência que descreve o tempo de execução é:
$T(n) = \begin{cases} \Theta(1) & \text{se } n = 1 \ T(n-1) + \Theta(1) & \text{se } n > 1 \end{cases}$
Expandindo: $T(n) = T(n-1) + c = T(n-2) + 2c = \cdots = T(1) + (n-1)c = \Theta(n)$. Ou seja, a soma recursiva tem custo linear.
As três fases do paradigma
Todo algoritmo dividir-para-conquistar opera em três fases em cada nível da recursão:
- Dividir. Divide o problema em dois ou mais subproblemas menores que são instâncias do mesmo problema original. Se o tamanho já for suficientemente pequeno, resolve diretamente (caso base) sem dividir.
- Conquistar. Resolve os subproblemas recursivamente. Cada chamada recursiva aplica as mesmas três fases, até chegar ao caso base.
- Combinar. Combina as soluções dos subproblemas para obter a solução do problema original. Esta é frequentemente a fase com mais trabalho.
O algoritmo Merge Sort
O Merge Sort aplica o paradigma dividir-para-conquistar ao problema de ordenação. Para ordenar um subarranjo $A[p..r]$, ele opera em três fases:
- Dividir. Calcula o índice do meio $q = \lfloor (p + r)/2 \rfloor$ e divide $A[p..r]$ em dois subarranjos de tamanhos aproximadamente iguais: $A[p..q]$ e $A[q+1..r]$.
- Conquistar. Ordena recursivamente $A[p..q]$ e $A[q+1..r]$ por meio de chamadas recursivas ao próprio Merge Sort. O caso base ocorre quando $p \geq r$: um subarranjo de tamanho 1 está trivialmente ordenado.
- Combinar. Chama o procedimento auxiliar MERGE$(A, p, q, r)$ que intercala os dois subarranjos ordenados $A[p..q]$ e $A[q+1..r]$, produzindo o subarranjo ordenado $A[p..r]$.
A ideia central é que intercalar dois subarranjos já ordenados é muito mais fácil do que ordenar o arranjo inteiro de uma vez. Esse trabalho de combinação é feito pelo MERGE, descrito a seguir.
4. O procedimento Merge
O procedimento MERGE$(A, p, q, r)$ recebe um arranjo $A$ e índices $p \leq q < r$ tais que os subarranjos $A[p..q]$ e $A[q+1..r]$ já estão ordenados, e os intercala produzindo o subarranjo ordenado $A[p..r]$.
A ideia é análoga à intercalação de dois baralhos de cartas ordenados: compara-se a carta do topo de cada pilha e a menor é colocada na saída, repetindo até esvaziar ambas. O CLRS usa um artifício elegante: coloca uma sentinela $\infty$ ao final de cada subarranjo auxiliar, eliminando a necessidade de verificar qual pilha foi esgotada primeiro.
Algoritmo 2: MERGE(A, p, q, r)
 1  n1 ← q - p + 1;
 2  n2 ← r - q;
 3  seja L[1..n1+1] e R[1..n2+1] novos arranjos;
 4  para i ← 1 até n1 faça
 5      L[i] ← A[p + i - 1];
 6  fim
 7  para j ← 1 até n2 faça
 8      R[j] ← A[q + j];
 9  fim
10  L[n1 + 1] ← ∞;                    // sentinela
11  R[n2 + 1] ← ∞;                    // sentinela
12  i ← 1;
13  j ← 1;
14  para k ← p até r faça
15      se L[i] ≤ R[j] então
16          A[k] ← L[i];
17          i ← i + 1;
18      fim
19      senão
20          A[k] ← R[j];
21          j ← j + 1;
22      fim
23  fim
Análise linha a linha do Merge
Seja $n = r - p + 1$ o tamanho do subarranjo, com $n_1 + n_2 = n$. Denotamos por $\tau$ ($0 \leq \tau \leq n$) o número de vezes que a condição $L[i] \leq R[j]$ é verdadeira (depende da entrada).
| Linha | Trecho | Custo | Execuções |
|---|---|---|---|
| 1 | $n_1 \leftarrow q - p + 1$ | $c_1$ | $1$ |
| 2 | $n_2 \leftarrow r - q$ | $c_2$ | $1$ |
| 3 | criar $L$, $R$ | $c_3$ | $1$ |
| 4 | para $i \leftarrow 1$ até $n_1$ (teste) | $c_4$ | $n_1 + 1$ |
| 5 | $L[i] \leftarrow A[p + i - 1]$ | $c_5$ | $n_1$ |
| 6 | para $j \leftarrow 1$ até $n_2$ (teste) | $c_6$ | $n_2 + 1$ |
| 7 | $R[j] \leftarrow A[q + j]$ | $c_7$ | $n_2$ |
| 8 | $L[n_1+1] \leftarrow \infty$ | $c_8$ | $1$ |
| 9 | $R[n_2+1] \leftarrow \infty$ | $c_9$ | $1$ |
| 10 | $i \leftarrow 1$ | $c_{10}$ | $1$ |
| 11 | $j \leftarrow 1$ | $c_{11}$ | $1$ |
| 12 | para $k \leftarrow p$ até $r$ (teste) | $c_{12}$ | $n + 1$ |
| 13 | se $L[i] \leq R[j]$ | $c_{13}$ | $n$ |
| 14 | $A[k] \leftarrow L[i]$ | $c_{14}$ | $\tau$ |
| 15 | $i \leftarrow i + 1$ | $c_{15}$ | $\tau$ |
| 16 | $A[k] \leftarrow R[j]$ | $c_{16}$ | $n - \tau$ |
| 17 | $j \leftarrow j + 1$ | $c_{17}$ | $n - \tau$ |
O tempo total é:
$\begin{aligned} T_{\text{Merge}}(n) = {} & c_1 + c_2 + c_3 + c_4(n_1+1) + c_5 n_1 + c_6(n_2+1) + c_7 n_2 + c_8 + c_9 + c_{10} + c_{11} \ & + c_{12}(n+1) + c_{13} n + (c_{14} + c_{15})\tau + (c_{16} + c_{17})(n - \tau) \end{aligned}$
Como $n_1 + n_2 = n$ e todos os $c_i$ são constantes positivas, a expressão simplifica-se para $an + b$ (onde $a$ e $b$ dependem apenas dos $c_i$, e não de $\tau$). Portanto:
$T_{\text{Merge}}(n) = \Theta(n)$
O procedimento MERGE é linear no tamanho do subarranjo.
5. Simulação do Merge
Ilustramos o MERGE na intercalação final do Merge Sort sobre o vetor $A = [38, 27, 43, 3, 9, 82, 10, 5]$ de tamanho 8.
Após as chamadas recursivas, as duas metades já estão ordenadas:
$A[1..4] = [3, 27, 38, 43] \qquad A[5..8] = [5, 9, 10, 82]$
Os arranjos auxiliares são $L = [3, 27, 38, 43, \infty]$ e $R = [5, 9, 10, 82, \infty]$.
Cada passo mostra: estado dos vetores $L$ e $R$ com ponteiros $i$ e $j$, a comparação feita, e o elemento copiado para $A[k]$. Na figura, verde indica o ponteiro ativo, cinza indica elemento já copiado e verde em $A$ indica o elemento recém-escrito.
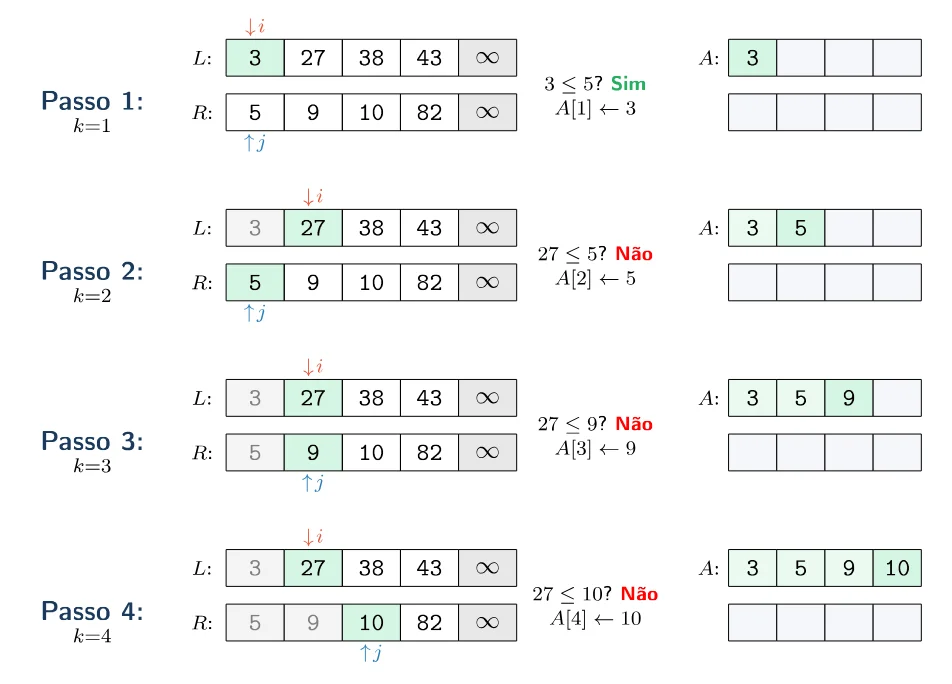
Passos 1 a 4 ($k = 1$ a $k = 4$).
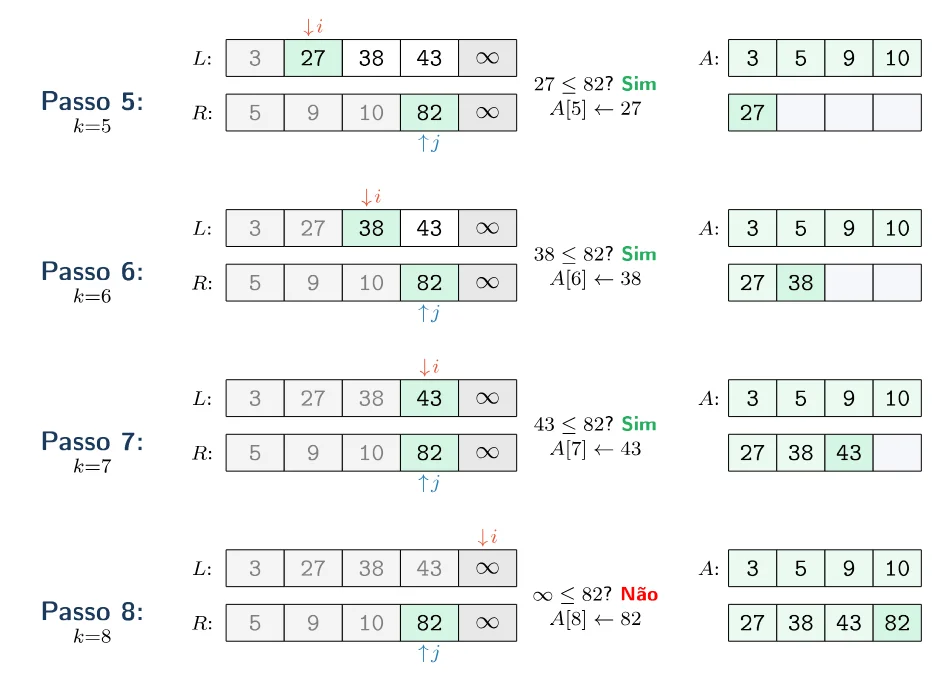
Passos 5 a 8 ($k = 5$ a $k = 8$).
| Passo | $k$ | Comparação | Resultado | Cópia |
|---|---|---|---|---|
| 1 | 1 | $3 \leq 5$? | Sim | $A[1] \leftarrow 3$ |
| 2 | 2 | $27 \leq 5$? | Não | $A[2] \leftarrow 5$ |
| 3 | 3 | $27 \leq 9$? | Não | $A[3] \leftarrow 9$ |
| 4 | 4 | $27 \leq 10$? | Não | $A[4] \leftarrow 10$ |
| 5 | 5 | $27 \leq 82$? | Sim | $A[5] \leftarrow 27$ |
| 6 | 6 | $38 \leq 82$? | Sim | $A[6] \leftarrow 38$ |
| 7 | 7 | $43 \leq 82$? | Sim | $A[7] \leftarrow 43$ |
| 8 | 8 | $\infty \leq 82$? | Não | $A[8] \leftarrow 82$ |
6. Corretude: invariante de laço do Merge
Provaremos a corretude do MERGE por meio de um invariante de laço para o laço para das linhas 12–17.
Invariante
No início de cada iteração do laço indexado por $k$, o subarranjo $A[p..k-1]$ contém os $k - p$ menores elementos de $L[1..n_1+1]$ e $R[1..n_2+1]$, em ordem classificada. Além disso, $L[i]$ e $R[j]$ são os menores elementos de seus respectivos arranjos que ainda não foram copiados de volta para $A$.
Inicialização
Antes da primeira iteração, $k = p$, de modo que $A[p..k-1] = A[p..p-1]$ é vazio. Um conjunto vazio trivialmente contém os 0 menores elementos. Os ponteiros $i = j = 1$ apontam para os menores elementos de $L$ e $R$. O invariante é satisfeito.
Manutenção
Suponha o invariante verdadeiro no início de uma iteração. Tratamos dois casos:
- Caso $L[i] \leq R[j]$: $L[i]$ é o menor elemento ainda não copiado. Após $A[k] \leftarrow L[i]$ e $i \leftarrow i + 1$, o subarranjo $A[p..k]$ contém os $k - p + 1$ menores elementos em ordem, e os novos $L[i]$ e $R[j]$ são os próximos candidatos.
- Caso $L[i] > R[j]$: Argumento simétrico com $R[j]$.
O invariante é mantido após cada iteração.
Término
O laço termina quando $k = r + 1$. Pelo invariante, $A[p..r]$ contém os $r - p + 1 = n$ menores elementos de $L$ e $R$ em ordem. Como $L$ e $R$ contêm juntos exatamente $n$ elementos reais mais as sentinelas $\infty$, o subarranjo $A[p..r]$ está completamente ordenado. $\square$
7. O procedimento Merge-Sort
Com o MERGE estabelecido, o procedimento principal é direto. A chamada inicial é MERGE-SORT$(A, 1, n)$.
Algoritmo 3: MERGE-SORT(A, p, r)
1  se p < r então
2      q ← ⌊(p + r)/2⌋;               // divide
3      MERGE-SORT(A, p, q);           // conquista: metade esquerda
4      MERGE-SORT(A, q + 1, r);       // conquista: metade direita
5      MERGE(A, p, q, r);             // combina
6  fim
O algoritmo divide o problema ao meio (linha 2), resolve recursivamente cada metade (linhas 3–4) e combina as soluções (linha 5). Quando $p \geq r$, o subarranjo tem tamanho 1 e está trivialmente ordenado: a recursão para.
Análise linha a linha do Merge-Sort
Considere a chamada MERGE-SORT$(A, p, r)$ com $n = r - p + 1$ elementos.
| Linha | Pseudocódigo | Custo | Vezes |
|---|---|---|---|
| 1 | se $p < r$ | $c_1$ | $1$ |
| 2 | $q \leftarrow \lfloor (p + r)/2 \rfloor$ | $c_2$ | $1$ |
| 3 | MERGE-SORT$(A, p, q)$ | $T(n/2)$ | $1$ |
| 4 | MERGE-SORT$(A, q+1, r)$ | $T(n/2)$ | $1$ |
| 5 | MERGE$(A, p, q, r)$ | $\Theta(n)$ | $1$ |
A partir da tabela acima, obtemos diretamente a recorrência do Merge Sort (apresentada no próximo passo).
Árvore de chamadas recursivas
A figura abaixo mostra as chamadas recursivas do MERGE-SORT sobre $A = [38, 27, 43, 3, 9, 82, 10, 5]$, um vetor de tamanho 8. A parte superior (setas para baixo) representa a fase de divisão; a parte inferior (continuando para baixo, após a linha tracejada) mostra a fase de conquista, em que os vetores vão sendo ordenados pelo MERGE.
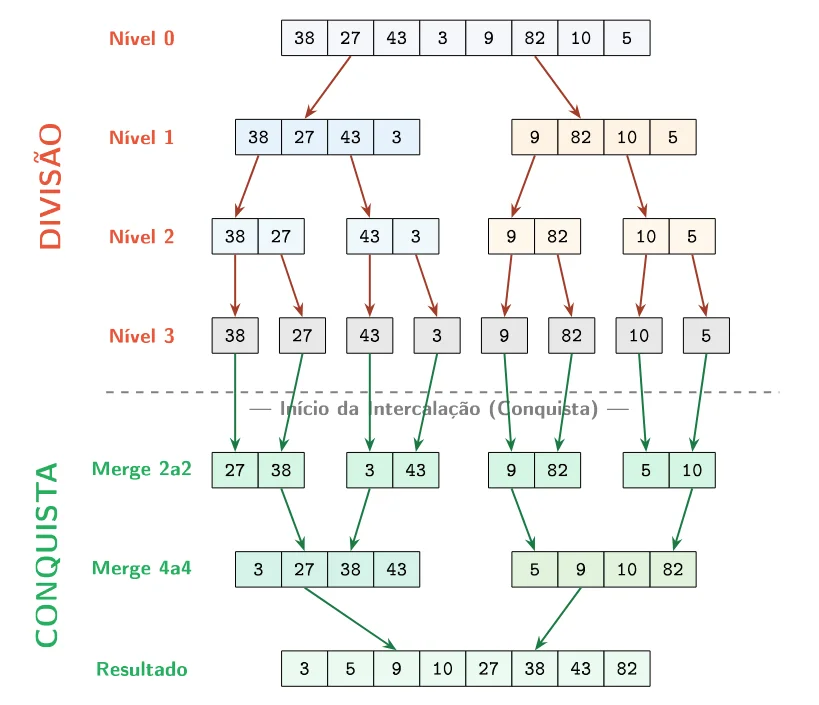
Setas laranjas = chamadas recursivas (divisão). Setas verdes = retorno ordenado (intercalação).
8. Recorrência do Merge-Sort
Para expressar $T(n)$, o tempo de execução do Merge-Sort, identificamos o custo de cada fase para $n = 2^k$:
| Fase | Custo | Justificativa |
|---|---|---|
| Caso base | $\Theta(1)$ | Subarranjo de tamanho 1, trivialmente ordenado |
| Dividir | $\Theta(1)$ | Apenas o cálculo de $q = \lfloor (p + r)/2 \rfloor$ |
| Conquistar | $2T(n/2)$ | Duas chamadas recursivas em $n/2$ elementos cada |
| Combinar | $\Theta(n)$ | Procedimento MERGE é linear |
Recorrência do Merge-Sort
$T(n) = \begin{cases} \Theta(1) & \text{se } n = 1 \ 2T(n/2) + \Theta(n) & \text{se } n = 2^k, k \geq 1 \end{cases}$
Métodos para resolver recorrências
Uma recorrência como $T(n) = 2T(n/2) + \Theta(n)$ pode ser resolvida por diferentes métodos, cada um com suas vantagens:
- Árvore de recorrência. Expande visualmente a recorrência em níveis, calcula o custo por nível e soma. É intuitivo e útil para adivinhar a solução antes de prová-la. Apresentado no próximo passo.
- Método da substituição. Propõe uma solução e a prova por indução matemática. Requer que já se suspeite da forma correta da solução.
- Teorema Mestre. Fornece uma fórmula fechada para recorrências da forma $T(n) = aT(n/b) + f(n)$, cobrindo a maioria dos casos práticos com um simples enquadramento em um dos três casos do teorema.
Neste material, utilizaremos a árvore de recorrência, que é a abordagem mais visual e diretamente ligada à estrutura do algoritmo.
Resumo da complexidade assintótica
| Caso | Condição de entrada | $T(n)$ | Notação |
|---|---|---|---|
| Melhor | Qualquer (não depende da ordem) | $cn \lg n + cn$ | $\Theta(n \lg n)$ |
| Pior | Qualquer (mesmo resultado) | $cn \lg n + cn$ | $\Theta(n \lg n)$ |
| Médio | Qualquer (mesmo resultado) | $cn \lg n + cn$ | $\Theta(n \lg n)$ |
A propriedade mais importante do Merge Sort é sua regularidade: ao contrário do Insertion Sort, cujo custo varia entre $\Theta(n)$ (melhor caso) e $\Theta(n^2)$ (pior caso), o Merge Sort mantém $\Theta(n \lg n)$ em qualquer situação. O preço é o uso de $\Theta(n)$ de memória auxiliar. O Merge Sort é também estável: preserva a ordem relativa de elementos iguais.
9. Árvore de recorrência do Merge-Sort
A árvore de recorrência é obtida expandindo $T(n) = 2T(n/2) + cn$ sucessivamente. Usamos a constante $c > 0$ para absorver os termos $\Theta$. Para $n = 8$ ($\lg 8 = 3$ níveis):
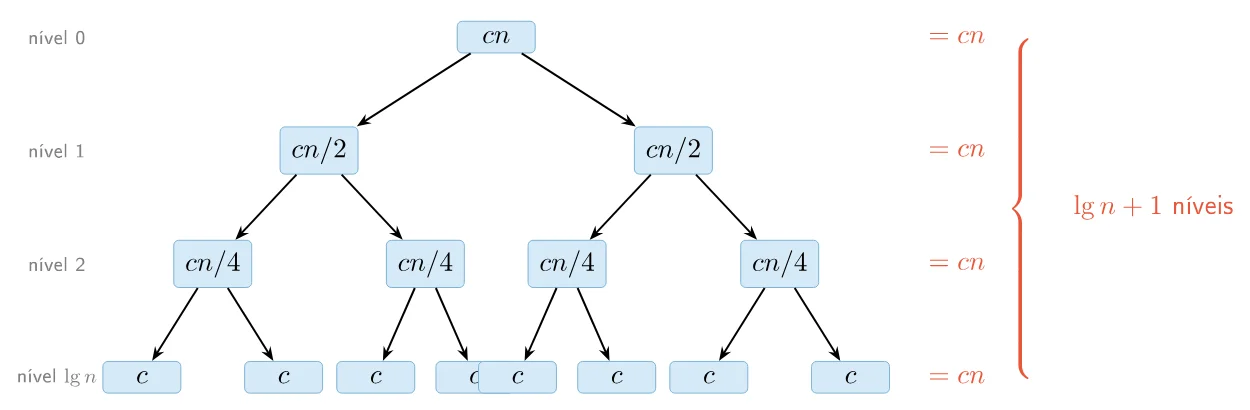
Cada nível da árvore custa $cn$, e a árvore tem $\lg n + 1$ níveis.
Por que o custo por nível é sempre $cn$?
Ao descer um nível, o número de subproblemas dobra (fator 2), mas o tamanho de cada um cai pela metade (fator $\frac{1}{2}$). Os dois efeitos se cancelam: $2^i \cdot c(n/2^i) = cn$ para todo nível $i$.
A árvore possui $\lg n + 1$ níveis (níveis $0, 1, \ldots, \lg n$). Os primeiros $\lg n$ níveis custam $cn$ cada; o último (caso base) custa $\Theta(n)$ no total ($n$ subproblemas de tamanho 1). Portanto:
$T(n) = cn \lg n + cn$
Prova formal
Mostramos que $cn \lg n + cn = \Theta(n \lg n)$.
Cota superior. Para $n \geq 2$, tem-se $\lg n \geq 1$, logo $n \leq n \lg n$. Portanto: $cn \lg n + cn \leq cn \lg n + cn \lg n = 2cn \lg n$. Escolhendo $c_2 = 2c$ e $n_0 = 2$, a cota superior está estabelecida.
Cota inferior. Como $cn > 0$: $cn \lg n + cn \geq cn \lg n$. Escolhendo $c_1 = c$ e $n_0 = 1$, a cota inferior está estabelecida.
Para todo $n \geq n_0 = 2$:
$cn \lg n ;\leq; cn \lg n + cn ;\leq; 2cn \lg n$
Portanto, pela definição de $\Theta$:
$\boxed{T(n) = cn \lg n + cn = \Theta(n \lg n)}$
10. Implementação em Java
A seguir, apresentamos uma implementação completa do Merge Sort em Java, fiel ao pseudocódigo do CLRS. A implementação inclui o procedimento principal mergeSort e o procedimento auxiliar merge, além de um método main para teste.
MergeSort.java
public class MergeSort {

    /**
     * Procedimento principal: ordena A[p..r] recursivamente.
     * Corresponde ao Algoritmo 3 (MERGE-SORT) do pseudocodigo.
     *
     * @param A vetor a ser ordenado
     * @param p indice inicial (inclusive), base 0
     * @param r indice final (inclusive), base 0
     */
    public static void mergeSort(int[] A, int p, int r) {
        if (p < r) {
            int q = (p + r) / 2;        // divide
            mergeSort(A, p, q);         // conquista: metade esquerda
            mergeSort(A, q + 1, r);     // conquista: metade direita
            merge(A, p, q, r);          // combina
        }
    }

    /**
     * Procedimento de intercalacao: intercala A[p..q] e A[q+1..r].
     * Corresponde ao Algoritmo 2 (MERGE) do pseudocodigo.
     * Usa sentinela Integer.MAX_VALUE no lugar de infinito.
     *
     * @param A vetor
     * @param p indice inicial do primeiro subarranjo
     * @param q indice final do primeiro subarranjo
     * @param r indice final do segundo subarranjo
     */
    public static void merge(int[] A, int p, int q, int r) {
        int n1 = q - p + 1;    // tamanho da metade esquerda
        int n2 = r - q;        // tamanho da metade direita

        // Cria arranjos auxiliares com espaco para sentinela
        int[] L = new int[n1 + 1];
        int[] R = new int[n2 + 1];

        // Copia metade esquerda para L
        for (int i = 0; i < n1; i++) {
            L[i] = A[p + i];
        }
        // Copia metade direita para R
        for (int j = 0; j < n2; j++) {
            R[j] = A[q + 1 + j];
        }

        // Sentinelas
        L[n1] = Integer.MAX_VALUE;
        R[n2] = Integer.MAX_VALUE;

        // Intercalacao
        int i = 0, j = 0;
        for (int k = p; k <= r; k++) {
            if (L[i] <= R[j]) {
                A[k] = L[i];
                i++;
            } else {
                A[k] = R[j];
                j++;
            }
        }
    }

    /** Metodo auxiliar para imprimir o vetor. */
    public static void imprimirVetor(int[] A) {
        System.out.print("[");
        for (int i = 0; i < A.length; i++) {
            System.out.print(A[i]);
            if (i < A.length - 1) System.out.print(", ");
        }
        System.out.println("]");
    }

    /** Metodo principal para teste. */
    public static void main(String[] args) {
        int[] A = {38, 27, 43, 3, 9, 82, 10, 5};

        System.out.println("Vetor original:");
        imprimirVetor(A);

        mergeSort(A, 0, A.length - 1);

        System.out.println("Vetor ordenado:");
        imprimirVetor(A);
    }
}
Observações sobre a implementação
Diferenças entre pseudocódigo e Java
- Indexação: O pseudocódigo do CLRS usa índices começando em 1; em Java, arrays começam em 0. A lógica é a mesma, apenas ajustamos os índices de cópia no
merge. - Sentinela: Usamos
Integer.MAX_VALUE($2^{31} - 1$) no lugar de $\infty$. Funciona corretamente desde que o vetor não contenha esse valor. - Divisão inteira: A expressão
(p + r) / 2em Java já realiza divisão inteira (equivalente a $\lfloor (p + r)/2 \rfloor$). - Complexidade: A implementação mantém as mesmas garantias assintóticas do pseudocódigo: $\Theta(n \lg n)$ de tempo e $\Theta(n)$ de espaço auxiliar.
Saída esperada
Vetor original:
[38, 27, 43, 3, 9, 82, 10, 5]
Vetor ordenado:
[3, 5, 9, 10, 27, 38, 43, 82]
11. Exercícios
Exercícios teóricos
Exercício 1 — Análise de complexidade linha a linha
Considere o procedimento MERGE$(A, p, q, r)$ aplicado à intercalação final do Merge Sort sobre o vetor $A = [38, 27, 43, 3, 9, 82, 10, 5]$ de tamanho 8. Após as chamadas recursivas, as duas metades já estão ordenadas:
$A[1..4] = [3, 27, 38, 43] \qquad A[5..8] = [5, 9, 10, 82]$
Os arranjos auxiliares são $L = [3, 27, 38, 43, \infty]$ e $R = [5, 9, 10, 82, \infty]$.
a) Realize a análise linha a linha do tempo de execução do procedimento MERGE para essa intercalação, preenchendo a tabela abaixo. Indique o valor de $\tau$ (número de vezes que a condição $L[i] \leq R[j]$ é verdadeira).
| Linha | Trecho | Custo | Execuções |
|---|---|---|---|
| 1 | $n_1 \leftarrow q - p + 1$ | $c_1$ | |
| 2 | $n_2 \leftarrow r - q$ | $c_2$ | |
| 3 | criar $L$, $R$ | $c_3$ | |
| 4 | para $i \leftarrow 1$ até $n_1$ (teste) | $c_4$ | |
| 5 | $L[i] \leftarrow A[p + i - 1]$ | $c_5$ | |
| 6 | para $j \leftarrow 1$ até $n_2$ (teste) | $c_6$ | |
| 7 | $R[j] \leftarrow A[q + j]$ | $c_7$ | |
| 8 | $L[n_1+1] \leftarrow \infty$ | $c_8$ | |
| 9 | $R[n_2+1] \leftarrow \infty$ | $c_9$ | |
| 10 | $i \leftarrow 1$; $j \leftarrow 1$ | $c_{10}$ | |
| 12 | para $k \leftarrow p$ até $r$ (teste) | $c_{12}$ | |
| 13 | se $L[i] \leq R[j]$ | $c_{13}$ | |
| 14 | $A[k] \leftarrow L[i]$; $i \leftarrow i + 1$ | $c_{14}$ | |
| 16 | $A[k] \leftarrow R[j]$; $j \leftarrow j + 1$ | $c_{16}$ |
b) Com base na tabela preenchida, calcule $T_{\text{Merge}}(n)$ em função das constantes $c_i$ e mostre que $T_{\text{Merge}}(n) = \Theta(n)$.
c) Explique por que, diferentemente do Insertion Sort, o custo do MERGE não depende da ordem inicial dos elementos. Qual é a relação entre o valor de $\tau$ e o resultado final?
Exercício 2 — Recorrência e árvore de recorrência
Considere a recorrência do Merge Sort:
$T(n) = \begin{cases} \Theta(1) & \text{se } n = 1 \ 2T(n/2) + \Theta(n) & \text{se } n > 1 \end{cases}$
a) Desenhe a árvore de recorrência para $n = 16$, indicando: o custo de cada nó, o custo total de cada nível e o número total de níveis.
b) Usando a árvore desenhada, mostre que $T(n) = cn \lg n + cn$.
c) Prove formalmente que $cn \lg n + cn = \Theta(n \lg n)$, encontrando constantes $c_1$, $c_2$ e $n_0$ tais que $c_1 n \lg n \leq cn \lg n + cn \leq c_2 n \lg n$ para todo $n \geq n_0$.
Exercícios práticos
Exercício 3 — Implementação com contagem de operações
Implemente em Java uma classe MergeSortContador que realize a ordenação de um arranjo de inteiros utilizando o Merge Sort e, além de ordenar, conte o número total de comparações (testes $L[i] \leq R[j]$) e o número total de cópias (escritas em $A[k]$) realizados pelo procedimento MERGE.
O programa deve:
- Ler um número inteiro positivo $n$ do teclado.
- Preencher um vetor de tamanho $n$ com valores aleatórios entre 1 e 1000.
- Exibir o vetor antes da ordenação.
- Executar o Merge Sort, contando comparações e cópias.
- Exibir o vetor após a ordenação, o número de comparações e o número de cópias.
Em seguida, execute o programa para os seguintes cenários e compare os resultados:
- $n = 8$ com vetor já ordenado em ordem crescente.
- $n = 8$ com vetor em ordem decrescente.
- $n = 8$ com vetor aleatório.
Após a implementação, responda: o número de comparações muda significativamente entre os três cenários? Por quê?
Exemplo de entrada e saída:
Entrada: $n = 8$, vetor gerado: [38, 27, 43, 3, 9, 82, 10, 5]
Saída:
Antes: [38, 27, 43, 3, 9, 82, 10, 5]
Depois: [3, 5, 9, 10, 27, 38, 43, 82]
Comparações: 17
Cópias: 24
Exercício 4 — Merge Sort com contagem de inversões
Uma inversão em um arranjo $A$ é um par de índices $(i, j)$ com $i < j$ e $A[i] > A[j]$. O número de inversões mede o grau de desordem de um arranjo.
Implemente em Java uma classe ContadorInversoes que utilize uma adaptação do Merge Sort para contar o número total de inversões em um arranjo de inteiros. A ideia é que, durante o procedimento MERGE, sempre que um elemento de $R$ é copiado para $A[k]$ antes de todos os elementos restantes de $L$, isso indica que esse elemento de $R$ forma inversões com todos os elementos restantes de $L$.
O programa deve:
- Ler um número inteiro positivo $n$ do teclado.
- Preencher um vetor de tamanho $n$ com valores aleatórios entre 1 e 100.
- Exibir o vetor original.
- Executar o Merge Sort modificado, contando inversões.
- Exibir o vetor ordenado e o número total de inversões.
Exemplo de entrada e saída:
Entrada: $n = 5$, vetor: [5, 3, 8, 1, 2]
Saída:
Vetor original: [5, 3, 8, 1, 2]
Vetor ordenado: [1, 2, 3, 5, 8]
Número de inversões: 7
Após a implementação, responda: qual é a complexidade dessa solução? Compare com a abordagem ingenuamente quadrática de verificar todos os pares $(i, j)$.
12. Encerramento
Parabéns! Você estudou o paradigma dividir para conquistar, analisou o MERGE linha a linha, provou sua corretude, resolveu a recorrência do Merge Sort pela árvore de recorrência e implementou o algoritmo em Java, garantindo $\Theta(n \lg n)$ em todos os casos.
Referências
- CORMEN, Thomas H.; LEISERSON, Charles E.; RIVEST, Ronald L.; STEIN, Clifford. Introduction to Algorithms. 4. edição. MIT Press, 2022. Capítulo 2: Getting Started; Capítulo 4: Divide-and-Conquer.