Busca em largura e busca em profundidade
Estude a busca em largura (BFS) e a busca em profundidade (DFS) no estilo CLRS, com o esquema de cores, simulações passo a passo, pseudocódigo, análise Θ(|V| + |E|) e implementações iterativas e recursivas em Java.
1. Visão geral
Em muitos problemas computacionais é preciso visitar, de forma sistemática, todos os vértices de um grafo a partir de um vértice de partida, descobrindo quais são alcançáveis e em que ordem podem ser alcançados. As estratégias clássicas para essa tarefa são duas: a busca em largura (Breadth-First Search, ou BFS) e a busca em profundidade (Depth-First Search, ou DFS).
Embora ambas tenham o mesmo objetivo — percorrer um grafo de modo a visitar cada vértice alcançável a partir de uma origem — elas diferem radicalmente na ordem em que os vértices são descobertos:
- A BFS explora o grafo em camadas: primeiro o vértice de origem, depois todos os seus vizinhos diretos, depois os vizinhos dos vizinhos, e assim por diante. É natural usar uma estrutura de dados fila (FIFO) para guardar os vértices que ainda precisam ser processados.
- A DFS explora o grafo seguindo um caminho até o seu fim — isto é, até atingir um vértice cujos vizinhos já foram todos descobertos — e só então retrocede para explorar caminhos alternativos. A estrutura natural aqui é uma pilha (LIFO), seja ela explícita (versão iterativa) ou implícita por meio das chamadas recursivas (versão recursiva).
Este codelab apresenta ambos os algoritmos seguindo o estilo do CLRS (Cormen, Leiserson, Rivest, Stein. Introduction to Algorithms, 4ª edição. MIT Press, 2022): começamos pela ideia intuitiva, em seguida apresentamos o pseudocódigo, depois ilustramos passo a passo a execução em um grafo concreto, e por fim discutimos duas implementações em Java de cada algoritmo — uma iterativa e outra recursiva.
O que você vai aprender
- O esquema de cores (branco, cinza e preto) usado pelo CLRS
- Como a BFS calcula distâncias $d[v]$ e predecessores $\pi[v]$
- Como a DFS constrói a árvore de busca em profundidade
- A análise linha a linha que leva ao custo $\Theta(|V| + |E|)$
- Implementações iterativas e recursivas de BFS e DFS em Java
- Quando usar cada uma das buscas
O que você vai precisar
- Um JDK instalado (
javacejava) - Conhecimento de grafos, listas de adjacências, filas e pilhas
2. Esquema de cores e ideia da BFS
Esquema de cores para vértices
Tanto a BFS quanto a DFS, na formulação do CLRS, classificam os vértices em três estados ao longo da execução. Esses estados são tradicionalmente representados por cores:
| Cor | Significado |
|---|---|
| Branco | vértice ainda não descoberto. |
| Cinza | vértice descoberto, mas ainda em processamento. |
| Preto | vértice já processado (todos os seus vizinhos foram examinados). |
No início, todos os vértices são brancos. Ao serem descobertos, passam para cinza. Quando o algoritmo termina de processá-los, tornam-se pretos. Veremos que essa distinção em três cores é o que permite, por exemplo, evitar revisitas e detectar a estrutura da árvore de busca.
Busca em largura: ideia geral
Suponha que você esteja em uma cidade desconhecida e queira descobrir, a partir do ponto onde se encontra, quais bairros podem ser alcançados em 0, 1, 2, 3, ... deslocamentos — onde cada deslocamento significa atravessar uma única rua. A BFS é exatamente esse processo: ela visita primeiro o vértice de partida (distância 0), depois todos os vértices à distância 1, em seguida todos à distância 2, e assim por diante.
Como consequência, a BFS calcula, para cada vértice alcançável, o menor número de arestas entre ele e a origem. Em grafos não ponderados, esse valor coincide com a distância do vértice à origem. A BFS também constrói naturalmente uma árvore de busca em largura: para cada vértice $v$ descoberto, registra-se o vértice $u$ a partir do qual $v$ foi alcançado (denotado $\pi[v]$).
Aplicações da BFS
A busca em largura é a base de muitos algoritmos úteis:
- Caminho mínimo em grafos não ponderados. Encontrar o caminho com menor número de arestas entre dois vértices.
- Verificação de conectividade. Determinar se um grafo é conexo e quais são suas componentes conexas.
- Verificação de bipartição. Um grafo é bipartido se, e somente se, não contém ciclo de comprimento ímpar. A BFS pode colorir os vértices alternadamente nos níveis pares e ímpares e detectar uma violação.
- Redes sociais. Calcular o "grau de separação" entre duas pessoas em uma rede de amizades.
- Robótica e jogos. Encontrar a saída mais próxima em um labirinto modelado como grafo, onde cada célula é um vértice e células adjacentes são ligadas por arestas.
- Web crawling. Descobrir páginas web partindo de uma página inicial, expandindo nível a nível pelos hiperlinks.
- Captura em jogos de tabuleiro. Em jogos como Go, identificar grupos de pedras conectadas para verificar capturas.
3. Simulação passo a passo da BFS
Vamos simular a BFS sobre o grafo $G$ a seguir, partindo do vértice 1. Suponha que, para cada vértice, a lista de adjacências esteja em ordem crescente.
Grafo de entrada.
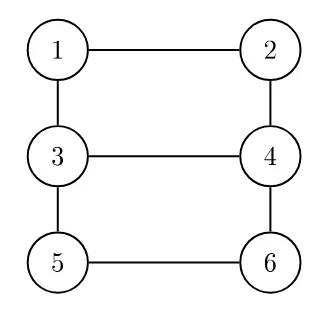
Grafo $G$ usado nas simulações.
Listas de adjacências:
$Adj[1] = (2, 3), \quad Adj[2] = (1, 4), \quad Adj[3] = (1, 4, 5),$
$Adj[4] = (2, 3, 6), \quad Adj[5] = (3, 6), \quad Adj[6] = (4, 5).$
Como ler cada passo. Cada passo apresenta:
- o vértice $u$ acabou de ser desenfileirado (ou, no passo inicial, o vértice de origem);
- o estado das cores e dos valores $d[v]$ (distância) e $\pi[v]$ (predecessor) de cada vértice;
- o conteúdo atual da fila $Q$ ao final do passo.
Passo 0 — Inicialização. Marcamos o vértice 1 como cinza, com $d[1] = 0$ e $\pi[1] = \textit{nulo}$. Os demais começam brancos com $d[v] = \infty$ e $\pi[v] = \textit{nulo}$. Enfileiramos o vértice 1.
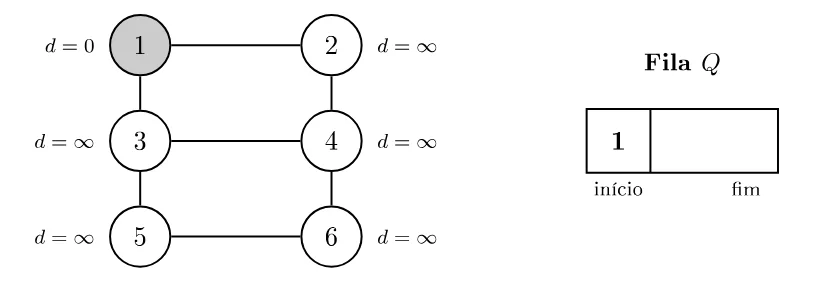
Passo 0: fila $Q = [1]$.
Passo 1 — Processa $u = 1$. Desenfileiramos 1. Examinamos seus vizinhos: 2 (branco) e 3 (branco). Ambos são descobertos: ficam cinzas, recebem $d = 1$ e $\pi = 1$, e entram na fila. Em seguida, 1 fica preto.
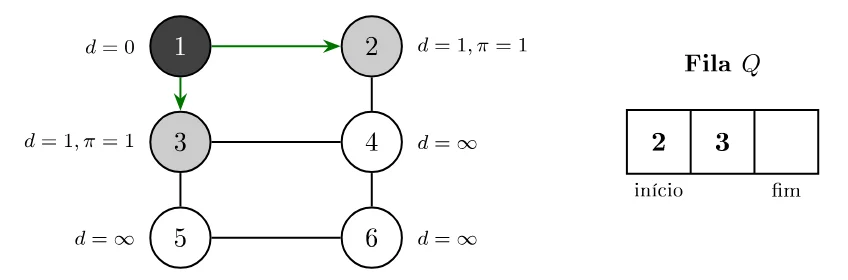
Passo 1: fila $Q = [2, 3]$.
Passo 2 — Processa $u = 2$. Desenfileiramos 2. Examinamos seus vizinhos: 1 (preto, ignora) e 4 (branco). 4 é descoberto: cinza, $d = 2$, $\pi = 2$, entra na fila. 2 fica preto.
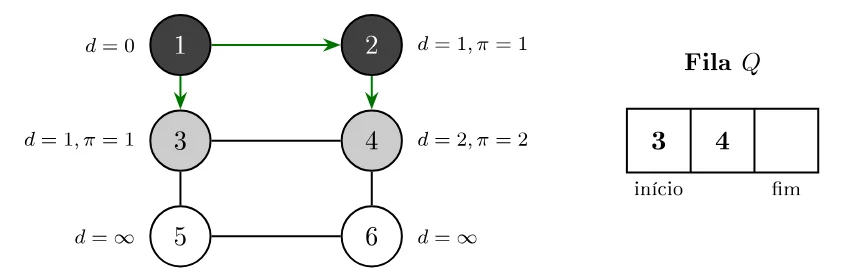
Passo 2: fila $Q = [3, 4]$.
Passo 3 — Processa $u = 3$. Desenfileiramos 3. Examinamos seus vizinhos: 1 (preto, ignora), 4 (cinza, ignora) e 5 (branco). 5 é descoberto: cinza, $d = 2$, $\pi = 3$, entra na fila. 3 fica preto.
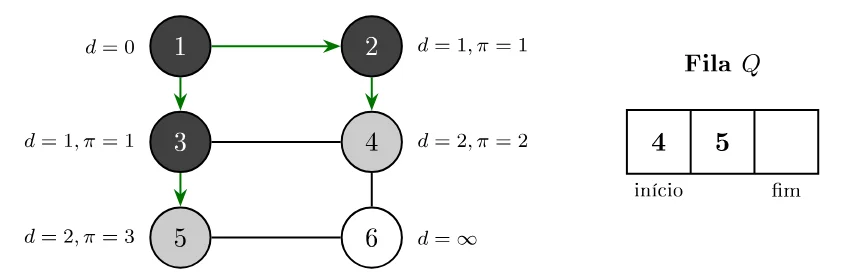
Passo 3: fila $Q = [4, 5]$.
Passo 4 — Processa $u = 4$. Desenfileiramos 4. Examinamos seus vizinhos: 2 (preto), 3 (preto) e 6 (branco). 6 é descoberto: cinza, $d = 3$, $\pi = 4$, entra na fila. 4 fica preto.
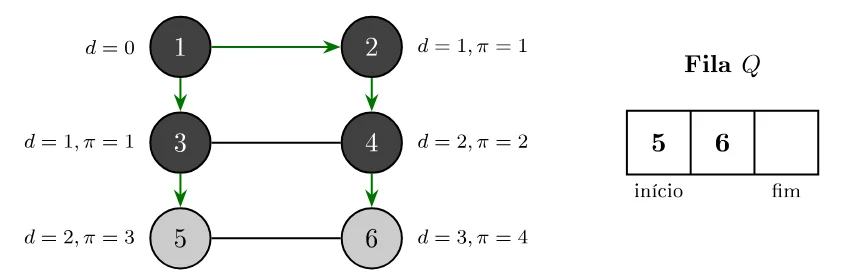
Passo 4: fila $Q = [5, 6]$.
Passo 5 — Processa $u = 5$. Desenfileiramos 5. Seus vizinhos são 3 (preto) e 6 (cinza). Nenhum é branco — ninguém novo entra na fila. 5 fica preto.
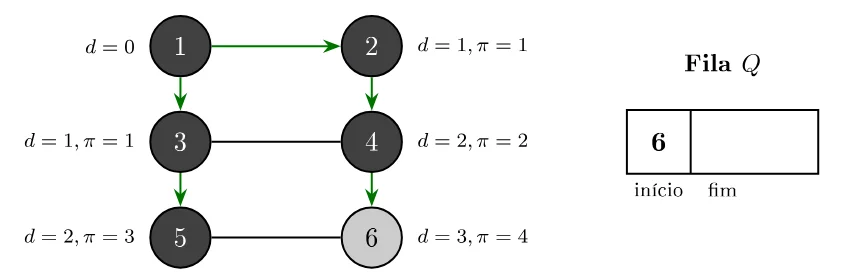
Passo 5: fila $Q = [6]$.
Passo 6 — Processa $u = 6$ (último). Desenfileiramos 6. Seus vizinhos 4 e 5 são pretos. 6 fica preto. A fila está vazia: a BFS termina.
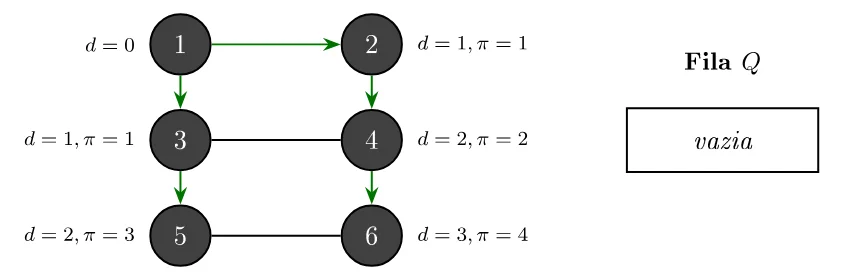
Passo 6: fila vazia, fim da BFS.
Resultado. As arestas verdes desenhadas formam a árvore de busca em largura enraizada em 1. As distâncias $d[v]$ correspondem exatamente ao número de arestas no caminho mais curto de 1 até $v$ no grafo original.
| $v$ | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| $d[v]$ | 0 | 1 | 1 | 2 | 2 | 3 |
| $\pi[v]$ | — | 1 | 1 | 2 | 3 | 4 |
4. Pseudocódigo e análise da BFS
O algoritmo abaixo recebe um grafo $G$ e um vértice de origem $s \in V(G)$. Ao final, para cada vértice $v$ alcançável a partir de $s$, $d[v]$ contém a distância (em arestas) de $s$ a $v$, e $\pi[v]$ contém o predecessor de $v$ na árvore de busca em largura.
Algoritmo 1: BFS(G, s)
 1  para cada u ∈ V(G) \ {s} faça
 2      cor[u] ← branco
 3      d[u] ← ∞
 4      π[u] ← nulo
 5  fim
 6  cor[s] ← cinza
 7  d[s] ← 0
 8  π[s] ← nulo
 9  Q ← ∅                               // fila vazia
10  ENFILEIRA(Q, s)
11  enquanto Q ≠ ∅ faça
12      u ← DESENFILEIRA(Q)
13      para cada v ∈ Adj[u] faça
14          se cor[v] = branco então
15              cor[v] ← cinza
16              d[v] ← d[u] + 1
17              π[v] ← u
18              ENFILEIRA(Q, v)
19          fim
20      fim
21      cor[u] ← preto
22  fim
Análise de complexidade linha a linha
A tabela abaixo dá o custo total acumulado de cada linha em uma execução completa da BFS. Linhas estruturais (fim de bloco) não contribuem para o tempo e estão marcadas com —. A análise assume que o grafo é representado por listas de adjacências.
| Linha | Pseudocódigo | Custo total |
|---|---|---|
| 1 | para cada $u \in V(G) \setminus {s}$ faça (teste) | $\Theta(\lvert V \rvert)$ |
| 2 | $cor[u] \leftarrow$ branco | $\Theta(\lvert V \rvert)$ |
| 3 | $d[u] \leftarrow \infty$ | $\Theta(\lvert V \rvert)$ |
| 4 | $\pi[u] \leftarrow$ nulo | $\Theta(\lvert V \rvert)$ |
| 5 | fim | — |
| 6 | $cor[s] \leftarrow$ cinza | $\Theta(1)$ |
| 7 | $d[s] \leftarrow 0$ | $\Theta(1)$ |
| 8 | $\pi[s] \leftarrow$ nulo | $\Theta(1)$ |
| 9 | $Q \leftarrow \emptyset$ (cria fila vazia) | $\Theta(1)$ |
| 10 | ENFILEIRA$(Q, s)$ | $\Theta(1)$ |
| 11 | enquanto $Q \neq \emptyset$ faça (teste, $\lvert V \rvert + 1$ vezes) | $\Theta(\lvert V \rvert)$ |
| 12 | $u \leftarrow$ DESENFILEIRA$(Q)$ (cada vértice 1 vez) | $\Theta(\lvert V \rvert)$ |
| 13 | para cada $v \in Adj[u]$ faça (varredura agregada †) | $\Theta(\lvert V \rvert + \lvert E \rvert)$ |
| 14 | se $cor[v] =$ branco então | $\Theta(\lvert E \rvert)$ |
| 15 | $cor[v] \leftarrow$ cinza (descoberta, $\lvert V \rvert - 1$ vezes) | $\Theta(\lvert V \rvert)$ |
| 16 | $d[v] \leftarrow d[u] + 1$ | $\Theta(\lvert V \rvert)$ |
| 17 | $\pi[v] \leftarrow u$ | $\Theta(\lvert V \rvert)$ |
| 18 | ENFILEIRA$(Q, v)$ | $\Theta(\lvert V \rvert)$ |
| 19 | fim | — |
| 20 | fim | — |
| 21 | $cor[u] \leftarrow$ preto (cada vértice 1 vez) | $\Theta(\lvert V \rvert)$ |
| 22 | fim | — |
| Total | $\Theta(\lvert V \rvert + \lvert E \rvert)$ |
† O laço para cada da linha 13 é percorrido em todas as iterações do enquanto: cada vértice $u$ contribui com $|Adj[u]|$ iterações. Somando sobre todos os vértices, o número total de iterações é
$\sum_{u \in V} |Adj[u]| = 2|E|$
(cada aresta é contada nas duas extremidades), de onde sai o termo $\Theta(|E|)$. A constante de inicialização do laço em cada chamada contribui com $\Theta(|V|)$ adicional, totalizando $\Theta(|V| + |E|)$.
5. BFS em Java
Implementação iterativa (com fila)
A implementação direta do pseudocódigo usa uma Queue da biblioteca padrão do Java (uma LinkedList serve como fila FIFO eficiente).
BFSIterativa.java
import java.util.*;

public class BFSIterativa {

    // Lista de adjacencias: vizinhos[u] = lista de vizinhos de u
    private final List<List<Integer>> vizinhos;
    private final int n;

    public BFSIterativa(int n) {
        this.n = n;
        this.vizinhos = new ArrayList<>(n);
        for (int i = 0; i < n; i++) {
            vizinhos.add(new ArrayList<>());
        }
    }

    public void adicionarAresta(int u, int v) {
        vizinhos.get(u).add(v);
        vizinhos.get(v).add(u);
    }

    /**
     * Executa BFS a partir de s. Preenche os arrays d e pi.
     * Estados: 0 = branco, 1 = cinza, 2 = preto.
     */
    public void bfs(int s, int[] d, int[] pi) {
        int[] cor = new int[n];
        for (int u = 0; u < n; u++) {
            cor[u] = 0;
            d[u] = Integer.MAX_VALUE;
            pi[u] = -1;
        }
        cor[s] = 1;
        d[s] = 0;

        Queue<Integer> fila = new LinkedList<>();
        fila.add(s);

        while (!fila.isEmpty()) {
            int u = fila.poll();
            for (int v : vizinhos.get(u)) {
                if (cor[v] == 0) {
                    cor[v] = 1;
                    d[v] = d[u] + 1;
                    pi[v] = u;
                    fila.add(v);
                }
            }
            cor[u] = 2;
        }
    }

    public static void main(String[] args) {
        BFSIterativa g = new BFSIterativa(7); // indices 0..6, usamos 1..6
        g.adicionarAresta(1, 2);
        g.adicionarAresta(1, 3);
        g.adicionarAresta(2, 4);
        g.adicionarAresta(3, 4);
        g.adicionarAresta(3, 5);
        g.adicionarAresta(4, 6);
        g.adicionarAresta(5, 6);

        int[] d = new int[7];
        int[] pi = new int[7];
        g.bfs(1, d, pi);

        System.out.println("v    d[v]     pi[v]");
        for (int v = 1; v <= 6; v++) {
            System.out.printf("%d      %2d      %2d%n", v, d[v], pi[v]);
        }
    }
}
Saída
v    d[v]     pi[v]
1       0      -1
2       1       1
3       1       1
4       2       2
5       2       3
6       3       4
Implementação recursiva
A BFS não é, por natureza, um algoritmo recursivo — o uso natural da recursão (com a pilha de chamadas) leva à profundidade, não à largura. Mas é possível escrevê-la de forma recursiva delegando a fila como parâmetro, recursão de cauda processando um vértice por chamada.
BFSRecursiva.java
import java.util.*;

public class BFSRecursiva {

    private final List<List<Integer>> vizinhos;
    private final int n;

    public BFSRecursiva(int n) {
        this.n = n;
        this.vizinhos = new ArrayList<>(n);
        for (int i = 0; i < n; i++) {
            vizinhos.add(new ArrayList<>());
        }
    }

    public void adicionarAresta(int u, int v) {
        vizinhos.get(u).add(v);
        vizinhos.get(v).add(u);
    }

    /**
     * Inicializa as estruturas e dispara a recursao.
     */
    public void bfs(int s, int[] d, int[] pi) {
        int[] cor = new int[n];
        for (int u = 0; u < n; u++) {
            cor[u] = 0;
            d[u] = Integer.MAX_VALUE;
            pi[u] = -1;
        }
        cor[s] = 1;
        d[s] = 0;

        Queue<Integer> fila = new LinkedList<>();
        fila.add(s);

        bfsRec(fila, cor, d, pi);
    }

    /**
     * Cada chamada recursiva processa exatamente um vertice
     * (o que esta na frente da fila) e entao recorre.
     */
    private void bfsRec(Queue<Integer> fila, int[] cor, int[] d, int[] pi) {
        if (fila.isEmpty()) {
            return; // caso base: nada mais a processar
        }
        int u = fila.poll();
        for (int v : vizinhos.get(u)) {
            if (cor[v] == 0) {
                cor[v] = 1;
                d[v] = d[u] + 1;
                pi[v] = u;
                fila.add(v);
            }
        }
        cor[u] = 2;
        bfsRec(fila, cor, d, pi);
    }

    public static void main(String[] args) {
        BFSRecursiva g = new BFSRecursiva(7);
        g.adicionarAresta(1, 2);
        g.adicionarAresta(1, 3);
        g.adicionarAresta(2, 4);
        g.adicionarAresta(3, 4);
        g.adicionarAresta(3, 5);
        g.adicionarAresta(4, 6);
        g.adicionarAresta(5, 6);

        int[] d = new int[7];
        int[] pi = new int[7];
        g.bfs(1, d, pi);

        System.out.println("v    d[v]     pi[v]");
        for (int v = 1; v <= 6; v++) {
            System.out.printf("%d      %2d      %2d%n", v, d[v], pi[v]);
        }
    }
}
6. Ideia da DFS e simulação passo a passo
Busca em profundidade: ideia geral
Imagine que você está explorando um labirinto com uma lanterna na mão e um carretel de barbante. Ao entrar em um corredor, você desenrola barbante. Toda vez que chega em uma bifurcação, escolhe um corredor não explorado e segue em frente. Quando atinge um beco sem saída — ou um corredor onde todos os caminhos partindo dali já foram percorridos — você volta seguindo o barbante (backtracking) até a bifurcação anterior, e tenta um corredor diferente.
Esse é exatamente o comportamento da busca em profundidade: ela vai o mais fundo possível seguindo um caminho antes de retroceder. Em termos algorítmicos:
- Ao descobrir um vértice $u$, marcamos $u$ como cinza.
- Examinamos cada vizinho $v$ de $u$; se $v$ for branco, fazemos uma chamada recursiva para visitar $v$.
- Quando todos os vizinhos de $u$ tiverem sido examinados, marcamos $u$ como preto e voltamos ao chamador.
Diferente da BFS, a DFS não calcula distâncias mínimas em grafos não ponderados. Em compensação, ela produz informações estruturais muito ricas sobre o grafo — como tempos de descoberta e finalização, a árvore de busca em profundidade e a classificação de arestas — que são a base de muitos algoritmos clássicos.
Aplicações da DFS
A busca em profundidade é a base de algoritmos como:
- Detecção de ciclos. Encontrar ciclos em um grafo (orientado ou não).
- Ordenação topológica. Ordenar tarefas com dependências (DAGs).
- Componentes fortemente conexas em grafos orientados (algoritmo de Tarjan e algoritmo de Kosaraju).
- Pontes e pontos de articulação. Identificar arestas e vértices cuja remoção desconecta o grafo.
- Resolução de labirintos e quebra-cabeças. Explorar caminhos com retrocesso (backtracking).
- Análise sintática. Percorrer árvores de derivação em compiladores e interpretadores.
- Geração de labirintos. Algoritmos como o recursive backtracker criam labirintos via DFS aleatorizada.
- Travessia de árvores (pré-ordem, em-ordem e pós-ordem são casos particulares de DFS).
Simulação passo a passo da DFS
Vamos simular a DFS sobre o mesmo grafo da BFS, partindo do vértice 1. As listas de adjacências estão em ordem crescente.
Passo 0 — Inicialização. Todos os vértices brancos. Pilha de chamadas vazia. Chamamos DFS-VISITA(1).
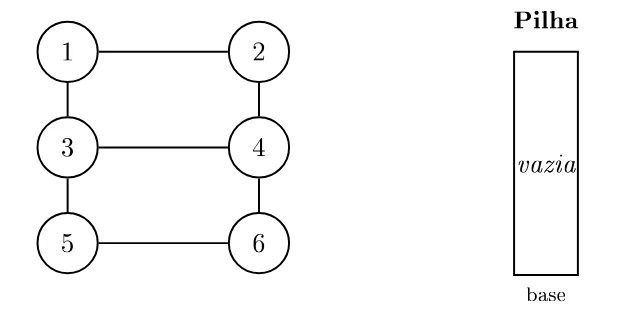
Passo 0: pilha vazia.
Passo 1 — DFS-VISITA(1). 1 vira cinza. Examina vizinhos em ordem: 2 é branco — chamamos DFS-VISITA(2).
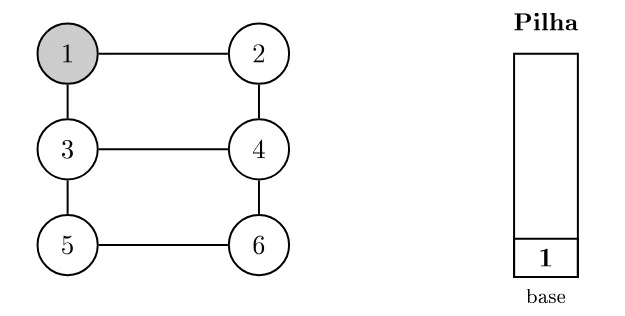
Passo 1: pilha $[1]$.
Passo 2 — DFS-VISITA(2). 2 vira cinza, $\pi[2] = 1$. Examina vizinhos: 1 (cinza, ignora), 4 (branco) — chamamos DFS-VISITA(4).
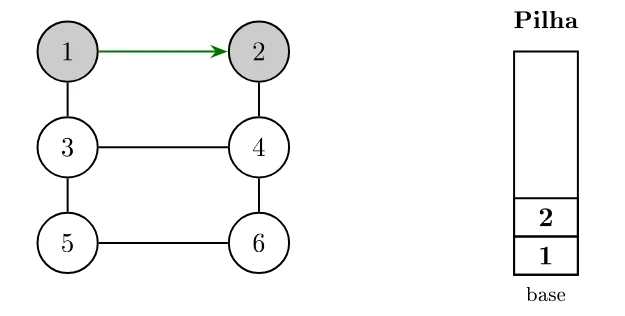
Passo 2: pilha $[1, 2]$.
Passo 3 — DFS-VISITA(4). 4 vira cinza, $\pi[4] = 2$. Examina vizinhos: 2 (cinza), 3 (branco) — chamamos DFS-VISITA(3).
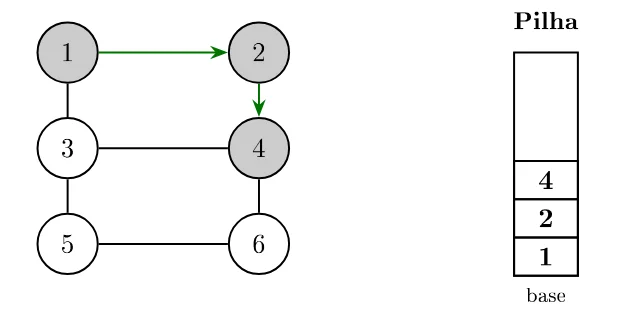
Passo 3: pilha $[1, 2, 4]$.
Passo 4 — DFS-VISITA(3). 3 vira cinza, $\pi[3] = 4$. Examina vizinhos: 1 (cinza), 4 (cinza), 5 (branco) — chamamos DFS-VISITA(5).
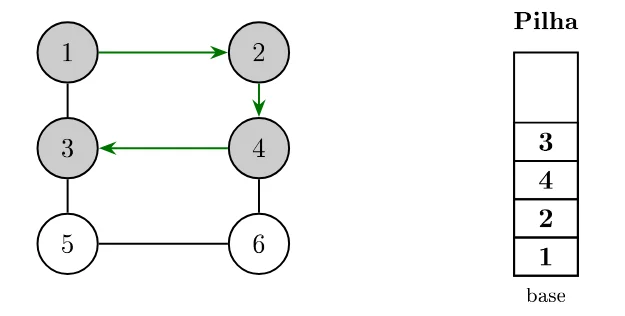
Passo 4: pilha $[1, 2, 4, 3]$.
Passo 5 — DFS-VISITA(5). 5 vira cinza, $\pi[5] = 3$. Examina vizinhos: 3 (cinza), 6 (branco) — chamamos DFS-VISITA(6).
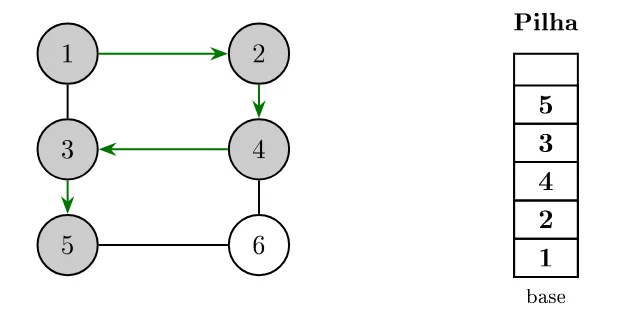
Passo 5: pilha $[1, 2, 4, 3, 5]$.
Passo 6 — DFS-VISITA(6). 6 vira cinza, $\pi[6] = 5$. Examina vizinhos: 4 (cinza), 5 (cinza). Nenhum branco. 6 fica preto e retornamos.
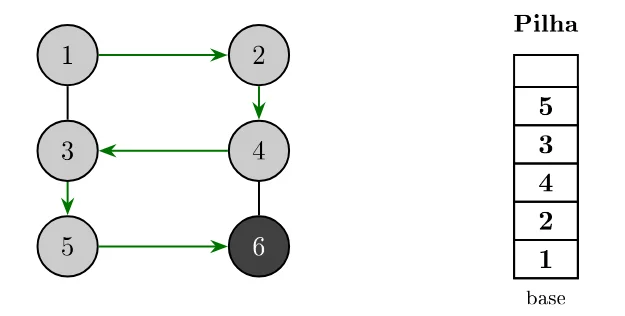
Passo 6: 6 termina e a chamada retorna.
Passo 7 — Retorno em cascata. Voltamos para 5: já examinou todos os vizinhos $\Rightarrow$ 5 preto, retorna. Voltamos para 3: já examinou todos $\Rightarrow$ 3 preto, retorna. Voltamos para 4: falta examinar 6 (já preto, ignora) $\Rightarrow$ 4 preto, retorna. Voltamos para 2: já examinou todos $\Rightarrow$ 2 preto, retorna. Voltamos para 1: falta examinar 3 (já preto, ignora) $\Rightarrow$ 1 preto.
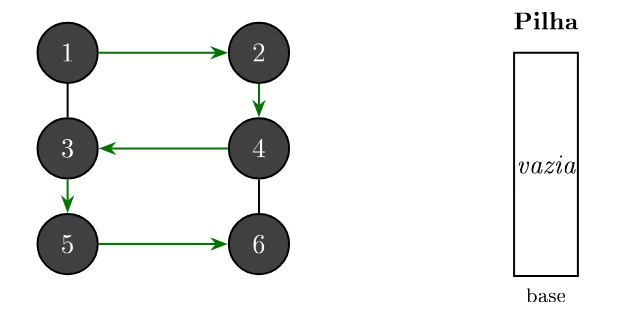
Passo 7: pilha vazia, fim da DFS.
Resultado. A árvore de busca em profundidade tem o formato de uma cadeia $1 \to 2 \to 4 \to 3 \to 5 \to 6$. Compare-a com a árvore da BFS, que tem o aspecto de uma árvore mais "larga". Esse contraste reflete fielmente a diferença filosófica entre os dois algoritmos.
| $v$ | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| $\pi[v]$ | — | 1 | 4 | 2 | 3 | 5 |
7. Pseudocódigo e análise da DFS
Apresentamos a versão recursiva clássica do CLRS. Ela percorre todos os vértices do grafo (não apenas os alcançáveis a partir de uma origem fixa), pois pode haver várias componentes conexas.
Algoritmo 2: DFS(G)
1  para cada u ∈ V(G) faça
2      cor[u] ← branco
3      π[u] ← nulo
4  fim
5  para cada u ∈ V(G) faça
6      se cor[u] = branco então
7          DFS-VISITA(G, u)
8      fim
9  fim
Algoritmo 3: DFS-VISITA(G, u)
1  cor[u] ← cinza                     // u foi descoberto
2  para cada v ∈ Adj[u] faça
3      se cor[v] = branco então
4          π[v] ← u
5          DFS-VISITA(G, v)
6      fim
7  fim
8  cor[u] ← preto                     // u está terminado
Análise de complexidade linha a linha
A análise abrange os dois algoritmos. O método DFS-VISITA é invocado exatamente uma vez para cada vértice (totalizando $|V|$ chamadas, somando todas as componentes conexas). Linhas estruturais estão marcadas com —. A análise assume listas de adjacências.
| Linha | Pseudocódigo | Custo total |
|---|---|---|
| Algoritmo 2 — DFS(G) (executado 1 vez) | ||
| 1 | para cada $u \in V(G)$ faça (teste) | $\Theta(\lvert V \rvert)$ |
| 2 | $cor[u] \leftarrow$ branco | $\Theta(\lvert V \rvert)$ |
| 3 | $\pi[u] \leftarrow$ nulo | $\Theta(\lvert V \rvert)$ |
| 4 | fim | — |
| 5 | para cada $u \in V(G)$ faça (teste) | $\Theta(\lvert V \rvert)$ |
| 6 | se $cor[u] =$ branco então | $\Theta(\lvert V \rvert)$ |
| 7 | DFS-VISITA$(G, u)$ (dispara recursão) | (ver abaixo) |
| 8 | fim | — |
| 9 | fim | — |
| Algoritmo 3 — DFS-VISITA(G, u) ($\lvert V \rvert$ chamadas, somando todas) | ||
| 1 | $cor[u] \leftarrow$ cinza (cada vértice 1 vez) | $\Theta(\lvert V \rvert)$ |
| 2 | para cada $v \in Adj[u]$ faça (varredura agregada †) | $\Theta(\lvert V \rvert + \lvert E \rvert)$ |
| 3 | se $cor[v] =$ branco então | $\Theta(\lvert E \rvert)$ |
| 4 | $\pi[v] \leftarrow u$ ($\lvert V \rvert - 1$ vezes) | $\Theta(\lvert V \rvert)$ |
| 5 | DFS-VISITA$(G, v)$ (cascata) | (recursão) |
| 6 | fim | — |
| 7 | fim | — |
| 8 | $cor[u] \leftarrow$ preto (cada vértice 1 vez) | $\Theta(\lvert V \rvert)$ |
| Total | $\Theta(\lvert V \rvert + \lvert E \rvert)$ |
† Cada chamada de DFS-VISITA$(G, u)$ percorre a lista $Adj[u]$. Como DFS-VISITA é invocada uma única vez por vértice e $\sum_{u \in V} |Adj[u]| = 2|E|$, o trabalho total da linha 2 somado sobre todas as chamadas é $\Theta(|V| + |E|)$ (o termo $\Theta(|V|)$ contabiliza a inicialização do laço em cada chamada).
8. DFS em Java
Implementação recursiva
A versão recursiva é a tradução direta do pseudocódigo: a pilha de chamadas faz, de forma transparente, o papel da pilha do algoritmo.
DFSRecursiva.java
import java.util.*;

public class DFSRecursiva {

    private final List<List<Integer>> vizinhos;
    private final int n;
    private int[] cor;
    private int[] pi;

    public DFSRecursiva(int n) {
        this.n = n;
        this.vizinhos = new ArrayList<>(n);
        for (int i = 0; i < n; i++) {
            vizinhos.add(new ArrayList<>());
        }
    }

    public void adicionarAresta(int u, int v) {
        vizinhos.get(u).add(v);
        vizinhos.get(v).add(u);
    }

    /**
     * Executa DFS a partir de s.
     * Estados: 0 = branco, 1 = cinza, 2 = preto.
     */
    public int[] dfs(int s) {
        cor = new int[n];
        pi = new int[n];
        for (int u = 0; u < n; u++) {
            cor[u] = 0;
            pi[u] = -1;
        }
        dfsVisita(s);
        return pi;
    }

    private void dfsVisita(int u) {
        cor[u] = 1;
        for (int v : vizinhos.get(u)) {
            if (cor[v] == 0) {
                pi[v] = u;
                dfsVisita(v);
            }
        }
        cor[u] = 2;
    }

    public static void main(String[] args) {
        DFSRecursiva g = new DFSRecursiva(7);
        g.adicionarAresta(1, 2);
        g.adicionarAresta(1, 3);
        g.adicionarAresta(2, 4);
        g.adicionarAresta(3, 4);
        g.adicionarAresta(3, 5);
        g.adicionarAresta(4, 6);
        g.adicionarAresta(5, 6);

        int[] pi = g.dfs(1);

        System.out.println("v     pi[v]");
        for (int v = 1; v <= 6; v++) {
            System.out.printf("%d      %2d%n", v, pi[v]);
        }
    }
}
Implementação iterativa (com pilha)
Para evitar o uso da pilha de chamadas (e o risco de StackOverflowError em grafos profundos), substituímos a recursão por uma pilha explícita (Deque<Integer>, com push e pop).
Um ponto sutil: para que a versão iterativa produza exatamente a mesma árvore que a versão recursiva, é preciso inserir os vizinhos na pilha em ordem inversa (pois a pilha é LIFO, o último a entrar é o primeiro a sair).
DFSIterativa.java
import java.util.*;

public class DFSIterativa {

    private final List<List<Integer>> vizinhos;
    private final int n;

    public DFSIterativa(int n) {
        this.n = n;
        this.vizinhos = new ArrayList<>(n);
        for (int i = 0; i < n; i++) {
            vizinhos.add(new ArrayList<>());
        }
    }

    public void adicionarAresta(int u, int v) {
        vizinhos.get(u).add(v);
        vizinhos.get(v).add(u);
    }

    /**
     * Executa DFS iterativa a partir de s usando pilha explicita.
     * Estados: 0 = branco, 1 = cinza, 2 = preto.
     */
    public int[] dfs(int s) {
        int[] cor = new int[n];
        int[] pi = new int[n];
        for (int u = 0; u < n; u++) {
            cor[u] = 0;
            pi[u] = -1;
        }

        Deque<Integer> pilha = new ArrayDeque<>();
        pilha.push(s);
        cor[s] = 1;

        while (!pilha.isEmpty()) {
            int u = pilha.peek();
            int proximoBranco = -1;

            // Procura o proximo vizinho branco de u
            for (int v : vizinhos.get(u)) {
                if (cor[v] == 0) {
                    proximoBranco = v;
                    break;
                }
            }

            if (proximoBranco != -1) {
                // Avanca: descobre o vizinho branco
                cor[proximoBranco] = 1;
                pi[proximoBranco] = u;
                pilha.push(proximoBranco);
            } else {
                // Backtrack: todos os vizinhos ja foram tratados
                cor[u] = 2;
                pilha.pop();
            }
        }
        return pi;
    }

    public static void main(String[] args) {
        DFSIterativa g = new DFSIterativa(7);
        g.adicionarAresta(1, 2);
        g.adicionarAresta(1, 3);
        g.adicionarAresta(2, 4);
        g.adicionarAresta(3, 4);
        g.adicionarAresta(3, 5);
        g.adicionarAresta(4, 6);
        g.adicionarAresta(5, 6);

        int[] pi = g.dfs(1);

        System.out.println("v     pi[v]");
        for (int v = 1; v <= 6; v++) {
            System.out.printf("%d      %2d%n", v, pi[v]);
        }
    }
}
9. Comparação BFS × DFS
Sintetizamos abaixo as principais diferenças entre os dois algoritmos.
| BFS | DFS | |
|---|---|---|
| Estrutura natural | Fila (FIFO) | Pilha (LIFO ou recursão) |
| Ordem de visita | Por camadas (níveis) | Em profundidade primeiro |
| Distâncias mínimas | Calcula em grafos não ponderados | Não |
| Árvore resultante | Tende a ser larga e rasa | Tende a ser estreita e profunda |
| Memória usada | Pode chegar a $\Theta(\lvert V \rvert)$ na fila (todos de um nível) | Profundidade máxima da recursão |
| Aplicações típicas | Caminho mínimo, componentes conexas, bipartição | Ciclos, ordenação topológica, componentes fortemente conexas, pontes, geração e resolução de labirintos |
| Tempo de execução | $\Theta(\lvert V \rvert + \lvert E \rvert)$ | $\Theta(\lvert V \rvert + \lvert E \rvert)$ |
Ambas têm a mesma complexidade assintótica de tempo — visitam cada vértice e cada aresta uma quantidade constante de vezes — e ambas são lineares em $|V| + |E|$. A escolha entre elas depende do problema:
- Se for preciso distância mínima (em arestas), use BFS.
- Se for preciso explorar caminhos um por vez, encontrar ciclos, fazer ordenação topológica, descobrir componentes fortemente conexas ou simular backtracking, use DFS.
10. Exercícios: busca em largura
Exercício teórico
Exercício 1 — Distância e predecessor na BFS
Considere o grafo não orientado $G$ a seguir, com 5 vértices:
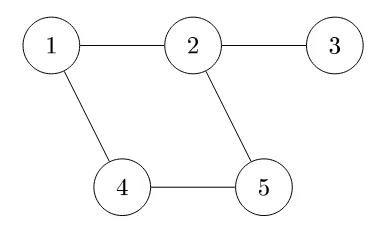
Grafo do exercício de BFS.
As listas de adjacências, em ordem crescente, são:
$Adj[1] = (2, 4), \quad Adj[2] = (1, 3, 5), \quad Adj[3] = (2),$
$Adj[4] = (1, 5), \quad Adj[5] = (2, 4).$
Suponha que executamos BFS$(G, 1)$, partindo do vértice 1.
Pede-se: preencha a tabela abaixo com os valores finais de $d[v]$ (distância em arestas até o vértice 1) e $\pi[v]$ (predecessor de $v$ na árvore de busca em largura).
| $v$ | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| $d[v]$ | |||||
| $\pi[v]$ |
Exercício prático
Exercício 2 — Contando vértices alcançáveis a partir de uma origem
Implemente em Java uma classe AlcancaveisBFS que, dado um grafo não orientado e um vértice de origem $s$, conta quantos vértices são alcançáveis a partir de $s$ (incluindo o próprio $s$) usando busca em largura.
Requisitos da implementação:
- O grafo deve ser representado por listas de adjacências, usando
List<List<Integer>>. - A classe deve oferecer:
- um construtor
AlcancaveisBFS(int n)que cria um grafo com $n$ vértices; - um método
adicionarAresta(int u, int v); - um método
int contarAlcancaveis(int s)que retorna o número de vértices alcançáveis a partir de $s$.
- um construtor
- Use uma
Queue<Integer>(pode serLinkedList) para a fila da BFS. - O método
maindeve testar a classe sobre um pequeno grafo de exemplo, imprimindo o número de vértices alcançáveis a partir de um vértice escolhido.
Saída esperada: uma linha no formato
Vertices alcancaveis a partir de <s>: <quantidade>
11. Exercícios: busca em profundidade
Exercício teórico
Exercício 1 — Ordem de descoberta e predecessores na DFS
Considere o grafo não orientado $G$ a seguir, com 5 vértices:
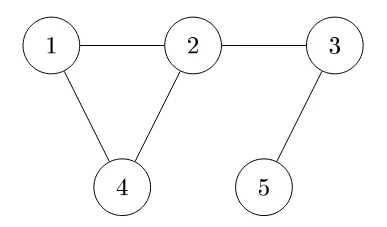
Grafo do exercício de DFS.
As listas de adjacências, em ordem crescente, são:
$Adj[1] = (2, 4), \quad Adj[2] = (1, 3, 4), \quad Adj[3] = (2, 5),$
$Adj[4] = (1, 2), \quad Adj[5] = (3).$
Suponha que executamos DFS-VISITA$(G, 1)$, partindo do vértice 1.
Pede-se:
(a) Apresente a sequência em que os vértices são descobertos (ou seja, a ordem em que cada vértice tem sua cor alterada de branco para cinza).
(b) Preencha a tabela abaixo com o valor de $\pi[v]$ (predecessor de $v$ na árvore de busca em profundidade).
| $v$ | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| $\pi[v]$ |
Exercício prático
Exercício 2 — Imprimindo os vértices visitados pela DFS
Implemente em Java uma classe ImprimeDFS que, dado um grafo não orientado e um vértice de origem $s$, imprima na tela todos os vértices visitados pela busca em profundidade a partir de $s$, na ordem em que são descobertos.
Requisitos da implementação:
- O grafo deve ser representado por listas de adjacências, usando
List<List<Integer>>. - A classe deve oferecer:
- um construtor
ImprimeDFS(int n)que cria um grafo com $n$ vértices; - um método
adicionarAresta(int u, int v); - um método
void dfs(int s)que executa a DFS recursiva a partir de $s$, imprimindo cada vértice no momento em que é descoberto.
- um construtor
- Implemente a DFS de forma recursiva, usando a pilha de chamadas implícita (não é preciso usar uma pilha explícita).
- O método
maindeve testar a classe sobre um pequeno grafo de exemplo, chamandodfsa partir de um vértice escolhido.
Saída esperada: cada vértice descoberto deve ser impresso em uma linha separada, no formato
Visitado: <v>
12. Exercícios extras: DFS e BFS pela linha de comando
Estes dois exercícios vêm de uma lista de 2025. Use a classe Grafo disponível no repositório a seguir como modelo: https://github.com/professorbossini/20251_maua_cic401.
DFS a partir do vértice 0
Implemente uma classe Java chamada Grafo que realiza uma busca em profundidade (DFS) a partir do vértice 0. O grafo é não direcionado e deve ser representado por lista de adjacências usando um vetor de LinkedList<Integer>. A entrada será fornecida via linha de comando (args), da seguinte forma:
- O primeiro valor representa o número de vértices do grafo.
- Os valores seguintes devem ser interpretados como pares de vértices conectados por uma aresta.
Exemplo de execução:
Terminal
java Grafo 6 0 1 0 2 1 3 2 4 4 5
Explicação da entrada:
6→ número de vértices (vértices de 0 a 5)0 1, 0 2, 1 3, 2 4, 4 5→ arestas entre os vértices
O programa deve realizar a DFS a partir do vértice 0 e imprimir a ordem dos vértices visitados.
Saída esperada:
DFS a partir do vértice 0:
0 1 3 2 4 5
Dica: utilize um vetor boolean[] visitado para controlar quais vértices já foram visitados durante a execução do algoritmo.
Distância mínima com BFS
Implemente uma classe Java chamada Grafo que realiza uma busca em largura (BFS) para encontrar a distância mínima (menor número de arestas) entre dois vértices. A entrada será fornecida via linha de comando (args), da seguinte forma:
- O primeiro valor representa o número de vértices do grafo.
- Os valores seguintes devem ser interpretados como pares de vértices conectados por uma aresta.
- Os dois últimos valores indicam o vértice de origem e o vértice de destino.
Exemplo de execução:
Terminal
java Grafo 6 0 1 0 3 1 5 2 5 3 4 4 5 0 5
Explicação da entrada:
6→ número de vértices (de 0 a 5)0 1, 0 3, 1 5, 2 5, 3 4, 4 5→ arestas0 5→ origem = 0, destino = 5
Nesse grafo, existem dois caminhos possíveis de 0 até 5:
0 → 1 → 5(2 arestas)0 → 3 → 4 → 5(3 arestas)
O algoritmo deve encontrar o caminho mais curto (com menos arestas).
Saída esperada:
Distância mínima de 0 até 5 é 2
13. Encerramento
Parabéns! Você estudou a busca em largura e a busca em profundidade no estilo CLRS, simulou as duas passo a passo, analisou seu custo $\Theta(|V| + |E|)$ e as implementou em Java nas versões iterativa e recursiva.
Referências
- CORMEN, Thomas H.; LEISERSON, Charles E.; RIVEST, Ronald L.; STEIN, Clifford. Introduction to Algorithms. 4ª edição. MIT Press, 2022. Capítulo 20: Elementary Graph Algorithms.
- BONDY, J. A.; MURTY, U. S. R. Graph Theory. Nova York: Springer, 2008. (Graduate Texts in Mathematics, v. 244).
- FEOFILOFF, Paulo. Algoritmos para Grafos. Disponível em: https://www.ime.usp.br/~pf/algoritmos_para_grafos/. Acesso em: 2026.