Algoritmos gulosos: seleção de intervalos
Conheça os algoritmos gulosos pelo problema da seleção de intervalos: veja por que três critérios intuitivos falham, por que o menor tempo de término funciona, analise a complexidade Θ(n log n) e implemente a solução em Java.
1. Visão geral
Neste codelab você estuda os algoritmos gulosos a partir de um problema clássico, a seleção de intervalos — maximizar o número de tarefas alocadas a um recurso compartilhado. O material é baseado em Kleinberg & Tardos, Algorithm Design.
O que você vai aprender
- O que é um algoritmo guloso
- Por que os critérios "menor tempo de início", "menor duração" e "menor número de conflitos" falham
- Por que o critério do menor tempo de término produz a solução ótima
- O pseudocódigo do algoritmo e sua análise de complexidade, $\Theta(n \log n)$
- Uma implementação em Java com
Arrays.sorteComparator
O que você vai precisar
- Um JDK instalado (
javacejava) - Conhecimento das notações $O$, $\Omega$ e $\Theta$ e de ordenação
2. O problema
Imagine que você administra uma sala de reuniões (ou um laboratório, uma máquina, um servidor — qualquer recurso compartilhado). Várias pessoas chegam pedindo para usar a sala, e cada pedido vem com um horário de início e um horário de término fixos. Duas reservas são compatíveis se não se sobrepõem no tempo. Você quer aceitar o maior número possível de pedidos. A pergunta é: como escolher quais aceitar?
Veja um exemplo concreto com sete pedidos:
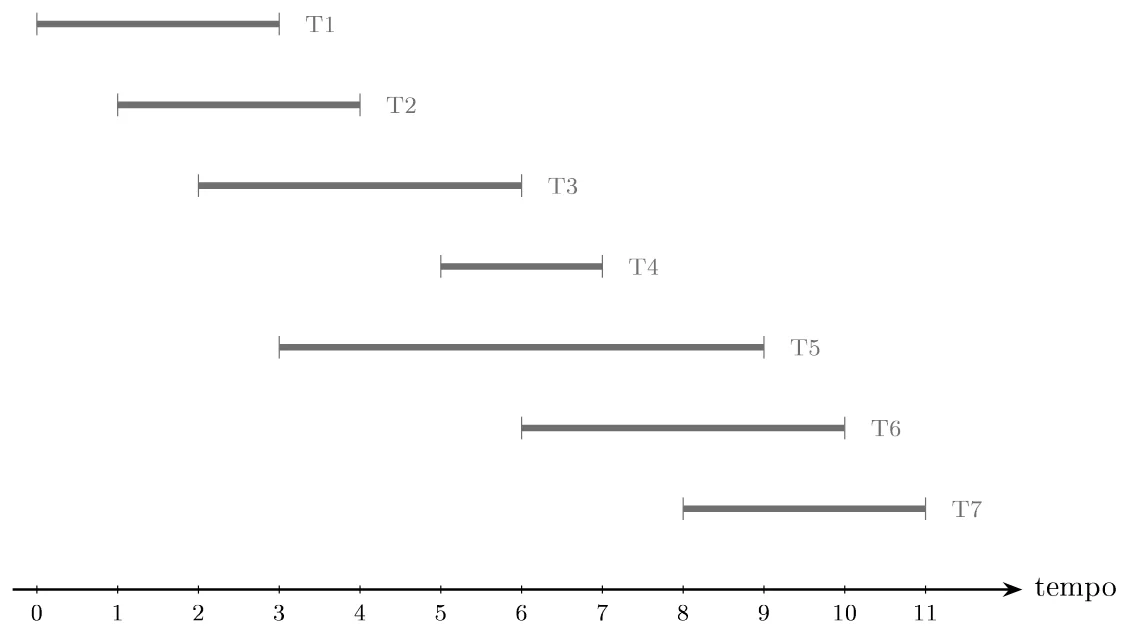
Figura 1: Sete pedidos de uso do recurso. Cada segmento horizontal é um pedido e o rótulo à direita é o seu identificador. Quais pedidos aceitar para atender o maior número possível?
Na instância da Figura 1, verifique de olho que dá para atender no máximo 3 pedidos compatíveis (por exemplo, ${T1, T4, T7}$). O problema parece simples quando se tem um desenho. Mas como um algoritmo decide isso automaticamente, para instâncias com milhares de tarefas?
Algoritmo guloso
Um algoritmo guloso (do inglês greedy algorithm) constrói uma solução em etapas, fazendo em cada passo a escolha que parece melhor segundo um critério local fixo, sem revisar decisões anteriores e sem olhar para o futuro. A esperança é que essa sequência de escolhas locais leve a uma solução globalmente ótima — o que nem sempre acontece.
O problema é que existem vários critérios gulosos plausíveis para o nosso problema — e a maioria deles não funciona. Vamos testar.
3. Critérios que falham
Critério 1: menor tempo de início (falha)
Uma primeira ideia: aceitar o pedido que começa mais cedo, descartar os que conflitam com ele, repetir. A intuição é "começar a usar o recurso o quanto antes". Parece razoável.
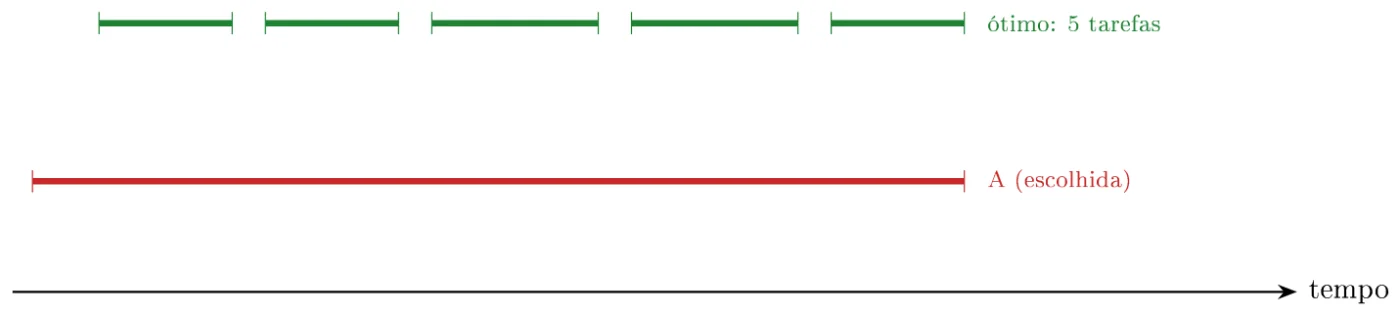
Figura 2: Critério 1 falha. A tarefa $A$, em vermelho, começa primeiro e é escolhida. Ao ser aceita, bloqueia todas as outras. Resultado: 1 tarefa. Em verde, a solução ótima, com 5 tarefas compatíveis. A diferença pode ser arbitrariamente grande — basta substituir 5 por qualquer número.
Por que falha. Uma única tarefa muito longa, se iniciar cedo, arrasta a solução gulosa para apenas 1 tarefa, enquanto a ótima pode ter qualquer quantidade. O critério é enganado por tarefas gigantes que começam cedo.
Critério 2: menor duração (falha)
Já que tarefas longas são perigosas, que tal escolher primeiro as mais curtas? A intuição agora é "consumir o mínimo de tempo do recurso em cada passo, deixando mais espaço para as próximas".
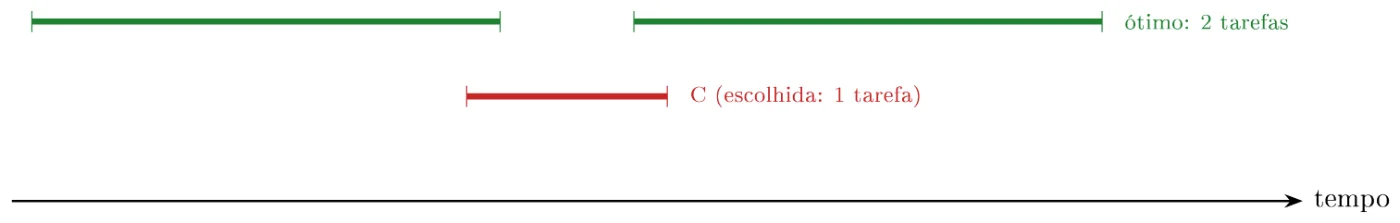
Figura 3: Critério 2 falha. A tarefa $C$, em vermelho, é a mais curta e é escolhida primeiro. Porém, ela conflita simultaneamente com as duas tarefas longas em verde, que seriam compatíveis entre si. Resultado guloso: 1 tarefa. Ótimo: 2 tarefas.
Por que falha. Uma tarefa curta pode estar posicionada bem no meio, conflitando com múltiplas tarefas longas que seriam mutuamente compatíveis. Escolher a curta destrói várias oportunidades de uma só vez. O critério é enganado por tarefas curtas mas mal posicionadas.
Critério 3: menor número de conflitos (falha)
Os dois critérios anteriores falharam por ignorar o contexto. Então que tal escolher, em cada passo, a tarefa que conflita com o menor número de outras tarefas remanescentes? Afinal, aceitar uma tarefa pouco conflituosa parece "eliminar" poucas alternativas.
Essa é a ideia mais sofisticada das três, mas ainda assim falha em instâncias cuidadosamente construídas. Kleinberg & Tardos apresentam uma construção na qual uma tarefa central tem o menor número de conflitos, mas escolhê-la bloqueia justamente as tarefas que compõem a solução ótima.
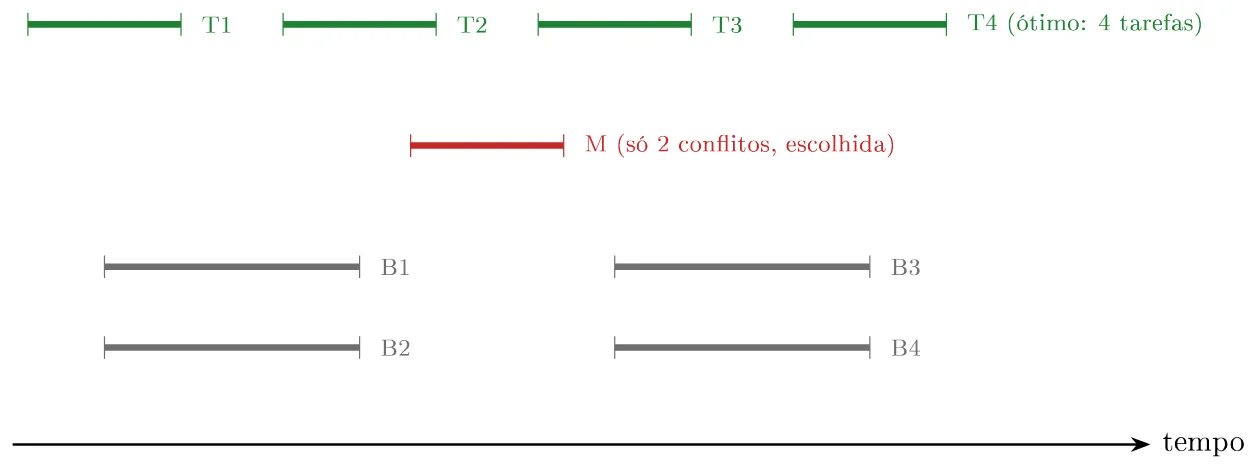
Figura 4: Critério 3 falha. A tarefa $M$ (vermelho) conflita com apenas 2 outras ($T2$ e $T3$). Cada $T_i$ verde, por sua vez, conflita com $M$ e com dois blocos cinzas ($B1 \ldots B4$), totalizando 3 conflitos. $M$ é, portanto, a tarefa com menor grau de conflito e é escolhida primeiro — eliminando $T2$ e $T3$. O guloso termina com 3 tarefas (por exemplo ${T1, M, T4}$). Em verde, a solução ótima ${T1, T2, T3, T4}$, com 4 tarefas.
Por que falha. Minimizar conflitos é uma métrica puramente local: olha apenas para quantos vizinhos a tarefa tem no "grafo de conflitos". Ela pode favorecer tarefas que, apesar de terem poucas conexões, estão exatamente sobre o caminho que a solução ótima precisaria usar.
4. Critério 4: menor tempo de término
Depois de três fracassos, a estratégia correta é surpreendentemente simples:
Em cada passo, escolha a tarefa compatível com as já selecionadas que tenha o menor tempo de término.
A intuição agora é outra: ao terminar o mais cedo possível, deixamos o máximo de tempo livre à frente para as próximas tarefas. Note que esse critério é diferente de "tarefa mais curta": uma tarefa pode terminar cedo sem ser curta — basta começar cedo também.
A Figura 5 mostra o algoritmo em ação. As tarefas estão desenhadas já na ordem em que o algoritmo as processa (crescente de tempo de término).
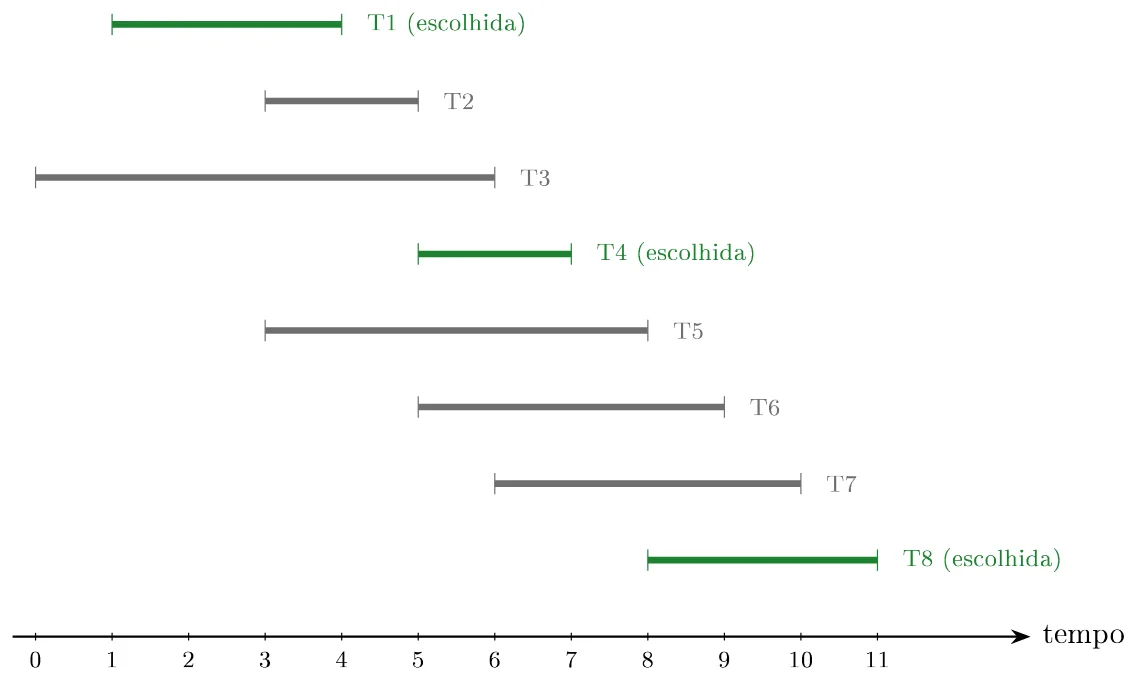
Figura 5: Critério 4 funciona. As tarefas estão ordenadas por tempo de término crescente. O algoritmo escolhe $T1$ (termina em 4); $T2$ e $T3$ conflitam com $T1$ e são descartadas; $T4$ é compatível ($5 \geq 4$) e é escolhida; $T5$, $T6$ e $T7$ conflitam com $T4$; finalmente $T8$ é compatível ($8 \geq 7$) e é escolhida. Saída: ${T1, T4, T8}$, 3 tarefas — ótimo para esta instância.
5. O algoritmo e sua complexidade
O pseudocódigo abaixo implementa a estratégia vencedora. Depois de ordenar por tempo de término, uma única passagem linear é suficiente: basta lembrar o tempo de término da última tarefa aceita e comparar com o início da próxima candidata.
Algoritmo 1: SELEÇÃO-INTERVALOS(R)
Entrada: Conjunto R = {1, ..., n} de tarefas com tempos (s_i, f_i)
Saída:   Subconjunto A ⊆ R compatível de tamanho máximo

 1  Ordene as tarefas de R de forma que f_1 ≤ f_2 ≤ ... ≤ f_n;
 2  A ← ∅;
 3  ultimoFim ← -∞;
 4  para i ← 1 até n faça
 5      se s_i ≥ ultimoFim então
 6          A ← A ∪ {i};
 7          ultimoFim ← f_i;
 8      fim
 9  fim
10  retorne A;
Análise de complexidade
Analisamos o tempo de execução atribuindo um custo a cada linha do pseudocódigo e contando quantas vezes cada uma é executada. O número de tarefas é $n$.
| Linha | Operação | Custo unitário | Vezes |
|---|---|---|---|
| 1 | Ordenar por tempo de término | $\Theta(n \log n)$ | $1$ |
| 2 | $A \leftarrow \emptyset$ | $\Theta(1)$ | $1$ |
| 3 | $ultimoFim \leftarrow -\infty$ | $\Theta(1)$ | $1$ |
| 4 | para $i \leftarrow 1$ até $n$ | $\Theta(1)$ | $n + 1$ |
| 5 | se $s_i \geq ultimoFim$ | $\Theta(1)$ | $n$ |
| 6 | $A \leftarrow A \cup {i}$ | $\Theta(1)$ | $\leq n$ |
| 7 | $ultimoFim \leftarrow f_i$ | $\Theta(1)$ | $\leq n$ |
| 8 | retorne $A$ | $\Theta(1)$ | $1$ |
Somando as contribuições:
$T(n) = \underbrace{\Theta(n \log n)}{\text{linha 1 (ordenação)}} + \underbrace{\Theta(n)}{\text{laço das linhas 4–7}} + \underbrace{\Theta(1)}_{\text{inicializações e retorno}} = \Theta(n \log n).$
O custo é dominado pela ordenação inicial. O laço principal percorre cada tarefa exatamente uma vez fazendo trabalho constante, contribuindo apenas com $\Theta(n)$. Portanto:
$T(n) = \Theta(n \log n)$
Qualquer algoritmo correto precisa, no mínimo, examinar todas as $n$ tarefas, o que dá um limite inferior de $\Omega(n)$. O $\Theta(n \log n)$ obtido está, portanto, muito próximo do mínimo possível — na prática, o custo do algoritmo é essencialmente o custo de uma ordenação.
6. Implementação em Java
A implementação segue fielmente o pseudocódigo. Representamos cada tarefa por uma classe Tarefa e usamos Arrays.sort com um Comparator para ordenar por tempo de término.
A instância usada no método main é exatamente a que aparece na Figura 6 abaixo: oito tarefas com intervalos $[s_i, f_i)$. Note que elas estão listadas no código na mesma ordem (crescente de tempo de término), como seriam encontradas após a ordenação.
![Oito tarefas T1 [1, 4), T2 [3, 5), T3 [0, 6), T4 [5, 7), T5 [3, 8), T6 [5, 9), T7 [6, 10) e T8 8, 11) desenhadas sobre um eixo de tempo de 0 a 11
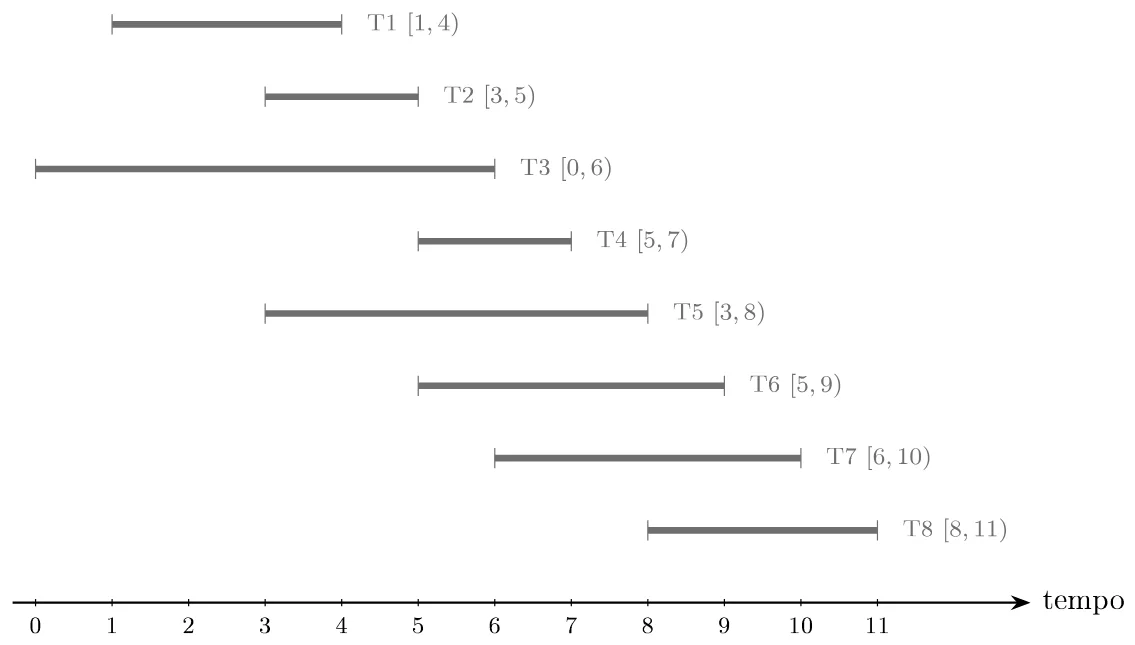
Figura 6: Instância de entrada usada no método main do código Java. Oito tarefas numeradas de $T1$ a $T8$ com os respectivos intervalos.
SelecaoIntervalos.java
import java.util.Arrays;
import java.util.ArrayList;
import java.util.List;
import java.util.Comparator;

public class SelecaoIntervalos {

    // Representa uma tarefa com identificador e intervalo [inicio, fim)
    static class Tarefa {
        int id;
        int inicio;
        int fim;

        Tarefa(int id, int inicio, int fim) {
            this.id = id;
            this.inicio = inicio;
            this.fim = fim;
        }

        @Override
        public String toString() {
            return "T" + id + "[" + inicio + "," + fim + ")";
        }
    }

    /**
     * Retorna um subconjunto compativel de tamanho maximo
     * usando a estrategia gulosa do menor tempo de termino.
     */
    public static List<Tarefa> selecionar(Tarefa[] tarefas) {
        // Passo 1: ordenar por tempo de termino crescente - O(n log n)
        Arrays.sort(tarefas, Comparator.comparingInt(t -> t.fim));

        // Passo 2: percorrer e aceitar compativeis - O(n)
        List<Tarefa> selecionadas = new ArrayList<>();
        int ultimoFim = Integer.MIN_VALUE;

        for (Tarefa t : tarefas) {
            if (t.inicio >= ultimoFim) {
                selecionadas.add(t);
                ultimoFim = t.fim;
            }
        }
        return selecionadas;
    }

    public static void main(String[] args) {
        Tarefa[] tarefas = {
            new Tarefa(1, 1, 4),
            new Tarefa(2, 3, 5),
            new Tarefa(3, 0, 6),
            new Tarefa(4, 5, 7),
            new Tarefa(5, 3, 8),
            new Tarefa(6, 5, 9),
            new Tarefa(7, 6, 10),
            new Tarefa(8, 8, 11)
        };

        System.out.println("Entrada:");
        for (Tarefa t : tarefas) {
            System.out.println("  " + t);
        }

        List<Tarefa> resultado = selecionar(tarefas);
        int k = resultado.size();

        System.out.println("\nSelecionadas: " + k);
        for (Tarefa t : resultado) {
            System.out.println("  " + t);
        }
    }
}
Saída esperada:
Entrada:
  T1[1,4)
  T2[3,5)
  T3[0,6)
  T4[5,7)
  T5[3,8)
  T6[5,9)
  T7[6,10)
  T8[8,11)

Selecionadas: 3
  T1[1,4)
  T4[5,7)
  T8[8,11)
A saída corresponde exatamente às tarefas destacadas em verde na Figura 5.
7. Exercícios: seleção de intervalos
Instruções gerais. Todos os exercícios envolvem o problema da seleção de intervalos: dado um conjunto de tarefas, cada uma com tempo de início $s_i$ e tempo de término $f_i$ ($s_i < f_i$), selecionar o maior subconjunto possível de tarefas mutuamente compatíveis (que não se sobrepõem no tempo). A estratégia gulosa correta, vista neste codelab, é processar as tarefas em ordem crescente de tempo de término, aceitando cada tarefa cujo início seja maior ou igual ao fim da última tarefa aceita.
Exercício 1 — Execução passo a passo (com desenho)
Considere a instância com sete tarefas a seguir, definida pelos intervalos:
| Tarefa | Início $s_i$ | Fim $f_i$ |
|---|---|---|
| T1 | 1 | 5 |
| T2 | 2 | 4 |
| T3 | 4 | 7 |
| T4 | 6 | 9 |
| T5 | 3 | 11 |
| T6 | 8 | 12 |
| T7 | 11 | 14 |
A figura abaixo mostra a representação visual dessas tarefas no eixo do tempo:
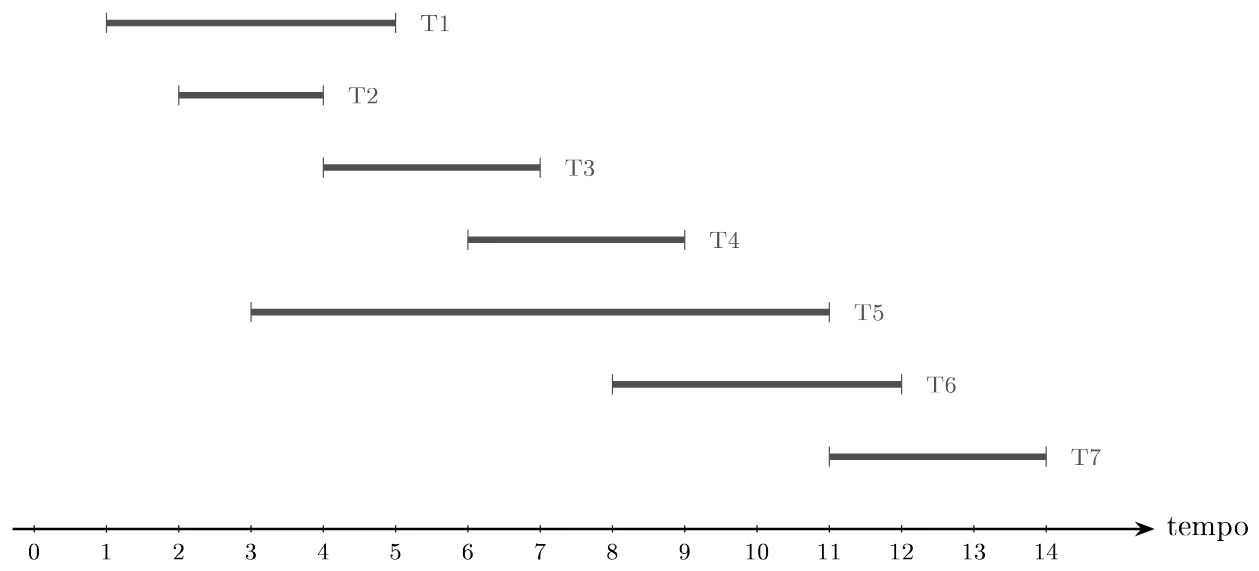
Instância do Exercício 1.
Tarefas:
(a) Liste as tarefas em ordem crescente de tempo de término.
(b) Execute o algoritmo guloso de seleção de intervalos passo a passo, indicando, em cada iteração: a tarefa corrente, o valor atual da variável ultimoFim, se a tarefa é aceita ou rejeitada e a justificativa (qual comparação foi feita).
(c) Indique o conjunto $A$ de tarefas selecionadas e o tamanho $|A|$.
(d) Desenhe (à mão livre, em papel quadriculado, ou usando uma ferramenta de sua escolha) um eixo do tempo idêntico ao da figura acima, em que apenas as tarefas selecionadas pelo algoritmo apareçam destacadas (por exemplo, em outra cor ou em traço mais grosso). As demais devem ser apagadas ou desenhadas em traço fino e cinza, para deixar visualmente claro o resultado.
Exercício 2 — Análise de uma estratégia alternativa
Suponha que, em vez de escolher a tarefa com menor tempo de término, um colega proponha a seguinte estratégia gulosa:
"Em cada passo, escolha a tarefa compatível com as já selecionadas que tenha o maior tempo de início."
A intuição do colega é a seguinte: ao escolher a tarefa que começa o mais tarde possível, deixamos a maior quantidade de tempo livre antes dela, o que (segundo o colega) aumentaria a chance de encaixar muitas outras tarefas naquele espaço.
Tarefas:
(a) Descreva, em pseudocódigo ou em linguagem natural, como esse novo algoritmo funcionaria. Em particular, indique como as tarefas precisariam ser ordenadas inicialmente e como o algoritmo decide se uma tarefa pode ou não ser aceita, considerando que ele constrói a solução de trás para frente (das tarefas mais tardias para as mais iniciais).
(b) Aplique esse algoritmo à instância do Exercício 1 e mostre, passo a passo, qual conjunto de tarefas ele produz.
(c) Compare o tamanho da solução produzida por esse novo algoritmo com o tamanho da solução produzida pelo algoritmo do menor tempo de término (do Exercício 1). Eles têm o mesmo tamanho? Em caso afirmativo, isso significa que a estratégia do colega também é ótima? Justifique sua resposta com uma breve discussão (sem precisar provar formalmente nada).
(d) Qual é a complexidade assintótica do algoritmo do colega? Use notação $\Theta$ e justifique brevemente.
Exercício 3 — Implementação a partir de arquivo
Implemente em Java uma classe SelecaoIntervalosArquivo que resolva o problema da seleção de intervalos a partir de uma entrada lida de um arquivo de texto.
Formato do arquivo de entrada. A primeira linha contém um inteiro $n$ ($1 \leq n \leq 10,000$), o número de tarefas. As $n$ linhas seguintes contêm, cada uma, três valores inteiros separados por espaço: o identificador da tarefa, o tempo de início $s_i$ e o tempo de término $f_i$ (com $0 \leq s_i < f_i \leq 100,000$). Exemplo:
5
1 1 4
2 3 5
3 0 6
4 5 7
5 8 11
Requisitos. O programa deve:
(a) Receber, como argumento de linha de comando, o caminho do arquivo de entrada.
(b) Ler o arquivo, validando que cada tarefa atende a $s_i < f_i$ (caso contrário, exibir uma mensagem de erro e encerrar).
(c) Aplicar o algoritmo guloso de seleção de intervalos (estratégia do menor tempo de término).
(d) Imprimir, na saída padrão: a quantidade de tarefas selecionadas e, em seguida, uma linha por tarefa selecionada, no formato id si fi, em ordem crescente de tempo de término.
Restrições adicionais. Você deve definir uma classe Tarefa com os atributos id, inicio e fim. A ordenação deve ser feita usando Arrays.sort com um Comparator (lambda ou método). Não use estruturas prontas de ordenação por inserção, busca em árvore ou similares: o foco é deixar claro o uso do paradigma guloso. Sua entrega deve incluir o código-fonte completo da classe.
8. Exercício extra: mochila fracionária
Este exercício vem de uma lista de 2025 e trata de outro problema clássico resolvido por um algoritmo guloso.
Problema da mochila fracionária
Você é um aventureiro explorando uma caverna. Ao final da expedição, encontra vários itens de valor, cada um com um peso e um valor associado. Porém, sua mochila só suporta uma quantidade limitada de peso. Felizmente, você pode fracionar os itens, levando apenas uma parte do item e, proporcionalmente, o valor associado.
O objetivo é escolher frações dos itens de modo que o valor total carregado na mochila seja o maior possível sem ultrapassar o limite de peso.
Entrada
- Um número inteiro $n$ representando a quantidade de itens.
- Um número real $W$ representando a capacidade máxima da mochila.
- Em seguida, $n$ linhas com dois números reais cada: valor e peso de cada item.
Saída
- Um número real com duas casas decimais, representando o valor total máximo que pode ser carregado na mochila.
Exemplo de entrada
3
50
60
10
100
20
120
30
Exemplo de saída
240.00
Explicação: 10 unidades do primeiro item, totalizando 60 + 20 unidades do segundo item, totalizando 100 + 20 unidades do item 3, totalizando 80.
Dicas
Comece calculando o valor unitário de cada item. Por exemplo:
- Item 1: $60 / 10 = 6$
- Item 2: $100 / 20 = 5$
- Item 3: $120 / 30 = 4$
A partir daí, encontre um critério para escolher cada item de forma gulosa.
Qual a complexidade computacional de seu algoritmo? Explique.
9. Encerramento
Parabéns! Você viu que nem todo critério guloso intuitivo funciona, entendeu por que o menor tempo de término leva à solução ótima da seleção de intervalos, analisou o algoritmo ($\Theta(n \log n)$, dominado pela ordenação) e o implementou em Java.
Referências
- KLEINBERG, Jon; TARDOS, Éva. Algorithm Design. Pearson, 2005. Capítulo 4: Greedy Algorithms, Seção 4.1: Interval Scheduling.
- CORMEN, Thomas H.; LEISERSON, Charles E.; RIVEST, Ronald L.; STEIN, Clifford. Introduction to Algorithms. 4ª edição. MIT Press, 2022. Capítulo 15: Greedy Algorithms.
- FEOFILOFF, Paulo. Anotações sobre Algoritmos: Slides. São Paulo: Instituto de Matemática e Estatística – USP, [s.d.]. Disponível em: https://www.ime.usp.br/~pf/livrinho-AA/downloads/AA-SLIDES.pdf. Acesso em: março de 2025.